Controllo qualità per l'annotazione in crowdsourcing
Combina verifiche di attenzione, gold standard, sovrapposizione tra annotatori e dati sui tempi per individuare le annotazioni di bassa qualità, con le chiavi di configurazione di Potato per ciascuno e ciò che riportano.
Nessuna verifica da sola intercetta ogni tipo di annotazione scadente, quindi conviene sovrapporne quattro: verifiche di attenzione per gli annotatori che non leggono, gold standard per quelli che leggono e sbagliano comunque, sovrapposizione per gli elementi ambigui e tempi per il lavoro consegnato troppo in fretta per essere stato fatto davvero. Ognuna ha la propria chiave di configurazione in Potato, e ognuna riporta separatamente nella dashboard di amministrazione.
Il controllo qualità costa meno prima della raccolta e più dopo. Una verifica di attenzione che blocca un annotatore al quinto errore non costa nulla da configurare e risparmia gli elementi che avrebbe compilato; lo stesso problema trovato con uno script a posteriori ti costa una nuova raccolta. I controlli che seguono sono ordinati in base a quando intervengono.
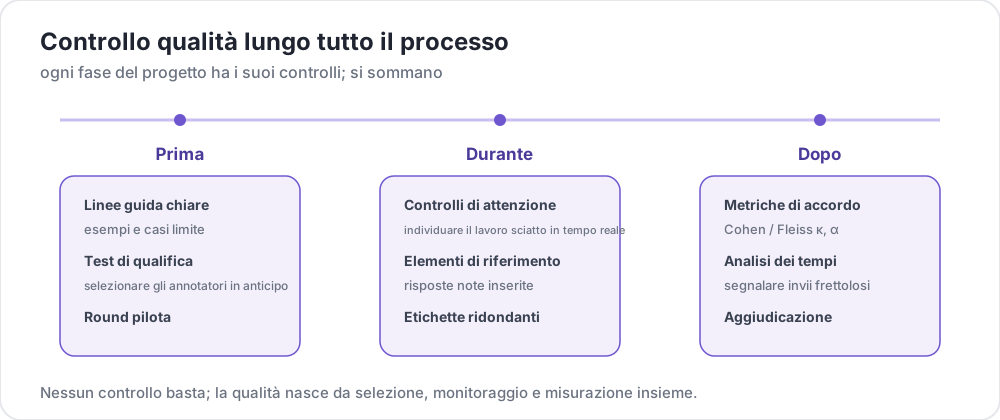 Il controllo qualità lungo la durata del progetto
Cosa intercetta ciascun controllo
I quattro controlli falliscono in direzioni diverse, ed è per questo che conviene usarne più di uno.
| Controllo | Intercetta | Non intercetta |
|---|---|---|
| Verifiche di attenzione | Annotatori che non leggono l'elemento | Un annotatore attento che fraintende le linee guida |
| Gold standard | Annotatori che leggono e rispondono male | Elementi senza un'unica risposta corretta |
| Sovrapposizione e accordo | Elementi ed etichette ambigui | Annotatori che concordano perché attingono alla stessa fonte |
| Tempi e telemetria | Lavoro consegnato troppo in fretta per essere stato fatto | Lavoro veloce su un corpus davvero facile |
L'accordo, in particolare, non intercetta tutto. Quando gli annotatori rivedono le pre-etichette di un modello, accettare un suggerimento senza leggerlo alza l'accordo invece di abbassarlo, per cui l'annotatore che approva senza guardare sembra il migliore secondo quella misura. L'accordo non può intercettare l'approvazione a occhi chiusi spiega cosa registrare al suo posto.
Verifiche di attenzione
Le verifiche di attenzione sono elementi con una risposta nota, inseriti nel flusso di annotazione a intervalli prestabiliti, che controllano che l'annotatore legga prima di rispondere. Potato le inserisce, le valuta, avvisa l'annotatore e lo blocca alla soglia che imposti, così l'intero ciclo gira sul server invece che in uno script a posteriori.
Imposta la frequenza in base a quanto tempo richiedono i tuoi elementi. Una verifica ogni 10 elementi basta per accorgersi di un annotatore che si distrae nel corso di una sessione senza spendere molto budget in elementi che non sono dati. La soglia minima min_response_time è ciò che intercetta chi clicca invece di leggere, e una risposta più veloce di quella soglia fallisce qualunque cosa dica:
attention_checks:
  enabled: true
  items_file: "data/attention_checks.json"
  frequency: 10              # one check every 10 items
  min_response_time: 3.0     # seconds; faster than this fails the check

  failure_handling:
    warn_threshold: 2
    warn_message: "Please read items carefully before answering."
    block_threshold: 5
    block_message: "You have been blocked due to too many incorrect responses."
Il file degli elementi assegna a ogni verifica un id, il testo che vede l'annotatore e la risposta attesa per ciascuno schema:
[
  {
    "id": "attn_001",
    "text": "Please select 'Positive' for this item to verify you are reading carefully.",
    "expected_answer": {
      "sentiment": "positive"
    }
  }
]
I risultati sopravvivono a un riavvio. Potato li scrive in quality_control_results.json nella directory di output man mano che vengono registrati e li rilegge all'avvio, quindi un deploy non cancella lo storico degli errori di un annotatore né sblocca chi era stato bloccato.
Gold standard
I gold standard sono elementi etichettati da esperti, mescolati nel flusso per misurare l'accuratezza invece dell'attenzione. Di default sono silenziosi, cioè i risultati vanno alla dashboard di amministrazione e l'annotatore non riceve alcun feedback, e in questo modo si misura la qualità senza modificare il comportamento che si sta misurando. Attiva il feedback quando stai formando gli annotatori invece di selezionarli.
Gli elementi gold vengono inseriti ogni frequency elementi, quindi questa impostazione bilancia la precisione della misura con la quota di budget che va a elementi di cui hai già le etichette. Uno ogni 20 dà circa 25 elementi valutati su un turno di 500 elementi:
gold_standards:
  enabled: true
  items_file: "data/gold_standards.json"
  mode: mixed                # mixed injects into the stream; this is the implemented mode
  frequency: 20

  accuracy:
    min_threshold: 0.7       # annotators below this are named in the dashboard
    evaluation_count: 10     # evaluate once an annotator has seen 10 gold items

  feedback:
    show_correct_answer: false
    show_explanation: false
Il file degli elementi contiene l'annotazione corretta per ciascuno schema, più una spiegazione facoltativa per il caso con feedback:
[
  {
    "id": "gold_001",
    "text": "The service was absolutely terrible and I will never return.",
    "gold_label": {
      "sentiment": "negative"
    },
    "explanation": "Strong negative language indicates negative sentiment.",
    "difficulty": "easy"
  }
]
Scegli elementi gold che per un esperto non siano ambigui. Un elemento su cui discute il tuo stesso team misura le linee guida invece dell'annotatore, e spingerà annotatori competenti sotto la soglia. Potato può anche promuovere elementi a gold quando gli annotatori concordano all'unanimità, tramite gold_standards.auto_promote, il che amplia il gruppo senza ulteriore etichettatura da parte di esperti.
L'accuratezza per annotatore compare in /admin/api/quality_control, che riporta configured_correct e configured_total accanto ai totali. Usa i numeri configurati quando confronti gli annotatori, perché il gruppo configurato è lo stesso per tutti, mentre quello promosso automaticamente dipende da quando è arrivato ciascun annotatore.
Sovrapposizione e accordo
Più annotatori per elemento è il controllo che trova gli elementi ambigui invece degli annotatori scadenti. Tre per elemento è il valore abituale, perché tre danno una maggioranza per l'aggregazione e abbastanza sovrapposizione per un coefficiente. Imposta l'obiettivo e attiva il monitoraggio:
num_annotators_per_item: 3

agreement_metrics:
  enabled: true
  min_overlap: 2
  refresh_interval: 60
L'alfa di Krippendorff compare poi nella dashboard di amministrazione man mano che arrivano le annotazioni, per ciascuno schema. Misurare l'accordo tra annotatori spiega quale coefficiente riportare e cosa significano le soglie.
Tempi e telemetria
Potato registra quanto tempo ha richiesto ogni elemento, non solo la risposta data. Ogni istanza porta un oggetto behavioral_data il cui total_time_ms è il tempo speso su quell'elemento, insieme agli eventi di interazione, alla cronologia delle modifiche all'annotazione e al ciclo di vita dei suggerimenti dell'IA. È questo campo che permette di distinguere un annotatore veloce perché il corpus è facile da uno veloce perché non sta guardando:
def flag_fast_annotations(export, min_seconds=2.0):
    """Instances submitted faster than a floor, from an exported annotation file."""
    flagged = []
    for instance in export:
        bd = instance.get("behavioral_data") or {}
        seconds = bd.get("total_time_ms", 0) / 1000
        if seconds < min_seconds:
            flagged.append((instance["id"], seconds))
    return flagged
Leggi i tempi come una distribuzione all'interno del tuo progetto invece che rispetto a un numero fisso di secondi, perché la stessa soglia che intercetta l'approvazione a occhi chiusi su un corpus difficile intercetta la competenza su uno facile. Per le annotazioni disegnate, annotation_telemetry registra la stessa idea a un livello di dettaglio più fine. Il suo segnale più forte è la latenza tra la comparsa di un suggerimento dell'IA e la sua accettazione da parte dell'annotatore. Tracciamento comportamentale e telemetria del disegno descrivono i campi e le segnalazioni che alimentano.
Una configurazione con tutti e quattro i controlli
Le quattro chiavi sono indipendenti, quindi un progetto può adottarle una alla volta. Insieme appaiono così:
annotation_task_name: "Sentiment Annotation with Quality Control"
task_description: "Classify the sentiment of short texts."

data_files:
  - data/items.json

item_properties:
  id_key: id
  text_key: text

annotation_schemes:
  - annotation_type: radio
    name: sentiment
    description: "What is the sentiment of this text?"
    labels:
      - Positive
      - Negative
      - Neutral

num_annotators_per_item: 3

attention_checks:
  enabled: true
  items_file: data/attention_checks.json
  frequency: 15
  min_response_time: 3.0
  failure_handling:
    warn_threshold: 2
    block_threshold: 5

gold_standards:
  enabled: true
  items_file: data/gold_standards.json
  mode: mixed
  frequency: 25
  accuracy:
    min_threshold: 0.7
    evaluation_count: 10

agreement_metrics:
  enabled: true
  min_overlap: 2
  refresh_interval: 60

output_annotation_dir: annotation_output
Parti con soglie permissive. Una soglia di blocco di 5 e un minimo di accuratezza di 0.7 ti permettono di vedere la distribuzione reale del tuo gruppo di annotatori prima di decidere cosa conta come errore, e restringerle in seguito non costa nulla. Fissarle rigide dal primo giorno espelle annotatori in base a linee guida che non sono ancora state provate in un pilota.
Controlli a livello di piattaforma
Le piattaforme di crowdsourcing filtrano il bacino prima che qualcuno arrivi al tuo task. È un compito diverso da quello delle verifiche precedenti, e vale la pena svolgerlo in aggiunta a esse.
- Preselezione. Prolific filtra in base al tasso di approvazione e al lavoro completato in precedenza, oltre che su dati demografici e lingua.
- Test di qualificazione. Un breve test nella fase di formazione di Potato regola l'accesso al task principale su qualsiasi piattaforma.
- Revisione prima del pagamento. Approva rapidamente quando il lavoro va bene, perché la lentezza nell'approvazione è la lamentela più frequente degli annotatori, e usa il rifiuto con parsimonia perché danneggia la reputazione del lavoratore sulla piattaforma.
La preselezione della piattaforma e le verifiche di Potato sono complementari. La preselezione decide chi arriva al task; le verifiche di attenzione e i gold standard misurano cosa ha fatto una volta arrivato.
Prima di raccogliere qualsiasi cosa
Due decisioni sono difficili da cambiare una volta avviata la raccolta, quindi prendile per prime. Decidi quali campi ti servono nell'esportazione, perché un'analisi dei tempi pianificata a posteriori richiede che behavioral_data sia stato registrato durante l'esecuzione. E fai un pilota di qualche decina di elementi con tutti i controlli attivi, perché è nel pilota che scopri che le tue verifiche di attenzione sono ambigue o che i tuoi elementi gold sono contestati, e costa un pomeriggio invece di un dataset.
Letture consigliate
- Gold standard e verifiche di attenzione
- Riferimento della funzione di controllo qualità
- Fase di formazione per preparare gli annotatori prima del task vero e proprio
- Scrivere linee guida di annotazione efficaci
- Condurre uno studio in crowdsourcing
- La documentazione sorgente sul controllo qualità di Potato