Qualitätskontrolle bei Annotation per Crowdsourcing
Aufmerksamkeitstests, Goldstandards, Überlappung zwischen Annotierenden und Zeitdaten kombinieren, um minderwertige Annotationen zu erkennen, mit den Potato-Konfigurationsschlüsseln für jede Prüfung und dem, was sie melden.
Keine einzelne Prüfung erkennt jede Art schlechter Annotation, also kombiniere vier: Aufmerksamkeitstests für Annotierende, die nicht lesen, Goldstandards für Annotierende, die lesen und trotzdem falsch liegen, Überlappung für mehrdeutige Items und Zeitdaten für Arbeit, die zu schnell abgegeben wurde, um tatsächlich erledigt worden zu sein. Jede hat ihren eigenen Konfigurationsschlüssel in Potato, und jede meldet getrennt an das Admin-Dashboard.
Qualitätskontrolle ist vor der Datenerhebung am billigsten und danach am teuersten. Ein Aufmerksamkeitstest, der Annotierende beim fünften Fehlschlag sperrt, kostet nichts in der Konfiguration und spart die Items, die sie sonst ausgefüllt hätten. Dasselbe Problem, erst nachträglich per Skript gefunden, kostet dich eine erneute Erhebung. Die folgenden Kontrollen sind danach geordnet, wann sie greifen.
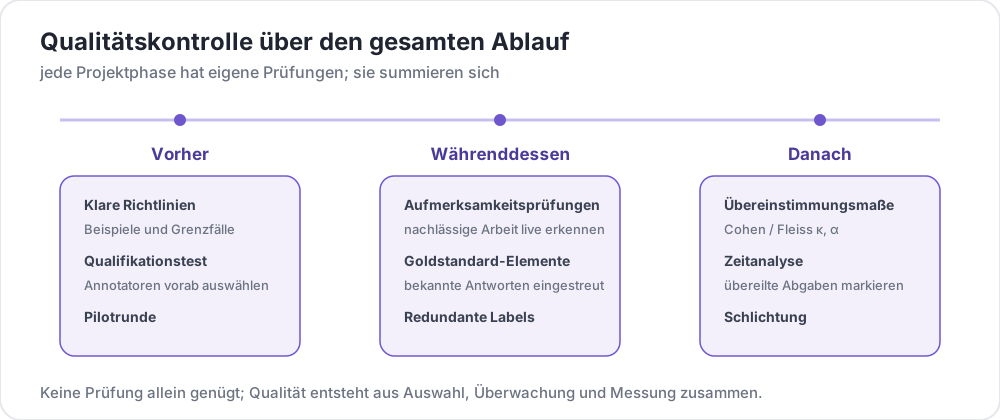 Qualitätskontrolle über den Projektverlauf
Was jede Kontrolle erkennt
Die vier Kontrollen versagen in unterschiedliche Richtungen, und genau deshalb lohnt es sich, mehr als eine einzusetzen.
| Kontrolle | Erkennt | Übersieht |
|---|---|---|
| Aufmerksamkeitstests | Annotierende, die das Item nicht lesen | Sorgfältige Annotierende, die die Richtlinien missverstehen |
| Goldstandards | Annotierende, die lesen und falsch antworten | Items ohne eine einzige richtige Antwort |
| Überlappung und Übereinstimmung | Mehrdeutige Items und Labels | Annotierende, die übereinstimmen, weil sie dieselbe Quelle nutzen |
| Zeit und Telemetrie | Arbeit, die zu schnell abgegeben wurde, um erledigt worden zu sein | Schnelle Arbeit an einem wirklich einfachen Korpus |
Gerade die Übereinstimmung erkennt nicht alles. Wenn Annotierende Vorannotationen eines Modells prüfen, erhöht das ungelesene Übernehmen eines Vorschlags die Übereinstimmung, statt sie zu senken. Wer ungeprüft abnickt, sieht nach diesem Maß also wie die beste Person aus. Übereinstimmung erkennt kein ungeprüftes Abnicken beschreibt, was du stattdessen aufzeichnen solltest.
Aufmerksamkeitstests
Aufmerksamkeitstests sind Items mit bekannter Antwort, die nach einem festen Takt in den Annotationsstrom eingefügt werden und prüfen, ob Annotierende lesen, bevor sie antworten. Potato fügt sie ein, bewertet sie, warnt die Annotierenden und sperrt sie ab einem Schwellenwert, den du festlegst. Der ganze Ablauf läuft also auf dem Server statt in einem nachträglichen Skript.
Leg die Häufigkeit danach fest, wie lange deine Items dauern. Ein Test alle 10 Items reicht, um Annotierende, deren Aufmerksamkeit nachlässt, noch innerhalb einer Sitzung zu erkennen, ohne viel Budget für Items auszugeben, die keine Daten sind. Die Untergrenze min_response_time erkennt Klicken statt Lesen, und eine Antwort, die schneller kommt, gilt als nicht bestanden, egal was sie aussagt:
attention_checks:
  enabled: true
  items_file: "data/attention_checks.json"
  frequency: 10              # one check every 10 items
  min_response_time: 3.0     # seconds; faster than this fails the check

  failure_handling:
    warn_threshold: 2
    warn_message: "Please read items carefully before answering."
    block_threshold: 5
    block_message: "You have been blocked due to too many incorrect responses."
Die Item-Datei gibt jedem Test eine ID, den Text, den die Annotierenden sehen, und die erwartete Antwort pro Schema:
[
  {
    "id": "attn_001",
    "text": "Please select 'Positive' for this item to verify you are reading carefully.",
    "expected_answer": {
      "sentiment": "positive"
    }
  }
]
Die Ergebnisse überstehen einen Neustart. Potato schreibt sie beim Erfassen in quality_control_results.json im Ausgabeverzeichnis und liest sie beim Start wieder ein. Ein Deployment löscht also weder die Fehlschlaghistorie einer Person noch hebt es eine bestehende Sperre auf.
Goldstandards
Goldstandards sind von Fachleuten gelabelte Items, die in den Strom gemischt werden, um Genauigkeit statt Aufmerksamkeit zu messen. Standardmäßig laufen sie still, das heißt, die Ergebnisse gehen an das Admin-Dashboard und die Annotierenden bekommen keine Rückmeldung. So misst du die Qualität, ohne das gemessene Verhalten zu verändern. Schalte die Rückmeldung ein, wenn du schulst statt auszuwählen.
Gold-Items werden alle frequency Items eingefügt. Die Einstellung wägt also die Messgenauigkeit gegen den Anteil des Budgets ab, der an Items geht, für die du schon Labels hast. Eins von 20 ergibt ungefähr 25 bewertete Items in einer Schicht von 500 Items:
gold_standards:
  enabled: true
  items_file: "data/gold_standards.json"
  mode: mixed                # mixed injects into the stream; this is the implemented mode
  frequency: 20

  accuracy:
    min_threshold: 0.7       # annotators below this are named in the dashboard
    evaluation_count: 10     # evaluate once an annotator has seen 10 gold items

  feedback:
    show_correct_answer: false
    show_explanation: false
Die Item-Datei enthält die richtige Annotation pro Schema sowie eine optionale Erklärung für den Fall mit Rückmeldung:
[
  {
    "id": "gold_001",
    "text": "The service was absolutely terrible and I will never return.",
    "gold_label": {
      "sentiment": "negative"
    },
    "explanation": "Strong negative language indicates negative sentiment.",
    "difficulty": "easy"
  }
]
Wähle Gold-Items, die für Fachleute eindeutig sind. Ein Item, über das dein eigenes Team streitet, misst die Richtlinien statt der Annotierenden und drückt kompetente Annotierende unter den Schwellenwert. Potato kann Items außerdem über gold_standards.auto_promote zu Gold hochstufen, sobald sich die Annotierenden einstimmig einig sind. Das vergrößert den Bestand ohne zusätzliches Labeln durch Fachleute.
Die Genauigkeit pro Person erscheint unter /admin/api/quality_control, das neben den Gesamtwerten configured_correct und configured_total meldet. Nutze beim Vergleich von Annotierenden die konfigurierten Zahlen, denn der konfigurierte Bestand ist für alle gleich, während der automatisch hochgestufte davon abhängt, wann jemand dazugekommen ist.
Überlappung und Übereinstimmung
Mehrere Annotierende pro Item sind die Kontrolle, die mehrdeutige Items findet statt schlechter Annotierender. Drei pro Item sind der übliche Standardwert, weil drei eine Mehrheit für die Aggregation und genug Überlappung für einen Koeffizienten ergeben. Leg den Zielwert fest und schalte die Auswertung ein:
num_annotators_per_item: 3

agreement_metrics:
  enabled: true
  min_overlap: 2
  refresh_interval: 60
Krippendorffs Alpha erscheint dann pro Schema im Admin-Dashboard, sobald Annotationen eingehen. Inter-Annotator-Übereinstimmung messen erklärt, welchen Koeffizienten du berichten solltest und was die Schwellenwerte bedeuten.
Zeit und Telemetrie
Potato zeichnet auf, wie lange jedes Item gedauert hat, nicht nur, was geantwortet wurde. Jede Instanz trägt ein Objekt behavioral_data, dessen total_time_ms die Zeit für dieses Item angibt, neben den Interaktionsereignissen, dem Änderungsverlauf der Annotation und dem Lebenszyklus der KI-Vorschläge. Mit diesem Feld unterscheidest du jemanden, der schnell ist, weil der Korpus einfach ist, von jemandem, der schnell ist, weil er nicht hinsieht:
def flag_fast_annotations(export, min_seconds=2.0):
    """Instances submitted faster than a floor, from an exported annotation file."""
    flagged = []
    for instance in export:
        bd = instance.get("behavioral_data") or {}
        seconds = bd.get("total_time_ms", 0) / 1000
        if seconds < min_seconds:
            flagged.append((instance["id"], seconds))
    return flagged
Lies Zeitdaten als Verteilung innerhalb deines eigenen Projekts statt gegen eine feste Sekundenzahl, denn derselbe Schwellenwert, der bei einem schweren Korpus ungeprüftes Abnicken erkennt, trifft bei einem leichten Korpus die Kompetenten. Für gezeichnete Annotationen zeichnet annotation_telemetry dieselbe Idee feiner auf. Das stärkste Signal dort ist die Latenz zwischen dem Erscheinen eines KI-Vorschlags und seiner Annahme durch die annotierende Person. Verhaltenserfassung und Zeichen-Telemetrie beschreiben die Felder und die Markierungen, die daraus entstehen.
Eine Konfiguration mit allen vier Kontrollen
Die vier Schlüssel sind voneinander unabhängig, sodass ein Projekt sie einzeln einführen kann. Zusammen sehen sie so aus:
annotation_task_name: "Sentiment Annotation with Quality Control"
task_description: "Classify the sentiment of short texts."

data_files:
  - data/items.json

item_properties:
  id_key: id
  text_key: text

annotation_schemes:
  - annotation_type: radio
    name: sentiment
    description: "What is the sentiment of this text?"
    labels:
      - Positive
      - Negative
      - Neutral

num_annotators_per_item: 3

attention_checks:
  enabled: true
  items_file: data/attention_checks.json
  frequency: 15
  min_response_time: 3.0
  failure_handling:
    warn_threshold: 2
    block_threshold: 5

gold_standards:
  enabled: true
  items_file: data/gold_standards.json
  mode: mixed
  frequency: 25
  accuracy:
    min_threshold: 0.7
    evaluation_count: 10

agreement_metrics:
  enabled: true
  min_overlap: 2
  refresh_interval: 60

output_annotation_dir: annotation_output
Beginne mit nachsichtigen Schwellenwerten. Eine Sperrschwelle von 5 und eine Genauigkeitsuntergrenze von 0,7 zeigen dir die tatsächliche Verteilung deines Annotierenden-Pools, bevor du entscheidest, was als Fehlschlag gilt, und später zu verschärfen kostet nichts. Sie am ersten Tag streng zu setzen wirft Annotierende auf Grundlage von Richtlinien hinaus, die noch nicht in einem Pilot erprobt wurden.
Kontrollen auf Plattformebene
Crowdsourcing-Plattformen filtern den Pool, bevor überhaupt jemand deine Aufgabe erreicht. Das ist eine andere Aufgabe als die der Prüfungen oben und lohnt sich zusätzlich zu ihnen.
- Vorauswahl. Prolific filtert nach Annahmequote und bisher erledigter Arbeit sowie nach demografischen Merkmalen und Sprache.
- Qualifikationstests. Ein kurzer Test in der Trainingsphase von Potato steuert auf jeder Plattform den Zugang zur Hauptaufgabe.
- Prüfung vor der Bezahlung. Gib einwandfreie Arbeit schnell frei, denn langsame Freigabe ist das, worüber sich Annotierende am häufigsten beschweren, und lehne sparsam ab, weil eine Ablehnung dem Ansehen der Arbeitenden auf der Plattform schadet.
Die Vorauswahl der Plattform und die Prüfungen in Potato ergänzen sich. Die Vorauswahl entscheidet, wer die Aufgabe erreicht; Aufmerksamkeitstests und Goldstandards messen, was die Leute dort dann getan haben.
Bevor du irgendetwas erhebst
Zwei Entscheidungen lassen sich nach Beginn der Erhebung kaum rückgängig machen, also triff sie zuerst. Entscheide, welche Felder du im Export brauchst, denn eine nachträglich geplante Zeitanalyse setzt voraus, dass behavioral_data während des Durchlaufs aufgezeichnet wurde. Und fahre einen Pilot mit ein paar Dutzend Items und allen Kontrollen eingeschaltet, denn im Pilot findest du heraus, dass deine Aufmerksamkeitstests mehrdeutig oder deine Gold-Items umstritten sind, und das kostet einen Nachmittag statt eines Datensatzes.
Weiterführende Literatur
- Goldstandards und Aufmerksamkeitstests
- Referenz zur Funktion Qualitätskontrolle
- Trainingsphase zum Einarbeiten der Annotierenden vor der eigentlichen Aufgabe
- Wirksame Annotationsrichtlinien schreiben
- Eine Crowdsourcing-Studie durchführen
- Die Quelldokumentation zur Qualitätskontrolle von Potato