Как размечать субтитры YouTube
Как скачать субтитры через yt-dlp и размечать их в Potato, что автоматические субтитры позволяют, а что нет, как поступить с видео и что проверить перед распространением медиа.
Скачайте субтитры через yt-dlp и направьте Potato на файлы. У автоматических субтитров нет ни пунктуации, ни меток говорящих, а их разбиение на строки бессмысленно, и это ограничивает то, что осмысленно размечать. Potato читает любой формат субтитров, который выдаёт yt-dlp. Полный список — в форматах расшифровок.
Видеоплатформы — большой и удобный источник естественной звучащей речи. Скрытые субтитры превращают эту речь в текст, а текст мал, легко переносится и легко размечается. Загвоздка в том, что не все субтитры — объект одного рода, и обращение с ними как с однородными и есть то место, где большинство проектов разметки по субтитрам сходит с рельсов.
Как скачать субтитры?
yt-dlp забирает субтитры с медиа или без него:
# Human-written subtitles, if the uploader provided any
yt-dlp --write-subs --sub-langs en --skip-download <URL>

# Auto-generated captions
yt-dlp --write-auto-subs --sub-langs en --sub-format vtt --skip-download <URL>
Potato читает vtt, srt, json3, ttml, а также варианты srv1, srv2 и srv3, так что любой выбранный вами --sub-format разберётся. Выбирайте по тому, что хотите сохранить: json3 сохраняет пословные тайминги, а WebVTT и SubRip удобнее читать и править руками.
Чем человеческие субтитры отличаются от автоматических?
В текстовом редакторе они выглядят похоже, а как вход для разметки ведут себя совершенно по-разному:
| Человеческие субтитры | Автоматические | |
|---|---|---|
| Пунктуация | Есть | Нет или ненадёжна |
| Границы предложений | Осмысленные | Произвольные |
| Говорящие | Иногда, через теги <v Name> | Никогда |
| Пословные тайминги | Нет | Есть, в json3 |
| Дословность | Часто сжаты для удобства чтения | Ближе к сказанному |
Ни те, ни другие не лучше однозначно. Человеческие субтитры хорошо читаются, но их правят ради читаемости: выбрасывают слова-паразиты, сжимают повторы, а иногда переписывают предложение целиком. Автоматические ближе к дословным — а это и нужно для всего, что касается того, как люди на самом деле говорят, — но приходят они непунктуированным потоком.
Что можно размечать на автоматических субтитрах?
Не проектируйте схему разметки на уровне предложений поверх автоматических субтитров. Границы их фрагментов проходят там, где заполнилось окно субтитра, а не там, где кончилось предложение. Фрагмент в файле автосубтитров — артефакт отображения, а не языковая единица. Попросите разметчиков оценивать предложения, и каждый молча выберет свои границы предложений, а ваши показатели согласованности в итоге будут мерить именно это, а не то, что вас интересовало.
Два рабочих варианта:
- Размечайте окна субтитров как есть. Помечайте каждый фрагмент тем, что к нему применимо, и примите, что единица произвольна, зато единообразна. Годится для темы, наличия явления и всего, что можно оценить по обрывку.
- Пересегментируйте на предыдущем этапе. Прогоните модель восстановления пунктуации или систему распознавания речи, которая расставляет знаки, а затем заново проставьте тайминги. Работы больше, зато единицы настоящие.
Если у вас человеческие субтитры, эта проблема по большей части исчезает. Границы фрагментов расставлял человек, читавший вместе с записью, так что обычно они уважают границы клауз.
Что делать с видео?
Субтитры малы и легко распространяются. Видео обычно нет. Три варианта:
# Media hosted somewhere your annotators can reach
potato transcripts ./captions --media-url-prefix https://cdn.example.org/video -o data/talks.json

# Media downloaded locally as audio only
yt-dlp -f 'ba' -x --audio-format mp3 -o './audio/%(id)s.%(ext)s' <URL>
potato transcripts ./captions --media-dir ./audio -o data/talks.json
Третий вариант — вообще без медиа. Расшифровки без медиа размечаются нормально: разметчики читают вместо того, чтобы слушать. Если это ваш план, скажите об этом в инструкции, иначе разметчики решат, что отсутствующий плеер — это баг, и заведут его как баг.
Внимание: проверьте свои права, прежде чем распространять то, что создали не вы. Скачать субтитры или медиа для собственного исследования — это одно, а отдавать это медиа пулу разметчиков — другое, и здесь имеют значение и правила платформы, и авторское право, и нормы вашей организации. Разберитесь с этим до того, как соберёте конвейер, а не после.
Как настроить задачу?
Конвертер записывает файл данных с уже нормализованной расшифровкой:
potato transcripts ./captions --media-dir ./audio -o data/talks.json{
"id": "talk_01",
"conversation": {
"audio": "audio/talk_01.mp3",
"turns": [
{"turn_id": "t0", "speaker": null, "start": 0.0, "end": 4.2,
"text": "so the thing about caption windows is"}
]
}
}speaker: null — это то, что даёт автоматический субтитр. Такие реплики рисуются как Unassigned с выпадающим списком, чтобы разметчики могли назначить говорящего по ходу прослушивания.
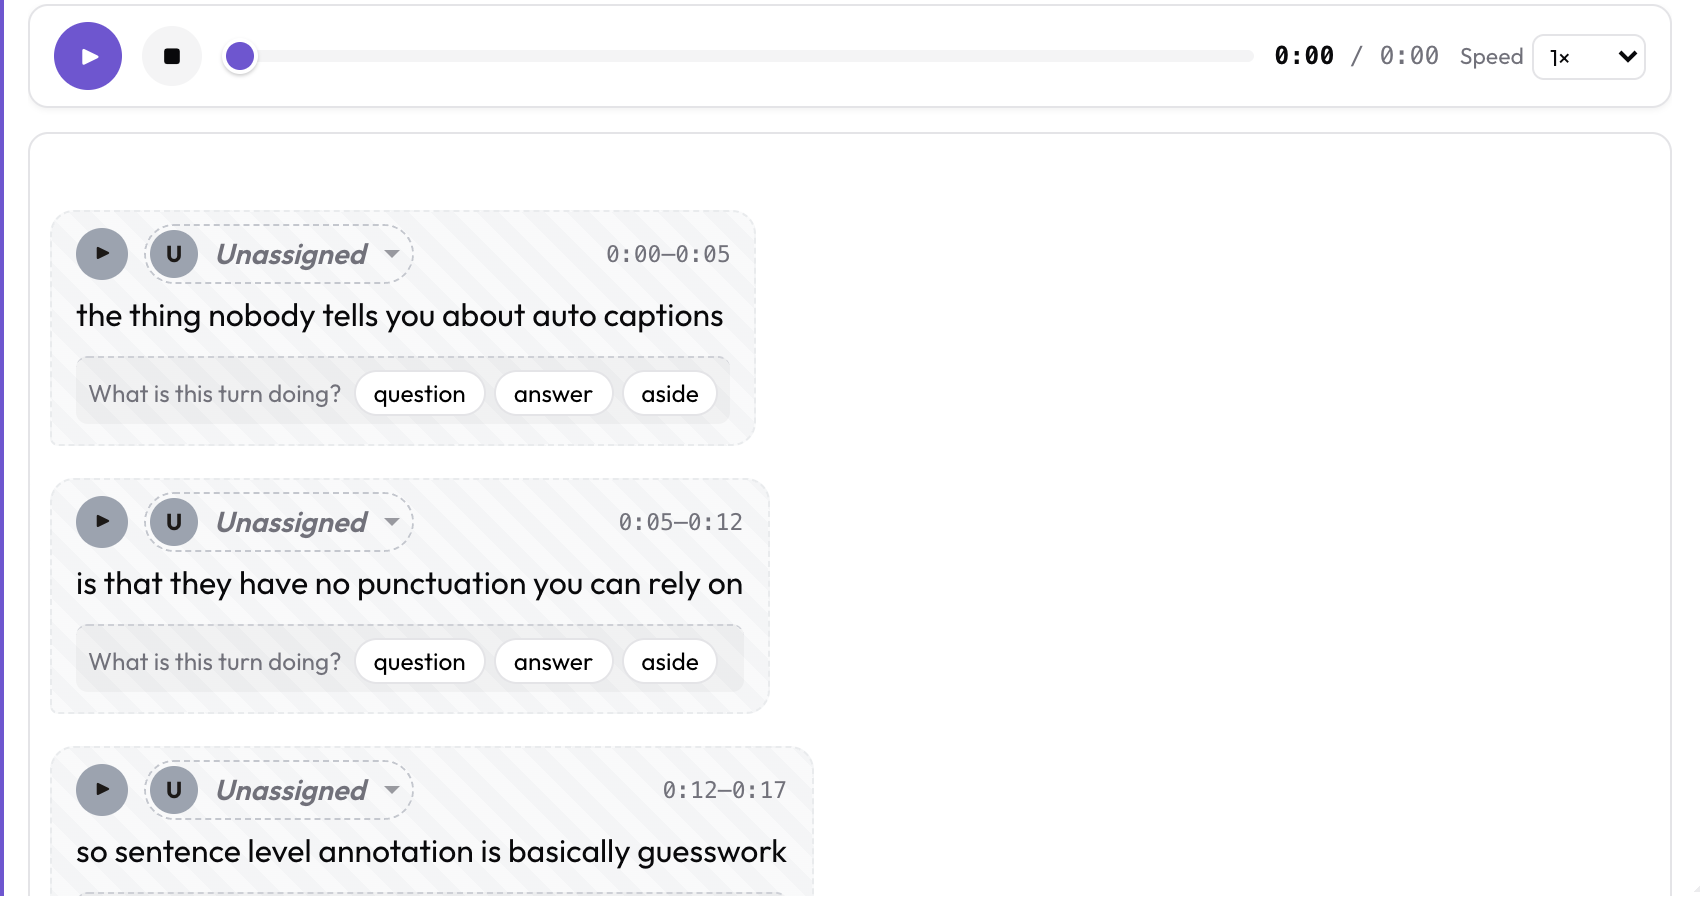 Auto-captions carry no speakers, so each cue is Unassigned until an annotator picks one
annotation_task_name: "Talk Annotation"
task_dir: .
data_files:
  - data/talks.json

item_properties:
  id_key: id
  text_key: conversation

instance_display:
  fields:
    - key: conversation
      type: audio_dialogue
      label: "Captions"
      span_target: true
      display_options:
        show_timestamps: true
        allow_speaker_assignment: auto

annotation_schemes:
  - annotation_type: radio
    name: cue_topic
    description: "What is this caption window about?"
    labels: [setup, argument, example, aside]
turn_level: true привязывает вопрос к каждому фрагменту, а не к видео целиком, и это верная единица, когда кроме фрагментов у вас ничего нет. Запускайте:
python potato/flask_server.py start config.yaml -p 8000Можно и вовсе обойтись без конвертера, указав в файле данных прямо на файлы субтитров на диске. См. Как размечать расшифровки Whisper — остальная часть процесса там та же.
Что почитать дальше
- Форматы расшифровок — все поддерживаемые форматы субтитров и расшифровок
- Как размечать расшифровки Whisper — версия этого процесса для вывода распознавания речи
- Приём форматов расшифровок — запускаемый пример из галереи с шестью форматами рядом
- Разметка видео — для разметки самого видео, а не его субтитров
- Как проектировать форматы данных для разметки
- Timed Text Markup Language — вещательный стандарт субтитров, который Potato тоже читает