Активное обучение
Переупорядочивайте очередь разметки в Potato по неопределённости модели: пять стратегий отбора, классификаторы sklearn, обработка холодного старта и сохранение модели между перезапусками.
Активное обучение переупорядочивает очередь разметки так, чтобы разметчики видели сначала объекты, в которых модель уверена меньше всего, а не проходили корпус в том порядке, в каком он поступил.
Как это работает
- Сбор: накопить первичный набор разметки
- Обучение: обучить классификатор на том, что уже размечено
- Оценка: оценить неразмеченный пул по неопределённости
- Переупорядочивание: поставить в начало очереди самые неопределённые объекты
- Разметка: разметить приоритетные объекты
- Переобучение: периодически переобучать модель по мере накопления разметки
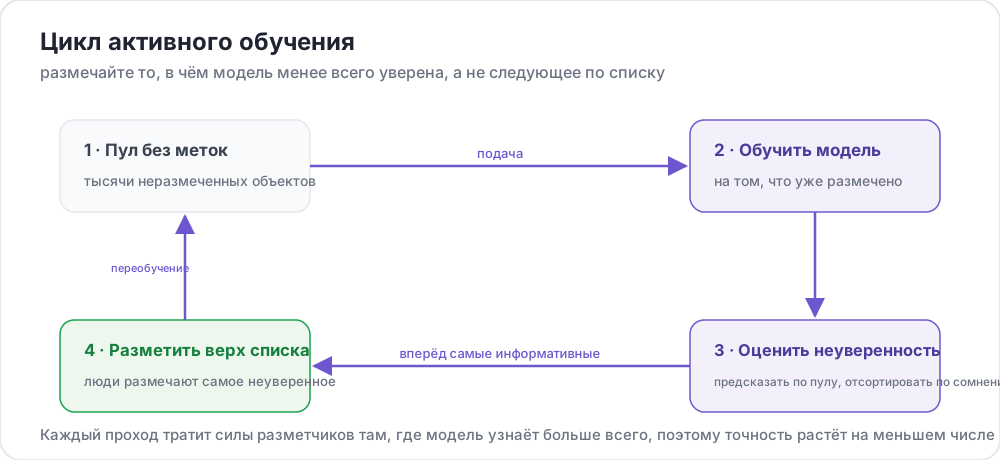 Тратьте усилия на разметку там, где модель учится больше всего
Конфигурация
Базовая настройка
active_learning:
  enabled: true
  schema_names:
    - sentiment

  min_annotations_per_instance: 1
  min_instances_for_training: 20
  update_frequency: 50
  max_instances_to_reorder: 1000
По умолчанию min_instances_for_training равен 10, а update_frequency равен 5. Оба значения достаточно малы, чтобы в реальном проекте их стоило увеличить: переобучение каждые пять аннотаций тратит вычисления на модель, которая почти не изменилась.
Полная конфигурация
active_learning:
  enabled: true

  schema_names:
    - sentiment

  min_annotations_per_instance: 1
  min_instances_for_training: 20
  update_frequency: 50
  max_instances_to_reorder: 1000

  # How disagreement between annotators resolves into one training label
  resolution_strategy: majority_vote

  # Fraction of the queue left in random order, so the model does not
  # only ever see what it already found interesting
  random_sample_percent: 0.2

  classifier:
    name: sklearn.linear_model.LogisticRegression
    hyperparameters:
      C: 1.0
      max_iter: 1000

  vectorizer:
    name: sklearn.feature_extraction.text.TfidfVectorizer
    hyperparameters:
      max_features: 5000
      ngram_range: [1, 2]

  query_strategy: uncertainty

  model_persistence:
    enabled: true
    save_directory: "models/"
    retention_count: 5
Вложенные блоки classifier, vectorizer и model_persistence являются документированной формой, и именно её распознаёт potato validate --strict. Вложенные ключи первых двух блоков называются name и hyperparameters, а третьего enabled, save_directory и retention_count. Блок с другими именами вложенных ключей игнорируется без предупреждения, и запуск молча возвращается к значениям по умолчанию.
Стратегии отбора
| Стратегия | Описание |
|---|---|
uncertainty | Объекты, в которых модель уверена меньше всего. Используется по умолчанию |
diversity | Объекты, наименее похожие на уже размеченные |
badge | Batch Active learning by Diverse Gradient Embeddings |
bald | Bayesian Active Learning by Disagreement |
hybrid | Взвешенное сочетание uncertainty и diversity |
active_learning:
  query_strategy: uncertainty
Неизвестное имя стратегии не прерывает запуск, а с предупреждением заменяется на uncertainty. Если стратегия как будто ни на что не влияет, проверьте лог.
Настройка hybrid и BALD
По умолчанию hybrid берёт 70% от uncertainty и 30% от diversity:
active_learning:
  query_strategy: hybrid
  hybrid_weights:
    uncertainty: 0.7
    diversity: 0.3
bald обучает небольшой ансамбль и ранжирует объекты по расхождению внутри него:
active_learning:
  query_strategy: bald
  bald_params:
    n_estimators: 5
    bootstrap_fraction: 0.8
Классификаторы
Классификаторы задаются путём импорта из sklearn. По умолчанию используется sklearn.linear_model.LogisticRegression.
| Классификатор | Путь | Для чего лучше | Скорость |
|---|---|---|---|
| Логистическая регрессия | sklearn.linear_model.LogisticRegression | Большинство текстовых задач | Быстро |
| Случайный лес | sklearn.ensemble.RandomForestClassifier | Нелинейные закономерности | Средне |
| SVC | sklearn.svm.SVC | Небольшие датасеты | Медленно |
| Мультиномиальный NB | sklearn.naive_bayes.MultinomialNB | Простая классификация текста | Очень быстро |
Логистическая регрессия, рекомендуемая отправная точка:
active_learning:
  classifier:
    name: sklearn.linear_model.LogisticRegression
    hyperparameters:
      C: 1.0
      max_iter: 1000
Случайный лес, когда граница решения далека от линейной:
active_learning:
  classifier:
    name: sklearn.ensemble.RandomForestClassifier
    hyperparameters:
      n_estimators: 100
      max_depth: 10
SVC нужно явно указать, чтобы он выдавал вероятности, поскольку от них зависит оценка неопределённости:
active_learning:
  classifier:
    name: sklearn.svm.SVC
    hyperparameters:
      kernel: rbf
      probability: true
Наивный байесовский классификатор, когда скорость важнее последнего пункта точности:
active_learning:
  classifier:
    name: sklearn.naive_bayes.MultinomialNB
    hyperparameters:
      alpha: 1.0
calibrate_probabilities включён по умолчанию. Это важно, потому что отбор по неопределённости ранжирует по предсказанной вероятности, а некалиброванный классификатор ранжирует уверенно ошибочные объекты так, будто вопрос по ним уже решён.
Векторизаторы
По умолчанию используется sklearn.feature_extraction.text.TfidfVectorizer.
TF-IDF, взвешенные признаки:
active_learning:
  vectorizer:
    name: sklearn.feature_extraction.text.TfidfVectorizer
    hyperparameters:
      max_features: 5000
      ngram_range: [1, 2]
      stop_words: english
Простой подсчёт:
active_learning:
  vectorizer:
    name: sklearn.feature_extraction.text.CountVectorizer
    hyperparameters:
      max_features: 3000
      ngram_range: [1, 1]
Хеширование, для словаря, который слишком велик, чтобы держать его в памяти:
active_learning:
  vectorizer:
    name: sklearn.feature_extraction.text.HashingVectorizer
    hyperparameters:
      n_features: 10000
ngram_range записывается как список YAML и преобразуется в кортеж, которого ожидает sklearn, поэтому [1, 2] здесь верно и никакого особого синтаксиса не требует.
Холодный старт
Пока модели нет, оценивать неопределённость не по чему, поэтому первый батч выбирается без неё:
active_learning:
  cold_start_strategy: random
  cold_start_batch_size: 20
Отбор с помощью LLM
LLM может оценивать объекты в период холодного старта или вместе с классификатором:
active_learning:
  enabled: true
  schema_names:
    - sentiment

  llm:
    enabled: true
    endpoint_type: vllm
    base_url: http://localhost:8000/v1
    model: meta-llama/Llama-3.2-3B-Instruct
    confidence_method: verbalized
confidence_method определяет, как получается оценка уверенности. Выбор важен, потому что именно эта оценка управляет отбором:
| Метод | Как работает | Компромисс |
|---|---|---|
verbalized | Модель сама сообщает свою уверенность по шкале 1-10 | Работает везде, но на некоторых моделях ненадёжен |
logprobs | Вычисляется из логарифмов вероятностей токенов | Лучшая калибровка, но нужен эндпоинт, возвращающий logprobs |
consistency | Один и тот же объект запрашивается несколько раз и оценивается по согласованности ответов | Работает где угодно, ценой N вызовов на объект |
Если эндпоинт не возвращает logprobs, logprobs переключается на verbalized-оценку уверенности.
Сохранение модели
Обученные модели могут переживать перезапуск, а не строиться заново с нуля:
active_learning:
  model_persistence:
    enabled: true
    save_directory: "models/"
    retention_count: 5
По умолчанию retention_count равен 2; он ограничивает число хранимых сохранённых моделей.
Сохранение в базу данных больше не настраивается. Ключи database_enabled и database_config удалены, потому что стоявший за ними слой был заглушкой, которая писала в лог об успехе и ничего не сохраняла. История запусков теперь записывается всегда и не требует настройки, а оба ключа игнорируются, если они ещё остались в конфигурации.
Несколько схем
schema_names перечисляет схемы, разметка по которым обучает модель. Если параметр не задан, по умолчанию берутся схемы проекта, в которых ставятся метки:
annotation_schemes:
  - annotation_type: radio
    name: sentiment
    description: "What is the sentiment?"
    labels: [Positive, Negative, Neutral]

  - annotation_type: radio
    name: topic
    description: "What is the topic?"
    labels: [Politics, Sports, Tech, Entertainment]

active_learning:
  enabled: true
  schema_names:
    - sentiment
    - topic
Пример полной конфигурации
annotation_task_name: "Sentiment Analysis with Active Learning"
task_dir: "."
port: 8000

data_files:
  - "data/reviews.json"

item_properties:
  id_key: id
  text_key: text

annotation_schemes:
  - annotation_type: radio
    name: sentiment
    description: "What is the sentiment?"
    labels:
      - Positive
      - Negative
      - Neutral
    sequential_key_binding: true

active_learning:
  enabled: true
  schema_names:
    - sentiment

  min_annotations_per_instance: 1
  min_instances_for_training: 30
  update_frequency: 50
  max_instances_to_reorder: 500
  random_sample_percent: 0.2

  classifier:
    name: sklearn.linear_model.LogisticRegression
    hyperparameters:
      C: 1.0
      max_iter: 1000

  vectorizer:
    name: sklearn.feature_extraction.text.TfidfVectorizer
    hyperparameters:
      max_features: 5000
      ngram_range: [1, 2]

  query_strategy: uncertainty

  model_persistence:
    enabled: true
    save_directory: "models/"
    retention_count: 5

output_annotation_dir: "output/"
export_annotation_format: jsonl

user_config:
  allow_all_users: true
В сочетании с поддержкой ИИ
Активное обучение решает, что показать следующим. Поддержка ИИ помогает разметчику с тем, что уже на экране. Они независимы и хорошо сочетаются:
active_learning:
  enabled: true
  schema_names:
    - sentiment
  min_instances_for_training: 30

ai_support:
  enabled: true
  endpoint_type: openai
  ai_config:
    model: gpt-4o-mini
    api_key: ${OPENAI_API_KEY}
    max_tokens: 800
    include:
      all: true
Осторожнее с интерпретацией результата. Если модель предлагает метку, разметчик её принимает, а объект выбрала модель того же семейства, то согласие, которое вы измерите в конце, отчасти является согласием модели с самой собой.
Мониторинг
Админ-панель показывает точность модели, число циклов обучения, распределение неопределённости и количество оставшихся объектов. Для доступа нужен админский ключ или роль с правом view_admin_dashboard.
Рекомендации
Сначала соберите базовую разметку
На пустом наборе ничего не обучить, а модель, обученная на двадцати аннотациях, в основном переупорядочивает шум:
active_learning:
  min_instances_for_training: 50
Следите за балансом классов
Отбор по неопределённости сосредоточен у границы решения, из-за чего распределение меток уходит от распределения в корпусе. Для обучения модели это нормально, но вводит в заблуждение, если вы представляете размеченную выборку как описание данных. Именно поэтому random_sample_percent оставляет часть очереди несмещённой.
Не переобучайте слишком часто
active_learning:
  update_frequency: 100
Сохраняйте модели между перезапусками
active_learning:
  model_persistence:
    enabled: true
    save_directory: "models/"
Решение проблем
Обучение не начинается
Проверьте, что число аннотаций достигло min_instances_for_training и что у каждого класса есть хотя бы один пример. На обучающем наборе из одного класса классификатор обучить нельзя.
Переупорядочивание как будто ничего не меняет
Поищите в логе неизвестную query_strategy: она молча заменяется на uncertainty. Убедитесь, что задано enabled: true и что schema_names называет схемы, которые действительно существуют.
Медленно на большом пуле
Уменьшите max_instances_to_reorder, увеличьте update_frequency или перейдите на HashingVectorizer для очень большого словаря.
Что почитать дальше
- Поддержка ИИ - помощь LLM во время разметки
- Назначение заданий - другие стратегии назначения
- Админ-панель - наблюдение за циклом обучения
- Упорядочивание по разнообразию - упорядочивание на основе эмбеддингов без классификатора
Детали реализации см. в исходной документации.