Как размечать расшифровки Whisper
Как взять вывод Whisper или WhisperX и превратить его в работающий проект разметки: какой файл сохранять, когда нужна диаризация, как назначать говорящих и как выгрузить результат, не потеряв тайминги.
Whisper выдаёт сегменты с таймингами, и инструмент разметки должен читать их как есть. Сохраняйте вывод .json, а не .txt, запустите WhisperX, если нужны метки говорящих, и направьте Potato на папку. Ни скриптов конвертации, ни этапа переформатирования. Разбор по каждому формату — в форматах расшифровок.
Whisper — открытая модель распознавания речи от OpenAI, ставшая первым шагом по умолчанию для всех, у кого накопилась гора аудио. На выходе получается набор сегментов с таймингами, а это почти всё, что нужно проекту разметки. Пробел — всё, что лежит между «расшифровки есть» и «разметчики их размечают».
Замечание: Potato не расшифровывает. Распознавание речи идёт до него, а Potato принимает результат. Это руководство разбирает, какие решения на предыдущем этапе важны, но сама расшифровка происходит до того, как Potato что-либо увидит.
Какой файл вывода Whisper сохранять?
Whisper пишет несколько файлов, и выбор здесь важнее, чем кажется:
whisper interview_01.mp3 --model medium --output_format json --word_timestamps True| Файл | Что содержит | Брать? |
|---|---|---|
.json | Сегменты с временем начала и конца, при желании с пословными таймингами | Да, именно этот |
.srt / .vtt | Сегменты с таймингами, без метаданных | Да, работает нормально |
.tsv | Начало и конец в миллисекундах плюс текст | Да |
.txt | Только текст, без таймингов | Нет, синхронизировать со звуком нечем |
Если у вас остался только .txt, выравнивание потеряно и восстановить его без повторного прогона модели нельзя. Это самая частая причина, по которой расшифровка попадает в Potato одним нерасчленённым куском текста.
Размечает ли Whisper говорящих?
Нет. Обычный Whisper расшифровывает, но не сообщает, кто говорит. Каждая реплика приходит без привязки — для разметки содержания это нормально и мучительно для всего, что связано с говорящими.
Диаризация говорящих — отдельный шаг. Три способа с ней справиться:
Запустите WhisperX, который оборачивает Whisper диаризацией через pyannote:
whisperx interview_01.mp3 --model medium --diarize --output_format jsonВ его выводе у каждого сегмента есть поле speaker (SPEAKER_00, SPEAKER_01 и так далее), и Potato читает его напрямую.
Возьмите облачный API с включённой диаризацией. Deepgram с diarize=true, AssemblyAI со speaker_labels, AWS Transcribe и Rev.ai — все выдают метки говорящих, и Potato читает все четыре формата изначально.
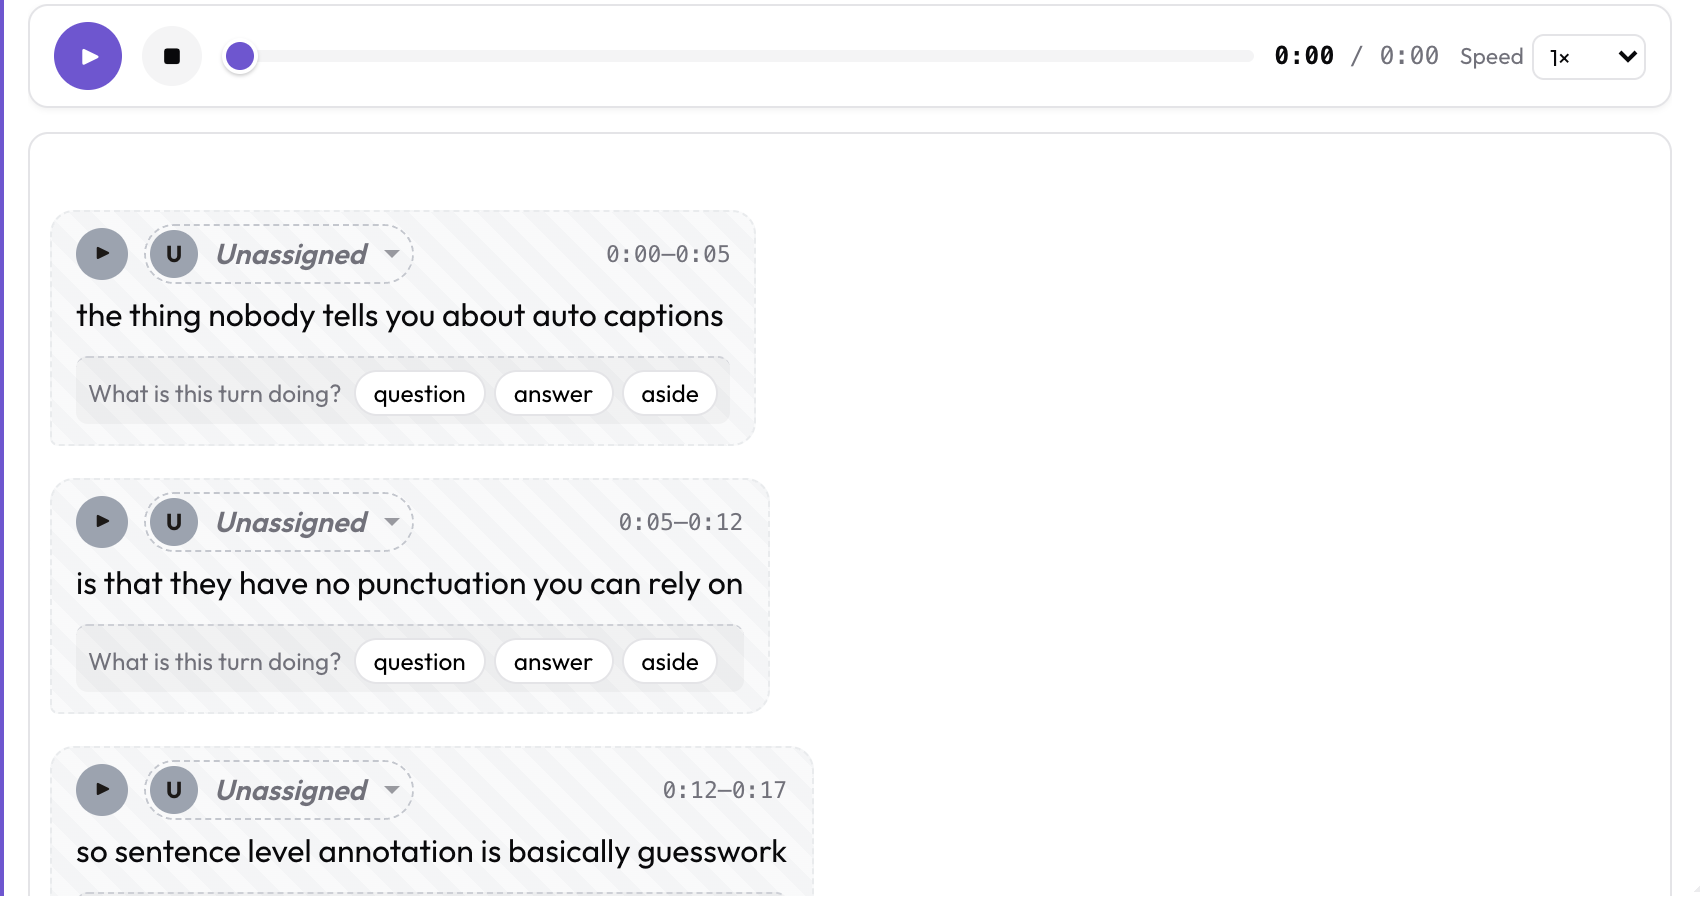 Undiarized turns render as Unassigned with a speaker picker
Отдайте это разметчикам. Когда реплики приходят без диаризации, каждый пузырь рисуется как Unassigned с выпадающим списком. На грязном звуке, при накладывающейся речи или в комнате с фоновым шумом слушающий человек часто точнее автоматической диаризации. Для небольшого корпуса это разумный обмен, а не запасной вариант.
Как собрать файл данных?
Направьте конвертер на папку с выводом Whisper:
potato transcripts ./whisper_out --media-dir ./audio -o data/interviews.jsonРасшифровки сопоставляются с медиа по базовому имени, так что interview_01.json найдёт interview_01.mp3. Идентификаторы объектов берутся из имени файла, а удвоенное расширение Whisper interview_01.mp3.json обрабатывается так, что идентификатор interview_01.mp3 не появляется.
Проверьте, что он понял, прежде чем на это опираться:
potato transcripts ./whisper_out --dry-runScanned 3 file(s):
interview_01.json Whisper JSON 42 turns 891.4s undiarized
interview_02.json WhisperX JSON 51 turns 1120.8s 2 speaker(s): SPEAKER_00, SPEAKER_01
interview_03.json Whisper JSON 38 turns 754.2s undiarized
3 item(s), 131 turn(s).
Файл, о котором сообщается plain text или ноль реплик, — это ваш проблемный файл. Почти всегда это .txt, случайно попавший в папку с выводом .json.
Можно ли пропустить конвертацию?
Да. Файл данных может ссылаться прямо на файлы расшифровок на диске:
{"id": "int_001", "conversation": {"audio": "media/int_001.mp3",
                                   "transcript": "media/int_001.srt"}}
Potato прочитает файл, определит формат по содержимому и нормализует его при отрисовке объекта. Ваши расшифровки остаются файлами, которые можно сравнивать и переэкспортировать, вместо того чтобы быть запечёнными в кусок данных.
Как выглядит конфигурация?
Сформированный файл данных имеет такой вид:
{
  "id": "interview_01",
  "conversation": {
    "audio": "audio/interview_01.mp3",
    "turns": [
      {"turn_id": "t0", "speaker": "SPEAKER_00", "start": 0.0, "end": 6.5,
       "text": "Welcome back."}
    ]
  }
}
А вот подходящая конфигурация, которую potato transcripts --emit-config напечатает за вас:
annotation_task_name: "Interview Annotation"
task_dir: .
data_files:
- data/interviews.json
item_properties:
id_key: id
text_key: conversation
instance_display:
fields:
- key: conversation
type: audio_dialogue
label: "Transcript"
span_target: true
display_options:
show_timestamps: true
allow_speaker_assignment: auto
annotation_schemes:
- annotation_type: span
name: topics
description: "Highlight topic mentions"
labels:
- name: policy
- name: personal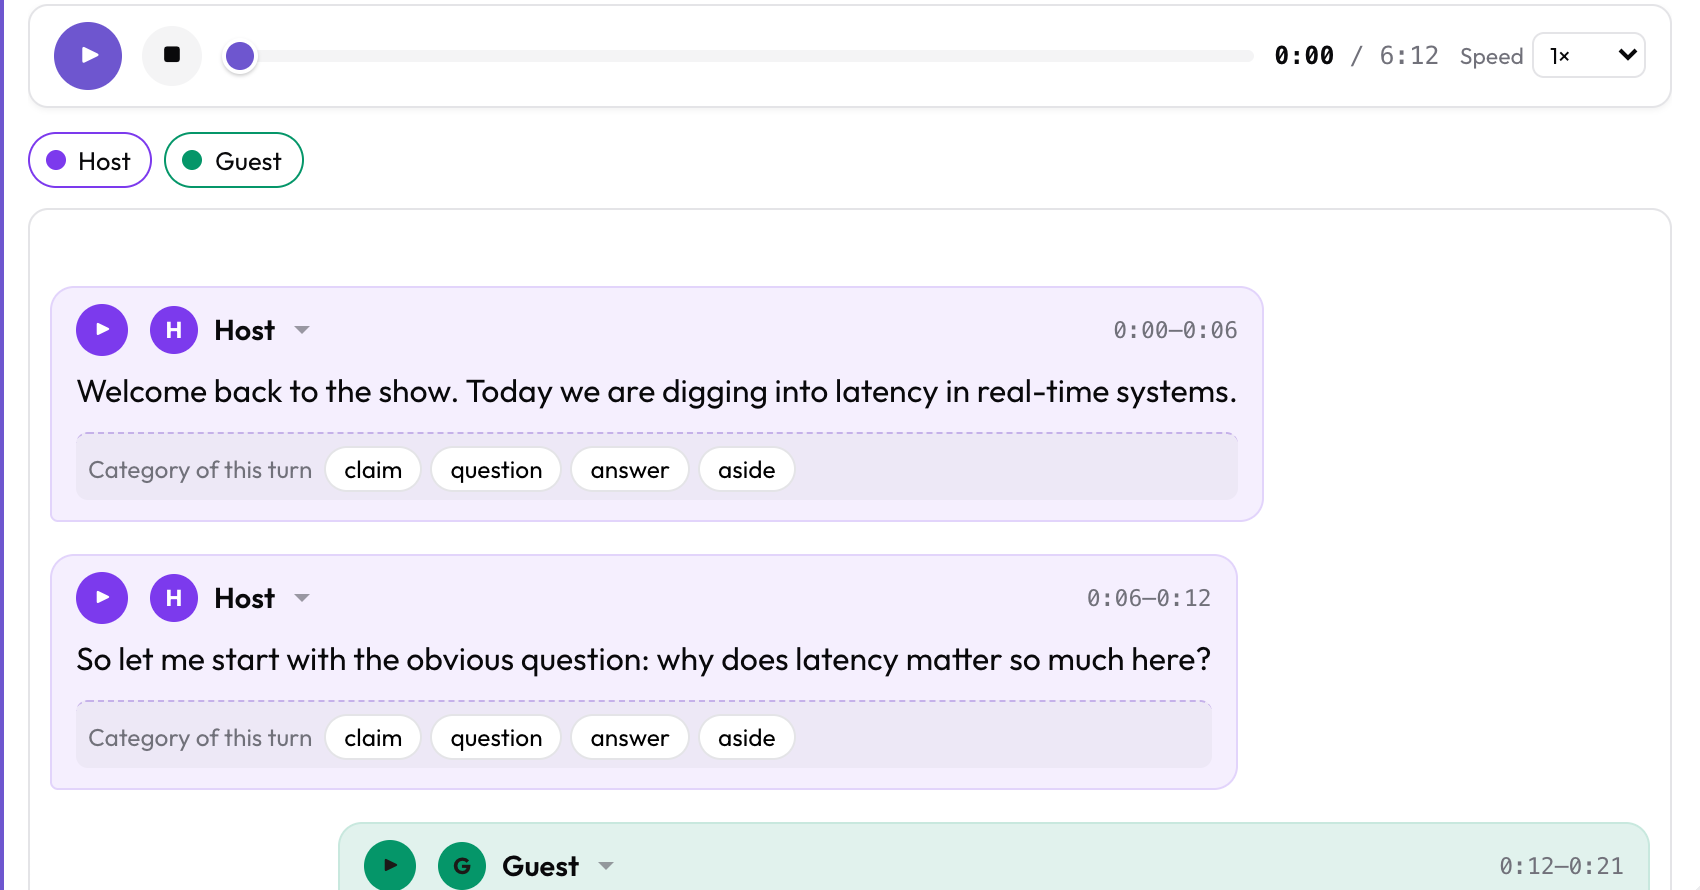 The audio_dialogue display, with a per-turn question attached to every turn
Отображение audio_dialogue рисует реплики цветными пузырями говорящих, синхронизированными со звуком, и у каждой реплики есть кнопка воспроизведения, играющая только её. span_target: true позволяет спанам пересекать границы реплик, а смещения остаются устойчивыми, когда говорящего переназначают.
Если вам нужнее, чтобы разметчики проверяли саму расшифровку, а не размечали её содержание, speech_transcript даст карточки сегментов с тегами ошибок и полем исправления. Для работы с наложениями и перебиваниями voice_interaction даёт двухдорожечный таймлайн. Оба читают те же файлы.
Как разметчики назначают говорящих?
Задайте список, чтобы говорящие получали устойчивые имена, цвета и стороны:
display_options:
  allow_speaker_assignment: auto
  speakers:
    - id: interviewer
      name: "Interviewer"
      color: "#7c3aed"
      side: left
    - id: participant
      name: "Participant"
      color: "#059669"
      side: right
auto включает выбор говорящего, когда есть недиаризованные реплики. Поставьте true, чтобы разрешить переназначение даже там, где источник говорящих разметил, — это нужно, если вы исправляете ошибки диаризации, а не заполняете пустоты.
Назначения сохраняются вместе с разметкой, привязанные к устойчивому идентификатору реплики, так что переживают перезагрузку страницы.
Как выгрузить разметку обратно?
Экспорт в JSON, JSONL и CSV работает как обычно. Когда временное выравнивание должно сохраниться, выгружайте многоуровневую разметку в ELAN EAF или Praat TextGrid:
python -m potato.export --config config.yaml --format eaf --output ./out/
python -m potato.export --config config.yaml --format textgrid --output ./out/
Оба формата ходят в обе стороны. Potato читает EAF и TextGrid и на вход, так что можно размечать в Potato, доводить в ELAN или Praat и читать результат обратно.
Что почитать дальше
- Форматы расшифровок — все поддерживаемые форматы и как они определяются
- Разметка субтитров YouTube — версия этого процесса для файлов субтитров
- Разметка аудио — работа с осциллограммой, когда расшифровки нет
- Приём форматов расшифровок — запускаемый пример из галереи с шестью форматами рядом
- Диаризация говорящих — запускаемый пример из галереи
- Согласованность разметчиков — измерение согласованности по меткам на уровне реплик