Разметка спанов
Выделяйте и размечайте фрагменты текста в Potato для распознавания именованных сущностей, с цветами для каждой метки, горячими клавишами, подсказками и разрывными спанами.
Разметка спанов позволяет разметчикам выделять и помечать части текста. Именно так в Potato строятся задачи распознавания именованных сущностей (NER), частеречной разметки и выделения текста. Метку записывают либо простой строкой, либо объектом с собственными color, key_value и tooltip. Potato читает эти три поля как свойства каждой метки, поэтому словари colors, key_values или tooltips на уровне схемы на схему спанов никак не влияют.
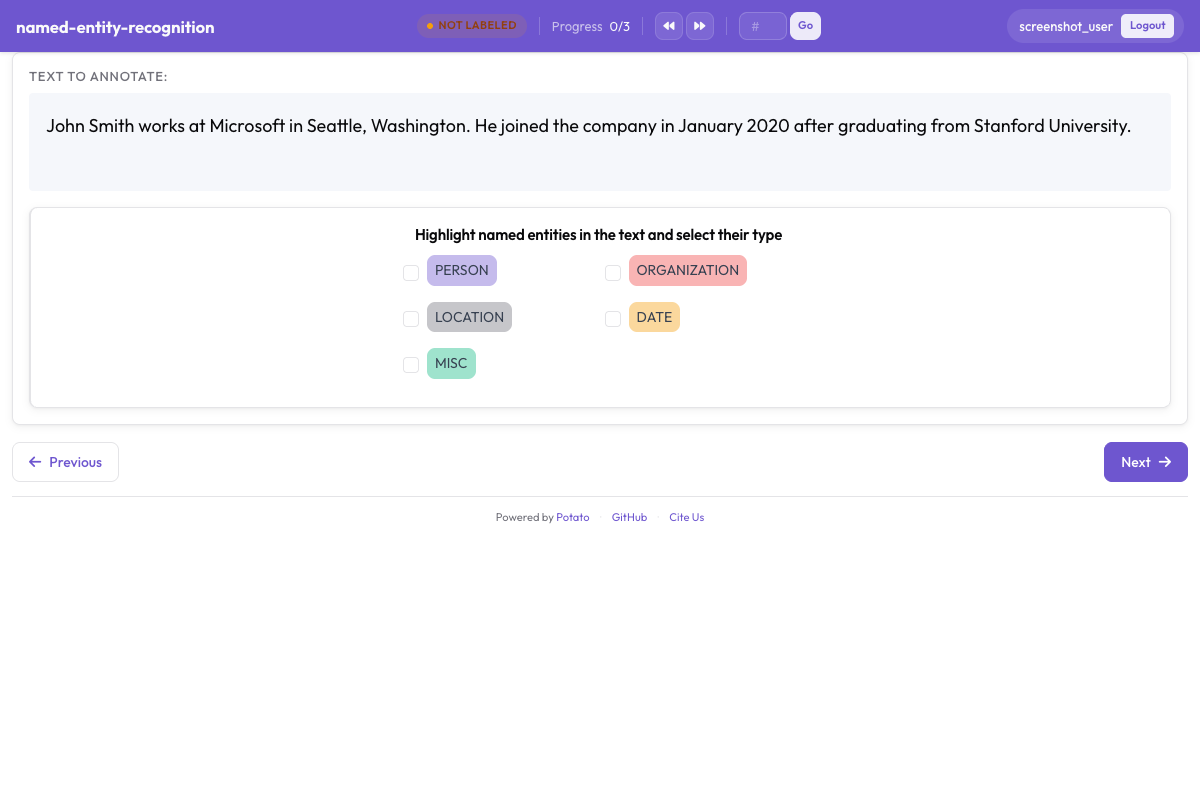 Разметка спанов в Potato с метками сущностей, различающимися по цвету
Базовая конфигурация
annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Highlight named entities in the text"
    labels:
      - PERSON
      - ORGANIZATION
      - LOCATION
description обязателен в каждой схеме и отображается над кнопками меток как задание, которое читает разметчик. Поэтому в нём стоит сформулировать само решение о разметке, а не повторять название схемы. Метки, записанные простыми строками, получают цвета из палитры Potato в том порядке, в котором они перечислены.
Параметры конфигурации
Метки сущностей
Набор меток служит главным проектным решением в задаче на спаны, потому что полнота, согласованность и все последующие измерения определяются относительно него. Держите его достаточно маленьким, чтобы разметчики помнили его, не заглядывая в инструкцию на каждом спане. На практике для большинства задач NER это от четырёх до восьми типов. Добавьте метки в схему выше:
labels:
  - PERSON
  - ORGANIZATION
  - LOCATION
  - DATE
  - EVENT
Цвета
Potato назначает каждой метке цвет палитры в порядке списка, поэтому выписывать цвета имеет смысл, только когда важна конкретная пара, например два типа, которые часто встречаются в одном предложении и не должны легко путаться с первого взгляда. Цвет относится к метке:
annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Highlight named entities in the text"
    labels:
      - name: PERSON
        color: "#3b82f6"
      - name: ORGANIZATION
        color: "#10b981"
      - name: LOCATION
        color: "#f59e0b"
      - DATE
Значения задаются в hex (#3b82f6) или как rgb(255, 0, 0). Метка, оставленная простой строкой, как DATE выше, получает следующий цвет палитры, так что в схеме можно задать цвета только тем меткам, которым они нужны, а остальные не трогать.
Цвета для нескольких схем можно также задать в одном месте, в ui.label_colors, с ключами сначала по имени схемы, затем по метке:
ui:
  label_colors:
    entities:
      PERSON: "#3b82f6"
      ORGANIZATION: "#10b981"
Словарь colors:, записанный прямо в схеме, не является ключом, который читает Potato. Схема с таким словарём отображается цветами палитры, как будто этого блока нет.
Горячие клавиши
Горячие клавиши стоит включать в любой задаче на спаны, где больше двух меток, потому что разметчик, который для каждого спана тянется мышью к кнопке, работает в разы медленнее того, кто держит обе руки на тексте. Настройка sequential_key_binding: true назначает меткам клавиши в порядке их перечисления:
- annotation_type: span
  name: entities
  description: "Highlight named entities in the text"
  labels:
    - PERSON
    - ORGANIZATION
    - LOCATION
    - DATE
  sequential_key_binding: true
Если на странице задачи несколько схем, Potato выделяет каждой клавиши из отдельного пула. Сначала берётся цифровой ряд, затем верхний буквенный ряд, затем основной ряд, поэтому горячие клавиши разных схем никогда не пересекаются.
Чтобы закрепить метку за конкретной клавишей, а не за её позицией в списке, задайте метке key_value. Распределитель учитывает явный key_value прежде, чем назначать что-либо автоматически, а мнемонические клавиши сохраняются при последующей перестановке списка меток, чего не скажешь о позиционных:
- annotation_type: span
  name: entities
  description: "Highlight named entities in the text"
  labels:
    - name: PERSON
      key_value: "p"
    - name: ORGANIZATION
      key_value: "o"
    - LOCATION
  sequential_key_binding: true
Словарь key_values: на уровне схемы не читается, как и словарь, записанный в качестве значения sequential_key_binding, который Potato воспринимает только как флаг.
Подсказки
Пограничным случаям метки место в подсказке, чтобы разметчик мог проверить, что считается ORGANIZATION, не покидая задачу. Подсказки задаются как свойства каждой метки:
- annotation_type: span
  name: entities
  description: "Highlight named entities in the text"
  labels:
    - name: PERSON
      tooltip: "Names of people, characters, or personas"
    - name: ORGANIZATION
      tooltip: "Companies, agencies, institutions"
    - name: LOCATION
      tooltip_file: "config/tooltips/location.html"
tooltip принимает простой текст, а tooltip_file принимает путь к HTML-файлу. Второй вариант лучше, когда в пояснении нужны примеры, полужирный текст или список. Словарь tooltips: на уровне схемы читает только hierarchical_multiselect, а в схеме спанов он ничего не делает.
Перекрывающиеся спаны
Разрешить перекрытия
Спаны могут перекрываться, и никакой настройки для включения этого поведения нет. Перекрытие нужно, когда один и тот же фрагмент текста несёт сразу две метки, как «Dr. Smith», который одновременно PERSON и ROLE. Начиная с версии 2.9.0 принимается и выделение, которое начинается в конце существующего спана или заканчивается в его начале, поэтому можно создавать частично перекрывающиеся спаны; более ранние версии такое выделение отклоняли.
Запретить перекрытия (по умолчанию)
В схеме спанов нет ключа, запрещающего перекрытия, поэтому задача, в которой спаны не должны перекрываться, должна оговорить это в инструкции по разметке. Если различие важно не для разметчика, а для экспорта, две схемы спанов разделяют наборы меток, поскольку каждая схема хранит свои спаны под собственным именем:
annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Label named entities"
    labels:
      - PERSON
      - ORGANIZATION

  - annotation_type: span
    name: roles
    description: "Label professional roles"
    labels:
      - ROLE
Режимы выделения спанов
Potato хранит каждый спан как смещения в символах внутри текста элемента, и ни один ключ конфигурации не переключает выделение между словами и символами. Два режима ниже описывают то, что может делать разметчик, а не настройки, которые нужно включать.
Выделение по словам
На практике большая часть работы по NER сводится к протягиванию выделения через целые слова, а результат сохраняется как смещения первого и последнего выделенного символа. Ничто в конфигурации не заставляет соблюдать границы слов, поэтому если для ваших данных важны спаны из целых слов, запишите это требование в инструкцию и проверяйте его по экспорту, а не рассчитывайте, что интерфейс отклонит часть слова.
Выделение по символам
Выделить часть слова можно всегда, без какой-либо настройки, и на это опираются задачи морфологической и субтокенной разметки. Перед отображением Potato схлопывает последовательности пробелов и табуляций, чтобы сохраняемые смещения совпадали с тем, что измеряет браузер, и это важно, если в вашем тексте есть значимые отступы. Если горизонтальные пробелы нужно сохранить в точности, объявите instance_display.
Предразмеченные спаны
Если заполнить задачу выводом модели, разметка превращается в исправление, а это более быстрый процесс, когда модель уже права на большей части корпуса. Potato читает начальную разметку из поля каждого элемента, имя которого задаёт pre_annotation.field:
pre_annotation:
  enabled: true
  field: "predictions"
  allow_modification: true
  show_confidence: true
  highlight_low_confidence: 0.7
Именно allow_modification: true делает задачу исправлением, а не проверкой, поскольку без него разметчики не могут изменить то, что предложила модель. highlight_low_confidence: 0.7 отмечает элементы, в которых модель была меньше всего уверена, чтобы внимание доставалось спанам, которые с наибольшей вероятностью ошибочны.
Поле содержит по одной записи на имя схемы, а схема спанов принимает список смещений:
{
  "id": "item_002",
  "text": "Apple announced new iPhone in California.",
  "predictions": {
    "entities": [
      {"start": 0, "end": 5, "label": "ORG", "confidence": 0.85},
      {"start": 27, "end": 37, "label": "LOC", "confidence": 0.91}
    ]
  }
}
Предразметка служит отправной точкой, а не разметкой, поэтому элемент, который никто не открыл, экспортируется пустым, даже если он пришёл с предсказаниями.
Типовые конфигурации NER
Стандартный NER (4 типа)
Набор из четырёх типов следует соглашению CoNLL-2003, и это правильный выбор, когда ваши результаты должны быть сопоставимы с опубликованными показателями NER:
- annotation_type: span
  name: ner
  description: "Label named entities"
  labels:
    - PER    # Person
    - ORG    # Organization
    - LOC    # Location
    - MISC   # Miscellaneous
  sequential_key_binding: true
Расширенный NER (в стиле OntoNotes)
Восемнадцать типов дают более тонкие различия ценой реальной потери согласованности, поскольку именно на границах между NORP, ORG и GPE разметчики расходятся сильнее всего. Используйте расширенный набор, когда различия нужны для последующей работы, и закладывайте больше времени на обучение:
- annotation_type: span
  name: ner_extended
  description: "Label named entities using the OntoNotes type set"
  labels:
    - PERSON
    - NORP        # Nationalities, religious/political groups
    - FAC         # Facilities
    - ORG
    - GPE         # Geopolitical entities
    - LOC
    - PRODUCT
    - EVENT
    - WORK_OF_ART
    - LAW
    - LANGUAGE
    - DATE
    - TIME
    - PERCENT
    - MONEY
    - QUANTITY
    - ORDINAL
    - CARDINAL
Биомедицинский NER
Биомедицинские спаны длинные и часто вложенные, поэтому подсказки с разобранным примером для каждого типа окупаются здесь сильнее, чем в задаче общего домена:
- annotation_type: span
  name: bio_ner
  description: "Label biomedical entities"
  labels:
    - GENE
    - PROTEIN
    - DISEASE
    - DRUG
    - SPECIES
NER для соцсетей
Тексты из соцсетей приносят типы сущностей, для которых в наборах для новостных текстов нет места, и CREATIVE_WORK и GROUP чаще всего ошибочно попадают в ORG, если у них нет собственной метки:
- annotation_type: span
  name: social_ner
  description: "Label named entities in social media text"
  labels:
    - PERSON
    - ORGANIZATION
    - LOCATION
    - PRODUCT
    - CREATIVE_WORK
    - GROUP
Спаны с атрибутами
Вторая схема рядом со схемой спанов собирает суждение об элементе в целом. Potato хранит их раздельно, поэтому ответ в radio относится ко всему документу, а не к какому-то одному спану:
annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Highlight named entities"
    labels:
      - PERSON
      - ORGANIZATION

  - annotation_type: radio
    name: entity_type
    description: "What type of entity is this?"
    labels:
      - Named
      - Nominal
      - Pronominal
Несколько схем спанов
Две схемы спанов позволяют размечать разные аспекты одного текста, не заставляя разметчиков держать в голове один объединённый набор меток. Каждая схема получает собственный ряд кнопок, собственный пул клавиш и собственное поле в экспорте:
annotation_schemes:
  # Named entities
  - annotation_type: span
    name: entities
    description: "Label named entities"
    labels:
      - PERSON
      - ORGANIZATION
      - LOCATION

  # Sentiment expressions
  - annotation_type: span
    name: sentiment_spans
    description: "Highlight sentiment expressions"
    labels:
      - POSITIVE
      - NEGATIVE
Разметка спанов по нескольким полям
Появилось в v2.1.0
Разметка спанов может нацеливаться на конкретное текстовое поле в многополевых данных через параметр target_field. Это нужно, когда элемент содержит исходный документ и его краткое изложение, а спан относится к одному из них.
Конфигурация
Каждая схема указывает поле, которое она размечает, поэтому два набора меток остаются привязанными к нужному тексту:
annotation_schemes:
  - annotation_type: span
    name: source_entities
    description: "Label entities in the source text"
    target_field: source_text
    labels:
      - PERSON
      - ORGANIZATION

  - annotation_type: span
    name: summary_entities
    description: "Label entities in the summary"
    target_field: summary
    labels:
      - PERSON
      - ORGANIZATION
Формат многополевых данных
В данных должны быть отдельные текстовые поля:
{
  "id": "doc1",
  "source_text": "John Smith works at Microsoft in Seattle.",
  "summary": "Smith is employed by Microsoft."
}
Формат вывода
При использовании target_field разметка группируется по полям:
{
  "id": "doc1",
  "source_entities": {
    "source_text": [
      {"start": 0, "end": 10, "text": "John Smith", "label": "PERSON"},
      {"start": 20, "end": 29, "text": "Microsoft", "label": "ORGANIZATION"}
    ]
  },
  "summary_entities": {
    "summary": [
      {"start": 0, "end": 5, "text": "Smith", "label": "PERSON"},
      {"start": 22, "end": 31, "text": "Microsoft", "label": "ORGANIZATION"}
    ]
  }
}
Полный рабочий пример находится в project-hub/simple_examples/simple-multi-span/ в репозитории Potato.
Параметры отображения
Показывать метку в спане
По умолчанию Potato выводит метку внутри каждого выделенного спана. В плотном документе с множеством коротких спанов текст меток загромождает предложение, и show_span_labels: false сохраняет текст читаемым, а метку по-прежнему передаёт цвет выделения:
- annotation_type: span
  name: entities
  description: "Highlight named entities in the text"
  labels:
    - PERSON
    - ORGANIZATION
  show_span_labels: false
Подчёркивание
В схеме спанов нет ключа для стиля выделения, и спаны всегда отображаются цветной заливкой фона. Подчёркивание и скобки доступны как параметры типа кореференции через visual_display.highlight_mode, поэтому задаче, которой нужно одно из них, следует использовать цепочки кореференции.
Формат вывода
Разметка спанов сохраняется со смещениями в символах:
{
  "id": "doc1",
  "entities": [
    {
      "start": 0,
      "end": 10,
      "text": "John Smith",
      "label": "PERSON"
    },
    {
      "start": 20,
      "end": 29,
      "text": "Microsoft",
      "label": "ORGANIZATION"
    }
  ]
}
Полный пример: задача NER
item_properties называет поля, которые Potato читает как идентификатор элемента и его текст, и без этого блока конфигурация не запустится. Пять типов сущностей получают клавиши из цифрового ряда через sequential_key_binding, а завершающая схема radio фиксирует оценку сложности, которая потом помогает объяснить, где упала согласованность:
annotation_task_name: "Named Entity Recognition"

data_files:
  - data/documents.json

item_properties:
  id_key: id
  text_key: text

annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Highlight and label all named entities"
    labels:
      - PERSON
      - ORGANIZATION
      - LOCATION
      - DATE
      - MONEY
    sequential_key_binding: true
    allow_discontinuous: false

  - annotation_type: radio
    name: difficulty
    description: "How difficult was this document to annotate?"
    labels:
      - Easy
      - Medium
      - Hard

output_annotation_dir: annotation_output
export_annotation_format: jsonl
Разрывные спаны
Появилось в v2.2.0
allow_discontinuous: true позволяет разметчику выделить несколько несмежных фрагментов текста и записать их как один спан, что нужно для расщеплённых антецедентов и разрывных составляющих. Разрывность и перекрытие это разные вещи, и этот ключ никак не влияет на то, могут ли два спана покрывать одни и те же символы:
- annotation_type: span
  name: entities
  description: "Highlight named entities in the text"
  labels:
    - PERSON
    - ORGANIZATION
  allow_discontinuous: true
Когда параметр включён, разметчик удерживает Ctrl в Windows и Linux или Cmd на Mac, выделяя дополнительный текст, чтобы добавить его к текущему спану. В выводе для каждого фрагмента есть своя пара начала и конца.
Интеграция со связыванием сущностей
Появилось в v2.2.0
Разметку спанов можно связывать с внешними базами знаний (Wikidata, UMLS или собственные REST API), добавив в схему спанов блок entity_linking. Лишний шаг на каждый спан оправдан, когда у двух сущностей совпадает поверхностная форма и одной метки недостаточно, чтобы их различить:
- annotation_type: span
  name: entities
  description: "Highlight and link named entities"
  labels:
    - PERSON
    - ORGANIZATION
    - LOCATION
  entity_linking:
    enabled: true
    knowledge_bases:
      - name: wikidata
        type: wikidata
        language: en
    auto_search: true
    required: false
auto_search: true запускает поиск сразу после создания спана, что экономит клик в задачах, где связывают большинство спанов. required: true не даёт сохранить спан без связи, поэтому не включайте его, если только не ожидается, что каждая сущность в ваших данных есть в базе знаний. Когда связывание сущностей включено, на панели управления каждого спана появляется значок ссылки, и клик по нему открывает окно поиска. Подробности смотрите в документации по связыванию сущностей.
Рекомендации
- Задавайте цвета тем меткам, которым они нужны, а остальное оставьте палитре
- Выносите пограничные случаи в
tooltipилиtooltip_file, по одному на метку, а не в описание схемы - Включайте
sequential_key_bindingв любой схеме, где больше двух меток, и добавляйтеkey_valueтам, где помогает мнемоническая клавиша - Определите политику перекрытий в инструкции, поскольку схема её не обеспечивает
- Заполняйте задачу через
pre_annotationдля процессов исправления и оставляйтеallow_modification: true - Держите набор меток маленьким, а несвязанные аспекты разносите по отдельным схемам спанов
Что почитать дальше
- Связывание сущностей - привязка спанов к базам знаний
- Цепочки кореференции - объединение кореферентных упоминаний
- Разметка событий - n-арные структуры событий с аргументами-спанами
- Связывание спанов - отношения между спанами
- Отображение объектов - вывод многополевого содержимого с целями для спанов
- Настройка интерфейса - цвета спанов
- Возможности для продуктивности - горячие клавиши
Детали реализации описаны в исходной документации.