Come raccogliere dati di process reward per addestrare coding agent migliori
Raccogli etichette di reward per singolo passo per l'addestramento di PRM in Potato, con le modalità primo errore e passo per passo e uno script che prepara l'esportazione per l'addestramento.
Che cosa sono i process reward model?
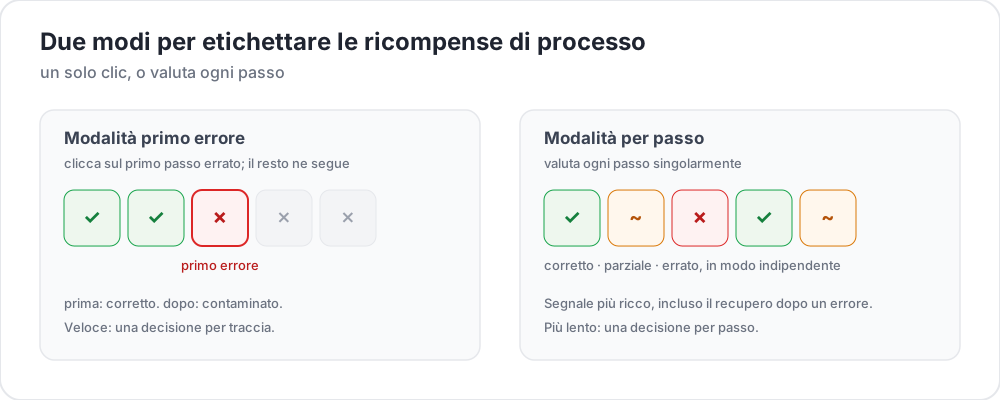 Due modi di etichettare i process reward
Gli outcome reward model guardano solo alla fine della traiettoria di un coding agent: il codice è stato compilato, i test sono passati, il problema è stato risolto? I process reward model, invece, assegnano un punteggio a ogni passo intermedio. Con un segnale a ogni passo, l'addestramento può individuare il punto in cui un agente ha sbagliato.
Lavori recenti hanno spinto in questa direzione. AgentPRM ridefinisce i process reward per i compiti degli agenti, valutando ogni azione in base al progresso che compie verso l'obiettivo invece che in base alla sua correttezza, e riporta un'efficienza di calcolo oltre 8× migliore rispetto alle baseline con cui si confronta. ToolRM ha rilevato che i reward model addestrati su output in linguaggio naturale giudicano male le chiamate agli strumenti, e ha costruito reward model specifici per gli strumenti insieme a FC-RewardBench per valutarli. Per contrasto, DeepSWE addestra un coding agent con una sola reward di esito sparsa, cioè se i test passano, e raggiunge il 42,2% di Pass@1 e il 59% con lo scaling al momento del test su SWE-bench Verified. È questa impostazione basata solo sull'esito che la supervisione di processo cerca di migliorare.
Tutti questi lavori hanno bisogno di annotazione umana a livello di passo, ed è di solito lì il collo di bottiglia. Per il riferimento dello schema, consulta la documentazione sul process reward.
Due modalità di annotazione
Modalità primo errore
L'annotatore legge la traiettoria dall'alto in basso e clicca il primo passo in cui l'agente sbaglia. Tutti i passi precedenti vengono registrati come corretti, e quel passo e tutti i successivi come sbagliati. È veloce perché c'è una sola decisione per traccia, e si adatta al caso comune in cui un agente che esce di strada non si riprende.
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent makes a mistake. Steps after it are flagged automatically."
    mode: first_error
    steps_key: structured_turns
    step_text_key: content
Modalità passo per passo
Ogni passo riceve una propria etichetta, e questo cattura ciò che la modalità primo errore non può cogliere: un recupero parziale, una deviazione innocua o un passo che da solo va bene ma è sbagliato nel suo contesto. allow_neutral aggiunge la terza opzione in stile PRM800K.
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Rate each step correct, neutral, or incorrect"
    mode: per_step
    steps_key: structured_turns
    step_text_key: content
    allow_neutral: true
    inline_with_trace: true
inline_with_trace aggancia i controlli a ogni passo nella visualizzazione, il che conta su una traccia lunga, dove un pannello separato fa perdere all'annotatore il punto in cui era arrivato.
Impostare il progetto
Passo 1: prepara le tracce
Ogni riga è una traiettoria. steps_key indica la lista dei passi e step_text_key indica il campo di ciascun passo da mostrare:
{
  "id": "trace_001",
  "issue_description": "Fix the TypeError in parse_config() when the config file is empty",
  "structured_turns": [
    {"step_idx": 0, "type": "thinking", "content": "I need to find where the TypeError occurs. Let me read the file."},
    {"step_idx": 1, "type": "file_read", "content": "def parse_config(path):\n    with open(path) as f:\n        data = json.load(f)\n    return data['settings']"},
    {"step_idx": 2, "type": "thinking", "content": "When the file is empty json.load returns None, so None['settings'] raises. Add a check."},
    {"step_idx": 3, "type": "file_edit", "content": "+    if data is None:\n+        return {}"},
    {"step_idx": 4, "type": "bash_command", "content": "python -m pytest tests/test_config.py -v  ->  2 passed"}
  ]
}
La conversione da un altro formato di agente è un passaggio da CLI:
python -m potato.trace_converter \
  --input claude_code_sessions.json \
  --input-format claude_code \
  --output data/traces.jsonl
--list-formats stampa i formati supportati, tra cui claude_code, aider, swe_agent_trajectory, swebench, react, langchain e altri nove. Usa --auto-detect quando non sei sicuro di quale formato hai.
Passo 2: scrivi la configurazione
annotation_task_name: "PRM Data Collection"
task_dir: "."

data_files:
  - "data/traces.jsonl"

item_properties:
  id_key: id
  text_key: issue_description

instance_display:
  fields:
    - key: issue_description
      type: text
      label: "Issue"

    - key: structured_turns
      type: coding_trace
      label: "Agent trajectory"
      display_options:
        diff_view: unified
        show_file_tree: true
        show_reasoning: true
        terminal_theme: dark
        collapse_long_outputs: true
        max_output_lines: 50

annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent makes an error"
    mode: first_error
    steps_key: structured_turns
    step_text_key: content

  - annotation_type: radio
    name: outcome
    description: "Did the agent resolve the issue?"
    labels:
      - name: resolved
        text: "Fully resolved"
      - name: partial
        text: "Partially resolved"
      - name: not_resolved
        text: "Not resolved"

  - annotation_type: text
    name: error_description
    description: "If the trajectory went wrong, describe the error briefly"
    rows: 3
    placeholder: "e.g. edited the wrong file"
    label_requirement:
      required: false

num_annotators_per_item: 2

attention_checks:
  enabled: true
  items_file: "data/attention_checks.json"
  frequency: 20
  min_response_time: 20.0
  failure_handling:
    warn_threshold: 2
    block_threshold: 5

user_config:
  allow_all_users: false
  users:
    - reviewer1@example.com
    - reviewer2@example.com
    - reviewer3@example.com

output_annotation_dir: "annotation_output/"
export_annotation_format: jsonl
Un oggetto etichetta è identificato da name. Il campo text è ciò che l'annotatore legge, quindi il valore memorizzato resta un identificatore stabile mentre la formulazione può cambiare.
min_response_time: 20.0 è il controllo utile qui. Nessuno legge in venti secondi una traiettoria di più passi con dei diff, quindi intercetta la fretta che un limite di tempo per traccia non rileverebbe.
Passo 3: avvia il server
potato start config.yaml -p 8000Esportare per l'addestramento
L'esportatore coding_eval scrive direttamente i formati di addestramento, quindi la preparazione dei dati è già fatta:
python -m potato.export -c config.yaml -f coding_eval -o ./export/Scrive prm_training_data.jsonl con le etichette a livello di passo, preference_pairs.jsonl con tracce scelte e scartate in stile DPO costruite a partire dalle annotazioni, swebench_results.jsonl e code_reviews.jsonl. Tutti e quattro vengono scritti per impostazione predefinita. Per restringere l'output, passa l'opzione types dell'esportatore: --option types=prm,preference. Quando un tipo richiesto non trova dati nello studio, lo segnala invece di scrivere un file vuoto.
L'annotazione viene salvata sotto il nome dello schema come una lista steps più la modalità. reward vale 1 per corretto, -1 per sbagliato, 0 per neutro e null per un passo che nessuno ha giudicato:
{
  "step_rewards": {
    "mode": "first_error",
    "steps": [
      {"reward": 1, "source": "human", "verified": true},
      {"reward": 1, "source": "human", "verified": true},
      {"reward": -1, "source": "human", "verified": true},
      {"reward": -1, "source": "human", "verified": true}
    ]
  }
}
Ricorri a uno script solo quando ti serve una forma che l'esportatore non scrive. Il motivo abituale è gestire da sé i passi non giudicati, dato che un passo che nessuno ha giudicato vale null e non 0:
import json
from pathlib import Path

SCHEME = "step_rewards"

examples = []
for f in Path("export/").rglob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            rec = json.loads(line)
            payload = (rec.get("labels", rec) or {}).get(SCHEME)
            if not payload:
                continue

            steps = payload.get("steps", [])
            # Drop traces with unjudged steps rather than guessing at them.
            if any(s.get("reward") is None for s in steps):
                continue

            item = items_by_id[rec["instance_id"]]      # your own data file
            examples.append({
                "trace_id": rec["instance_id"],
                "prompt": item["issue_description"],
                "steps": [
                    {"content": src["content"], "label": s["reward"]}
                    for src, s in zip(item["structured_turns"], steps)
                ],
            })

with open("prm_labels.jsonl", "w") as out:
    for ex in examples:
        out.write(json.dumps(ex) + "\n")

print(f"Wrote {len(examples)} traces")
Le coppie di preferenza derivano dalle stesse annotazioni. Quando due tracce hanno affrontato lo stesso problema, l'esportatore le accoppia e considera traccia scelta quella il cui primo errore arriva più tardi, o che non ne ha nessuno.
Analisi
Dove cade il primo errore
import json
from pathlib import Path

SCHEME = "step_rewards"

traces = []
for f in Path("export/").rglob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            payload = (json.loads(line).get("labels", {}) or {}).get(SCHEME)
            if payload:
                traces.append(payload)

positions = []
all_correct = 0
for t in traces:
    steps = t.get("steps", [])
    first = next((i for i, s in enumerate(steps) if s.get("reward") == -1), None)
    if first is None:
        all_correct += 1
    elif len(steps) > 1:
        positions.append(first / (len(steps) - 1))

print(f"Traces annotated: {len(traces)}")
print(f"No errors: {all_correct} ({all_correct / len(traces):.1%})")
if positions:
    print(f"Average first-error position: {sum(positions) / len(positions):.2f} (0=start, 1=end)")
Accordo sul primo errore
Due annotatori scelgono di rado lo stesso passo, e l'accordo esatto sottostima quanto siano d'accordo. Raggruppare prima la posizione in fasce dà un confronto più informativo:
def bin_position(steps):
    first = next((i for i, s in enumerate(steps) if s.get("reward") == -1), None)
    if first is None:
        return "all_correct"
    return "early_error" if first < len(steps) / 2 else "late_error"
Confronta queste fasce tra gli annotatori che condividono degli item, usando la sovrapposizione che ti dà num_annotators_per_item.
Consigli
Usa la modalità primo errore per la velocità. Per addestrare un PRM che guidi la ricerca, fornisce abbastanza segnale a una frazione del costo di annotazione, e comunque la maggior parte degli agenti fallisce a cascata.
Usa la modalità passo per passo quando ti serve il dettaglio. Il recupero parziale e le deviazioni innocue esistono come etichette solo nella modalità passo per passo.
Parti con annotatori esperti. Il lavoro richiede di leggere codice, diff e output del terminale. Inizia con un gruppo piccolo, misura l'accordo, calibra su esempi condivisi e poi scala.
Imposta un tempo minimo di risposta. Le traiettorie si allungano, e una soglia minima impedisce agli annotatori di scorrere i diff di corsa.
Fai un giro di calibrazione. Fai etichettare a tutti le stesse dieci-venti tracce e discutete i disaccordi prima che inizi l'annotazione di produzione.