Potato a confronto con LangSmith e Langfuse per la valutazione degli agenti: un confronto pratico
Per cosa sono pensati LangSmith, Langfuse e Potato nella valutazione degli agenti, come spostare le tracce dall'uno all'altro e dove si misura il giudizio umano.
LangSmith e Langfuse sono pensati per tracciare e monitorare applicazioni LLM in produzione. Potato è pensato per raccogliere giudizi umani strutturati su ciò che quelle tracce mostrano e per misurare quanto chi giudica sia d'accordo. I team che hanno bisogno di entrambe le cose di solito catturano i dati in uno strumento di osservabilità e conducono lo studio umano in Potato.
I tre strumenti si sovrappongono abbastanza da far nascere spesso il confronto, e si sovrappongono in un punto solo. Tutti e tre possono associare un giudizio umano a un'esecuzione registrata di un agente. Ciò attorno a cui sono organizzati è diverso, e questa differenza decide quale si adatta alla domanda che vi state ponendo.
Per cosa è pensato ciascuno strumento
LangSmith strumenta, traccia ed esegue il debug di applicazioni LLM, con l'integrazione più profonda in LangChain e LangGraph. Le tracce di un'applicazione costruita su quei framework arrivano senza strumentazione aggiuntiva, e la piattaforma è organizzata attorno all'ispezione delle esecuzioni, al monitoraggio di latenza e costi e all'esecuzione di esperimenti di valutazione su dataset. Le sue code di annotazione supportano chiavi di feedback con rubrica, un numero configurabile di revisori per esecuzione, code a coppie e revisori che non possono vedere il feedback degli altri.
Langfuse copre lo stesso terreno come open source, per qualsiasi applicazione LLM invece che per un solo framework, e affianca al tracciamento la gestione dei prompt. Il punteggio è disponibile a livello di traccia e a livello di osservazione (span), e le sue score config categoriali permettono di definire un insieme fisso di etichette e di associare più punteggi con nome a uno stesso span.
Potato è una piattaforma di annotazione che è stata estesa alle tracce degli agenti. È organizzata attorno allo studio invece che all'applicazione, quindi le sue primitive sono chi annota cosa, quante persone vedono ogni item, cosa succede quando non sono d'accordo e cosa dicono le statistiche di accordo sul fatto che le etichette significhino qualcosa. Le tracce degli agenti sono un tipo di item fra i 61 tipi di annotazione che la release attuale registra, ed è per questo che ereditano l'accordo tra annotatori, le fasi di addestramento, l'aggiudicazione e il crowdsourcing senza che nulla di tutto ciò sia stato ricostruito per gli agenti.
Nessuno dei tre è migliore in astratto. La domanda utile è se il vostro collo di bottiglia sia vedere cosa ha fatto l'agente o potersi fidare delle etichette umane che state raccogliendo su di esso.
Spostare le tracce tra gli strumenti
Potato legge le tracce a posteriori invece di strumentare il vostro codice, quindi registra convertitori per 15 formati di traccia:
python -m potato.trace_converter --list-formatsL'elenco comprende react, openai, anthropic, langchain, langfuse, multi_agent, mcp, otel, atif, webarena, web_agent, swebench, swe_agent_trajectory, claude_code e aider. Le esportazioni delle esecuzioni di LangSmith passano per il convertitore langchain, dato che non ne esiste uno langsmith separato. I log di CrewAI, AutoGen e LangGraph passano per multi_agent.
Convertire un'esportazione richiede un solo comando in ciascuna direzione del flusso di lavoro:
# LangSmith runs, exported from LangSmith, converted for annotation
python -m potato.trace_converter \
  --input langsmith_export.jsonl \
  --output data/traces.jsonl \
  --input-format langchain

# Langfuse traces, exported from Langfuse
python -m potato.trace_converter \
  --input langfuse_traces.json \
  --output data/traces.jsonl \
  --input-format langfuse
Se il vostro framework non è nell'elenco, --auto-detect sceglie un convertitore in base alle firme dei campi, e un convertitore nuovo è una sottoclasse di BaseTraceConverter. Il rilevamento prende il primo convertitore che corrisponde, quindi indicate il formato in modo esplicito una volta capito quale si adatta ai vostri file.
Le tracce possono anche arrivare senza un passaggio di esportazione. L'ingestione di tracce di Potato accetta esecuzioni inviate a /api/traces/* nel formato di payload delle esecuzioni di LangSmith, così una callback di LangChain o l'SDK di tracciamento possono spingere le esecuzioni nella coda di annotazione mentre avvengono:
trace_ingestion:
  enabled: true
  api_key: "your-api-key"
  notify_annotators: true
Cosa aggiunge Potato una volta importata la traccia
Gli schemi sono il punto in cui una piattaforma di annotazione si guadagna il suo posto. trajectory_eval contiene l'etichetta di correttezza, una tassonomia gerarchica degli errori con sottotipi, livelli di gravità con pesi configurabili e un punteggio di qualità progressivo, in un solo schema associato a una sola traccia:
annotation_schemes:
  - annotation_type: trajectory_eval
    name: step_evaluation
    description: "Mark each step and classify anything that went wrong"
    steps_key: conversation
    step_text_key: text
    error_types:
      - name: execution
        subtypes: [wrong_tool, wrong_args, api_error]
    severities:
      - name: minor
        weight: -1
      - name: critical
        weight: -10
    show_score: true
I pesi di gravità sono la parte che conta per confrontare le tracce. Un conteggio piatto dei passi marcati dice che un agente ha commesso quattro errori e un altro due, mentre il punteggio pesato dice se quei quattro erano cosmetici e quei due pericolosi.
La valutazione comparativa passa per lo schema pairwise, che ha tre modalità. La modalità binaria mostra due riquadri cliccabili con un pulsante di parità facoltativo, la modalità a scala sostituisce la scelta con uno slider fra i due item, e la modalità multi_dimension chiede un verdetto A/B indipendente per ogni dimensione con nome, come utilità, accuratezza e sicurezza.
Gli agenti di programmazione hanno una visualizzazione propria, perché un diff unificato letto come stringa JSON non è revisionabile:
 La visualizzazione delle tracce di programmazione di Potato con rendering dei diff unificati, evidenziazione della sintassi e albero dei file
La visualizzazione coding_trace mostra i diff con un albero dei file e comprime l'output lungo del terminale, e lo schema code_review raccoglie commenti ancorati alle righe in categorie configurabili, dimensioni di valutazione per file e un verdetto nello stile di una pull request. L'esportatore coding_eval scrive poi etichette per process reward model, annotazioni di revisione del codice, coppie di preferenza DPO e punteggi compatibili con SWE-bench, cioè la forma di cui hanno bisogno i dati di addestramento e non quella di cui ha bisogno una dashboard.
Le tracce degli agenti web vengono mostrate come screenshot con sovrapposizioni SVG delle azioni e una filmstrip:
 Visualizzatore di tracce di agenti web con screenshot, sovrapposizioni SVG delle azioni e navigazione a filmstrip
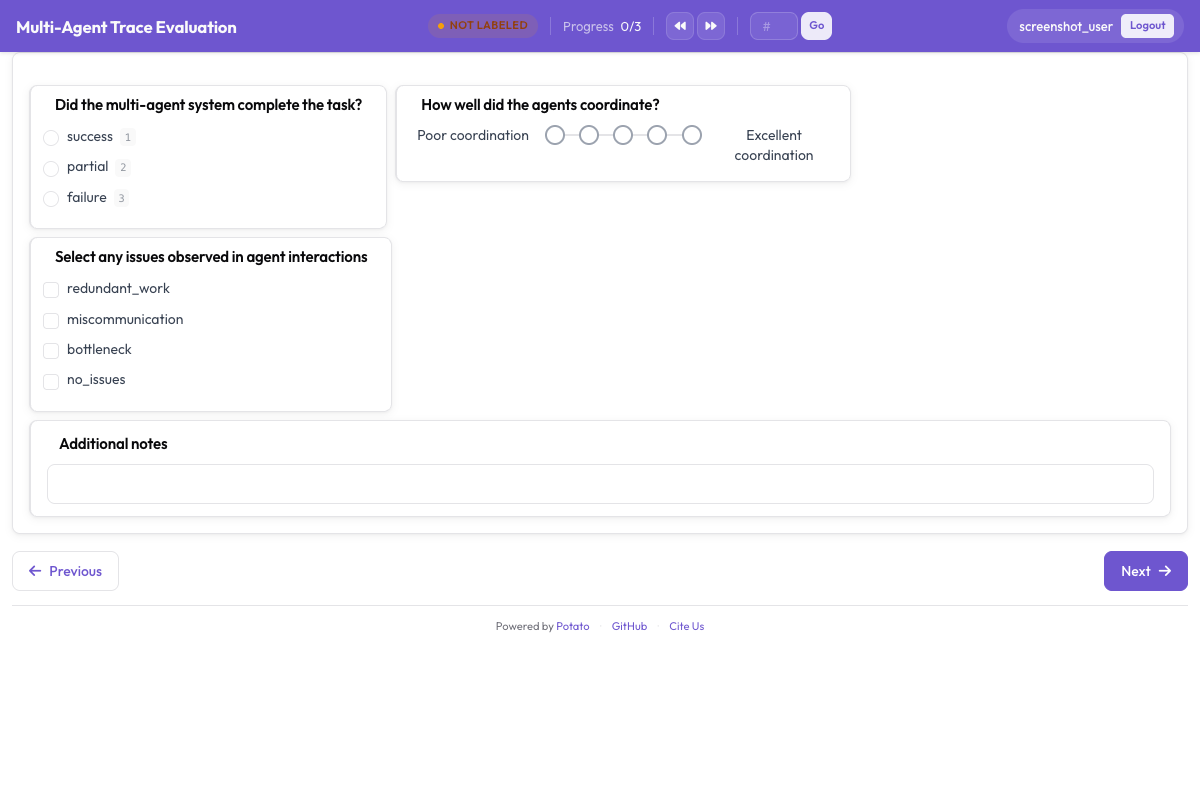
Le esecuzioni multi-agente hanno superfici di annotazione proprie invece di essere appiattite in un unico flusso di passi. Il registro contiene schemi per un grafo di interazione modificabile dall'annotatore, l'attribuzione dei fallimenti tra agenti, la revisione dei passaggi di consegne, schede di valutazione per agente e per team, la contesa degli strumenti su una timeline condivisa e l'etichettatura dei comportamenti emergenti. Lo stesso vale per gli agenti incarnati e multimodali, con traiettorie di uso del computer, interazione vocale full-duplex e ancoraggio temporale nei video come schemi a pieno titolo.
Misurare i giudizi, non solo raccoglierli
La differenza che emerge più tardi in un progetto è cosa succede dopo che due annotatori non sono d'accordo. Potato tratta un disaccordo come una misura e non come un conflitto da risolvere, quindi le stesse statistiche di accordo, la stessa coda di aggiudicazione, le stesse fasi di addestramento e gli stessi item di riferimento usati da uno studio di annotazione del testo si applicano alle tracce degli agenti senza configurazione aggiuntiva. Il confronto tra strumenti dello stesso Potato registra, alla verifica del 2026-06-24, che le piattaforme di tracciamento sono pensate per raccogliere i giudizi umani come punteggi e che nessuna documenta una statistica di affidabilità su quei giudizi, e che Langfuse sostituisce un'annotazione precedente sulla stessa traccia, per cui lì la doppia annotazione indipendente richiede un espediente.
Questo conta quando la valutazione è la prova. Un tasso di successo costruito da giudizi singoli non revisionati non ha barra d'errore, e un revisore che è andato alla deriva sembra esattamente un agente che è migliorato.
Osservare un agente mentre è in esecuzione
Potato può anche eseguire un agente dentro la pagina di annotazione invece di riprodurre una registrazione. Il blocco live_agent collega un modello di visione a un browser headless e trasmette la sessione all'annotatore, che può metterla in pausa, inviare istruzioni o prendere il controllo manuale:
live_agent:
  endpoint_type: anthropic_vision
  ai_config:
    model: claude-sonnet-4-20250514
    api_key: ${ANTHROPIC_API_KEY}
  max_steps: 30
  allow_takeover: true
  allow_instructions: true

instance_display:
  fields:
    - key: agent_trace
      type: live_agent
      label: "Live Agent Session"
      display_options:
        show_overlays: true
        show_filmstrip: true
Tre situazioni rendono conveniente questa configurazione rispetto alla revisione a posteriori. Fermare un'esecuzione prima di un'azione distruttiva è una misura di sicurezza che le tracce registrate non possono offrire. Una presa di controllo umana registrata a metà esecuzione diventa un dato di dimostrazione. E osservare come un agente si riprende da un intervento risponde a una domanda che nessuna traccia completata contiene.
Usarli insieme
La configurazione di produzione più comune li usa entrambi, e la divisione è netta perché gli strumenti vogliono cose diverse. Strumentate l'agente con LangSmith o Langfuse e lasciate che ogni esecuzione venga tracciata. Campionate le esecuzioni che meritano un parere umano, di solito i fallimenti, i casi limite e un campione di controllo casuale. Convertitele per Potato, conducete lo studio di annotazione con più annotatori per traccia e leggete il report di accordo accanto ai punteggi. Riportate i conteggi della tassonomia degli errori nello sviluppo, dove la distribuzione dei sottotipi dice se avete un unico fallimento sistematico o una coda lunga.
python -m potato.trace_converter \
  --input langfuse_failed_traces.json \
  --output data/traces_to_review.jsonl \
  --input-format langfuse

potato start config.yaml -p 8000
Scegliere
Scegliete LangSmith quando l'applicazione è costruita su LangChain o LangGraph e il bisogno è la visibilità in produzione, perché le tracce arrivano senza lavoro di strumentazione e il servizio gestito toglie di mezzo la questione dell'infrastruttura. Scegliete Langfuse quando volete la stessa visibilità in open source su più provider, con il versionamento dei prompt nello stesso strumento. Scegliete Potato quando il risultato che vi serve è un insieme difendibile di etichette umane, quando lo studio richiede più annotatori per item e un valore di accordo, quando gli agenti sono di programmazione, multi-agente o incarnati al punto che la traccia ha bisogno di una visualizzazione dedicata, o quando i dati devono restare sulla vostra infrastruttura. Potato è GPL-3.0-or-later e self-hosted, senza costi per postazione o per traccia.
Le affermazioni su LangSmith e Langfuse riportate qui riflettono la loro documentazione come osservata il 2026-06-24, ed entrambi rilasciano aggiornamenti rapidamente. Le correzioni sono benvenute sul repository GitHub. Per la configurazione vera e propria, vedete la guida alla valutazione degli agenti, e per un esempio completo dalle tracce grezze ai giudizi esportati, vedete Valutare gli agenti di IA.