Annotazione dei coding agent: valutare le tracce di Claude Code, Aider e SWE-Agent
Potato renderizza le tracce dei coding agent come diff e blocchi di terminale, con schemi di process reward e code review e convertitori per Claude Code, Aider e SWE-Agent.
Potato ora annota direttamente le sessioni dei coding agent. Una traccia viene renderizzata come diff unificati, blocchi di terminale scuri, letture di file con i numeri di riga e un albero di tutti i file toccati dall'agente. Ci sono tre convertitori per i formati dei coding agent (claude_code, aider e swe_agent_trajectory), accanto agli altri dodici formati di traccia che Potato già legge, e due schemi di annotazione pensati per questi dati: process_reward per la correttezza a livello di passo e code_review per una revisione dei diff in stile GitHub.
L'esecuzione di un coding agent è una lunga traiettoria di letture di file, modifiche, comandi da terminale e ragionamento. Un'interfaccia di annotazione a solo testo appiattisce tutto in un muro di caratteri, ed è per questo che i team che valutano agenti hanno di solito scritto la propria interfaccia di revisione, finendo con dataset che nessun altro può usare. Per il riferimento completo, vedi la documentazione sull'annotazione dei coding agent e la guida alla valutazione degli agenti.
Due cose da verificare prima di pianificare uno studio
Le trascrizioni di Claude Code non contengono il testo del ragionamento del modello. I file conservano il blocco thinking e la sua firma ma scartano il contenuto. Su 6393 blocchi misurati in 40 sessioni locali, nessuno conteneva testo. La traccia convertita riporta il conteggio, così la lacuna è visibile invece di restare silenziosa. Se agli annotatori serve il ragionamento per giudicare i passi, catturalo dal vivo con claude -p --output-format stream-json o con l'Agent SDK invece di rileggerlo dal disco.
Le trascrizioni contengono anche percorsi assoluti, nomi di branch, dettagli dell'ambiente e qualunque sorgente la sessione abbia letto. Oscura questi dati prima di condividere un dataset, e ottieni il consenso delle persone a cui appartengono le sessioni.
La visualizzazione della traccia
Le tracce di codice vengono renderizzate con il tipo di visualizzazione coding_trace, dichiarato in instance_display insieme a tutto ciò che l'annotatore deve vedere. Potato separa ciò che viene mostrato da ciò che viene chiesto, quindi la stessa visualizzazione della traccia funziona con qualsiasi schema di annotazione:
instance_display:
  layout:
    direction: vertical
    gap: 16px
  fields:
    - key: task_description
      type: text
      label: "Task"
    - key: structured_turns
      type: coding_trace
      label: "Agent Session"
      display_options:
        show_file_tree: true
        diff_view: unified
        collapse_long_outputs: true
        max_output_lines: 50
        terminal_theme: dark
        show_step_numbers: true
        show_reasoning: true
Ogni chiamata a uno strumento viene renderizzata in base a ciò che lo strumento ha fatto, così l'annotatore legge un diff come un diff e non come testo con caratteri di escape:
| Strumento | Rendering |
|---|---|
Read | Blocco di codice con numeri di riga |
Edit, Replace | Diff unificato con righe rosse e verdi |
Write, Create | Blocco di codice per un file nuovo, tutto verde |
Bash, Terminal, Shell | Blocco di terminale scuro con un prompt $ |
Grep, Glob, Search, Find | Blocco di codice con i risultati della ricerca |
| Qualsiasi altro | Input e output formattati come JSON |
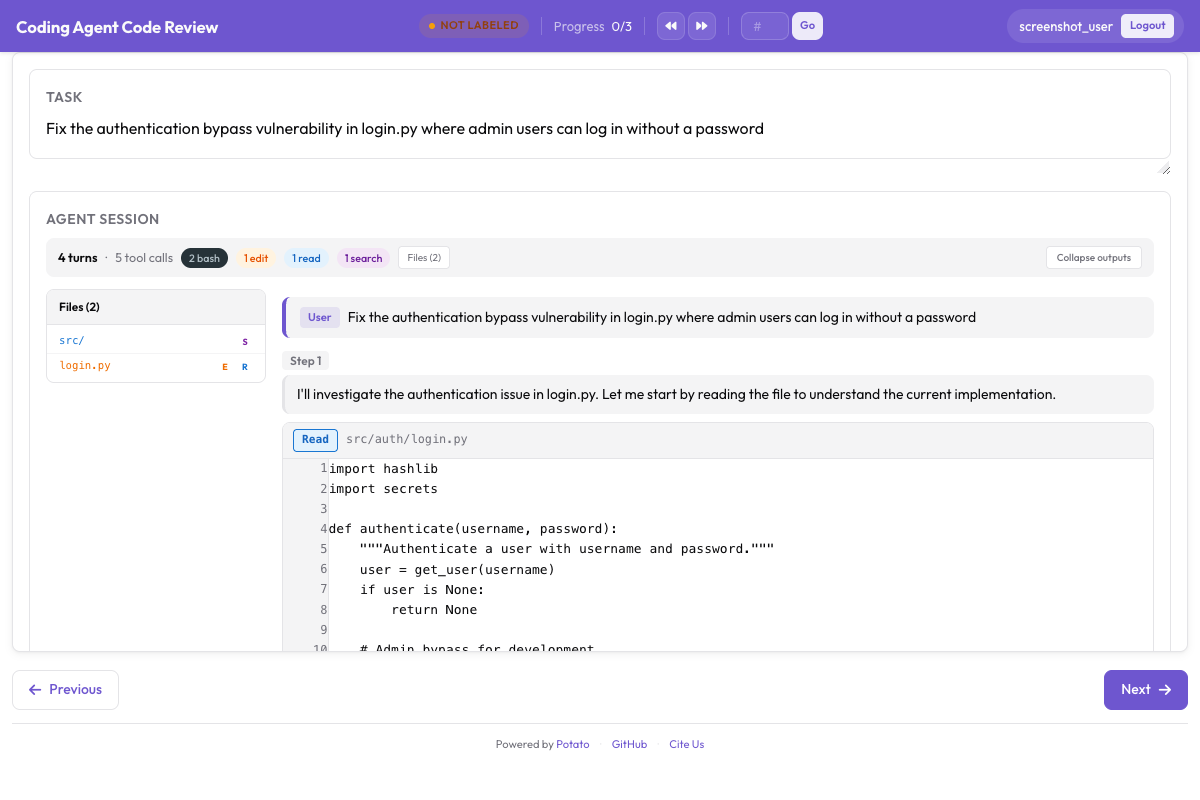
 Una traccia di codice con diff unificati, output del terminale e la sidebar con l'albero dei file
collapse_long_outputs con max_output_lines: 50 è l'impostazione che decide se una traccia è leggibile. Una sola esecuzione di pytest può stampare diverse centinaia di righe, e un annotatore che deve scorrerle a ogni passo smette di leggere i passi.
Il formato dei dati
Il formato structured_turns conserva la struttura delle chiamate agli strumenti di cui la visualizzazione ha bisogno. Ogni turno contiene un ruolo, il contenuto testuale e un elenco di chiamate agli strumenti:
{
  "id": "session_001",
  "task_description": "Fix the authentication bypass in login.py",
  "model": "claude-sonnet-4-20250514",
  "structured_turns": [
    {
      "role": "assistant",
      "content": "I'll investigate the auth issue.",
      "tool_calls": [
        {
          "tool": "Read",
          "input": {"file_path": "src/auth/login.py"},
          "output": "def login(user, password):\n    if user.role == 'admin':\n        return True",
          "output_type": "code",
          "language": "python"
        },
        {
          "tool": "Bash",
          "input": {"command": "pytest tests/test_auth.py -v"},
          "output": "4 passed",
          "output_type": "terminal"
        }
      ]
    }
  ]
}
output_type accetta code, diff, terminal o generic, e Potato lo deduce dallo strumento e dall'estensione del file se lo ometti. Impostalo in modo esplicito quando l'output di uno strumento non è quello che il suo nome fa pensare.
Convertire le tracce che hai già
Il convertitore legge un formato e scrive il JSONL che Potato carica. Tre dei suoi formati sono di coding agent:
# Claude Code, or any Anthropic Messages API transcript
python -m potato.trace_converter -i traces.json -f claude_code -o data/traces.jsonl

# Aider chat history with SEARCH/REPLACE blocks
python -m potato.trace_converter -i chat.md -f aider -o data/traces.jsonl

# SWE-Agent trajectories
python -m potato.trace_converter -i trajectory.json -f swe_agent_trajectory -o data/traces.jsonl

# Mixed directory, format detected per file
python -m potato.trace_converter -i traces.json --auto-detect -o data/traces.jsonl
Il convertitore claude_code legge sia le trascrizioni di sessione di Claude Code sia la forma grezza della Messages API. Claude Code scrive un file JSONL per sessione in ~/.claude/projects/<slugified-working-directory>/<session-id>.jsonl, e il convertitore trasforma una sessione in una sola traccia invece che in una per riga:
python -m potato.trace_converter \
  -i ~/.claude/projects/-home-me-myrepo/3c853f0f-....jsonl \
  --auto-detect -o data/session.jsonl
Segue la catena parentUuid e tiene solo il percorso sopravvissuto, quindi i tentativi riavvolti vengono scartati e contati invece di essere annotati come se fossero avvenuti. I messaggi di sidechain finiscono in sidechain_runs, fuori dai turni principali. I comandi slash vengono scartati, perché lì è la CLI che parla con sé stessa. La forma su disco appartiene alla CLI e non a un'API pubblicata, quindi considera il lettore un tentativo best-effort da un aggiornamento all'altro. Ignora i tipi di record che non conosce e solleva un errore, invece di restituire una traccia vuota, quando un file smette di essere interpretabile.
Annotazione di process reward
Un process reward model assegna il merito passo per passo invece di valutare solo l'esito finale, e process_reward raccoglie le etichette su cui viene addestrato. Due modalità bilanciano velocità e dettaglio.
In modalità first_error, quella predefinita, l'annotatore clicca sul primo passo in cui l'agente ha sbagliato. Ogni passo precedente viene segnato come corretto, e quel passo e tutti quelli successivi come sbagliati. Un clic etichetta l'intera traiettoria, ed è per questo che è la modalità da usare quando ti serve volume.
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent makes a mistake."
    steps_key: structured_turns
    mode: first_error
In modalità per_step ogni passo viene giudicato da solo. Costa più tempo agli annotatori e produce il segnale che first_error non può dare, perché una cascata presuppone che un errore sia irrecuperabile, mentre gli agenti reali si riprendono. Se attivi anche allow_neutral, le etichette seguono la convenzione di PRM800K con +1, 0 e -1, in cui un passo davvero innocuo viene registrato come neutro invece di essere forzato verso un polo:
  - annotation_type: process_reward
    name: step_rewards
    description: "Label each step as correct, neutral, or incorrect."
    steps_key: structured_turns
    step_text_key: content
    mode: per_step
    allow_neutral: true
Aggiungi uno dei due schemi alla configurazione qui sopra. Con allow_neutral attivo, un passo non marcato resta null, quindi l'esportazione distingue un giudizio neutro deliberato da un passo che l'annotatore non ha mai raggiunto. allow_neutral vale solo per per_step e viene forzato a spento in first_error, dove non c'è posto per un giudizio neutro.
Annotazione di code review
Lo schema code_review porta la revisione delle pull request sull'output degli agenti. Gli annotatori cliccano su una riga del diff per allegare un commento categorizzato, valutano ogni file e danno un verdetto:
  - annotation_type: code_review
    name: review
    description: "Review the agent's code changes."
    comment_categories: [bug, style, suggestion, security]
    verdict_options: [approve, request_changes, comment_only]
    file_rating_dimensions: [correctness, quality]
Aggiungi questo schema alla configurazione qui sopra. Le dimensioni di valutazione dei file vanno ciascuna da 1 a 5. I valori predefiniti vanno bene per il lavoro di revisione generico, quindi sovrascrivili quando la tua tassonomia è il punto dello studio, come in una revisione di sicurezza in cui bug e security devono essere categorie separate con definizioni separate nelle istruzioni.
 Commenti inline sui diff, valutazioni per file e il verdetto complessivo
Il tutorial sulla code review segue uno studio di revisione completo, compreso il modo in cui le categorie di commento orientano ciò che gli annotatori notano. Prova quello studio su una manciata di tracce prima di scalarlo, perché un elenco di categorie che nella configurazione sembrava completo di solito acquista una voce in più dopo le prime venti revisioni.
Una configurazione completa
Questa configurazione renderizza le tracce e raccoglie un verdetto a livello di task, i process reward in modalità primo errore e una code review, con tre annotatori per traccia in modo da poter misurare l'accordo:
annotation_task_name: "Coding Agent Trace Evaluation"
task_description: "Judge whether the agent completed the task and review its changes."

data_files:
  - data/traces.jsonl

item_properties:
  id_key: id
  text_key: task_description

port: 8000
output_annotation_dir: annotation_output/coding-agent-eval/
export_annotation_format: jsonl

instance_display:
  layout:
    direction: vertical
    gap: 16px
  fields:
    - key: task_description
      type: text
      label: "Task"
    - key: structured_turns
      type: coding_trace
      label: "Agent Session"
      display_options:
        show_file_tree: true
        diff_view: unified
        collapse_long_outputs: true
        max_output_lines: 50
        terminal_theme: dark
        show_step_numbers: true

annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: success
        tooltip: "Completed correctly with no issues"
      - name: partial
        tooltip: "Completed with minor issues"
      - name: failure
        tooltip: "Not completed, or completed incorrectly"
    sequential_key_binding: true

  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent makes a mistake."
    steps_key: structured_turns
    mode: first_error

  - annotation_type: code_review
    name: review
    description: "Review the agent's code changes."
    comment_categories: [bug, style, suggestion, security]
    verdict_options: [approve, request_changes, comment_only]
    file_rating_dimensions: [correctness, quality]

  - annotation_type: text
    name: notes
    description: "Anything else worth recording about this trace"
    placeholder: "Optional"

num_annotators_per_item: 3

user_config:
  allow_all_users: false
  users:
    - annotator1
    - annotator2
Installa Potato, converti le tue tracce e avvia il server:
pip install potato-annotation
python -m potato.trace_converter -i ./my_traces.json --auto-detect -o data/traces.jsonl
potato start config.yaml -p 8000
Il repository include una versione funzionante di questo progetto in examples/agent-traces/coding-agent-evaluation/, che è il modo più rapido per vedere la visualizzazione prima di convertire qualcosa di tuo. Avvia quella configurazione, leggi una traccia come farebbe un annotatore, e in pochi minuti saprai se la granularità dei passi che pensi di etichettare è la granularità che la visualizzazione mostra.
Esportare per l'addestramento
Le annotazioni escono attraverso l'esportatore per la valutazione del codice, che scrive un file per tipo di output:
python -m potato.export -c config.yaml -f coding_eval -o exports/ \
--option types=prm,preference,swebench,code_review| Tipo | File | Cosa alimenta |
|---|---|---|
prm | prm_training_data.jsonl | Addestramento di process reward model |
preference | preference_pairs.jsonl | DPO o RLHF, da annotazioni a coppie |
swebench | swebench_results.jsonl | Valutazione compatibile con SWE-bench |
code_review | code_reviews.jsonl | Dati di revisione strutturati |
Il tipo preference ha bisogno di annotazioni a coppie da cui partire, quindi uno studio che raccoglie solo process reward produce gli altri tre. Decidi quali dei quattro ti servono prima di progettare gli schemi, perché aggiungere un confronto a coppie a posteriori significa annotare ogni traccia una seconda volta contro un'altra.
Guardare un agente al lavoro
Le tracce registrate sono metà del quadro. live_coding_agent esegue un agente dentro la pagina di annotazione, dove gli annotatori lo guardano lavorare, intervengono, tornano indietro e ripetono l'esecuzione con istruzioni diverse, con un backend Ollama, Anthropic o Claude SDK in una directory di lavoro isolata. La documentazione del live coding agent descrive i backend e le modalità di sandbox.
Se il tuo team sta valutando coding agent e incappa in qualcosa che questa configurazione non copre, apri una issue sul repository GitHub. Un nuovo convertitore è più o meno un file in potato/trace_converter/converters/, quindi un formato che Potato non legge ancora è un contributo da fare, non un ostacolo.