Contrôle qualité pour l'annotation crowdsourcée
Combinez vérifications d'attention, items de référence, recouvrement entre annotateurs et données de temps pour repérer les annotations de mauvaise qualité, avec les clés de configuration Potato de chacun et ce qu'elles rapportent.
Aucune vérification ne détecte à elle seule tous les types de mauvaise annotation, alors superposez-en quatre : des vérifications d'attention pour les annotateurs qui ne lisent pas, des items de référence pour ceux qui lisent et se trompent quand même, du recouvrement pour les items ambigus, et le temps pour le travail soumis trop vite pour avoir été fait. Chacune a sa propre clé de configuration dans Potato, et chacune remonte séparément dans le tableau de bord d'administration.
Le contrôle qualité coûte le moins cher avant la collecte et le plus cher après. Une vérification d'attention qui bloque un annotateur à son cinquième échec ne coûte rien à configurer et épargne les items qu'il aurait remplis ; le même problème découvert par un script après coup vous coûte une nouvelle collecte. Les contrôles ci-dessous sont classés selon le moment où ils interviennent.
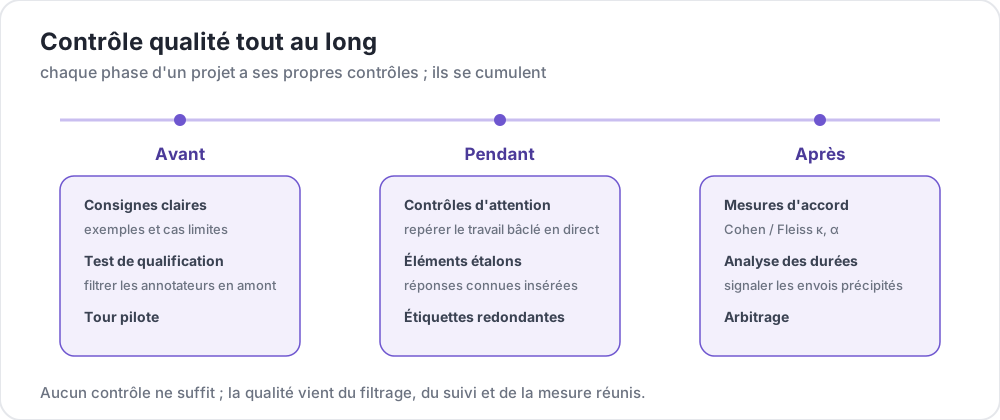 Le contrôle qualité tout au long du projet
Ce que chaque contrôle détecte
Les quatre contrôles échouent dans des directions différentes, et c'est la raison d'en utiliser plus d'un.
| Contrôle | Détecte | Ne détecte pas |
|---|---|---|
| Vérifications d'attention | Les annotateurs qui ne lisent pas l'item | Un annotateur attentif qui comprend mal les consignes |
| Items de référence | Les annotateurs qui lisent et répondent mal | Les items sans réponse correcte unique |
| Recouvrement et accord | Les items et labels ambigus | Les annotateurs d'accord parce qu'ils partagent une même source |
| Temps et télémétrie | Le travail soumis trop vite pour avoir été fait | Le travail rapide sur un corpus réellement facile |
L'accord, en particulier, ne détecte pas tout. Quand les annotateurs relisent des pré-annotations produites par un modèle, accepter une suggestion sans la lire fait monter l'accord au lieu de le faire baisser, si bien que l'annotateur qui valide sans regarder paraît le meilleur selon cette mesure. L'accord ne peut pas détecter la validation machinale explique ce qu'il faut enregistrer à la place.
Vérifications d'attention
Les vérifications d'attention sont des items dont la réponse est connue, insérés dans le flux d'annotation à intervalles réguliers, qui vérifient qu'un annotateur lit avant de répondre. Potato les insère, les note, avertit l'annotateur et le bloque au seuil que vous fixez, de sorte que toute la boucle tourne sur le serveur plutôt que dans un script après coup.
Réglez la fréquence en fonction du temps que prennent vos items. Une vérification tous les 10 items suffit pour repérer un annotateur qui décroche au cours d'une session sans consacrer une grande part du budget à des items qui ne sont pas des données. Le plancher min_response_time est ce qui détecte les clics sans lecture, et une réponse plus rapide que ce plancher échoue quel que soit son contenu :
attention_checks:
  enabled: true
  items_file: "data/attention_checks.json"
  frequency: 10              # one check every 10 items
  min_response_time: 3.0     # seconds; faster than this fails the check

  failure_handling:
    warn_threshold: 2
    warn_message: "Please read items carefully before answering."
    block_threshold: 5
    block_message: "You have been blocked due to too many incorrect responses."
Le fichier d'items donne à chaque vérification un id, le texte que voit l'annotateur et la réponse attendue pour chaque schéma :
[
  {
    "id": "attn_001",
    "text": "Please select 'Positive' for this item to verify you are reading carefully.",
    "expected_answer": {
      "sentiment": "positive"
    }
  }
]
Les résultats survivent à un redémarrage. Potato les écrit dans quality_control_results.json, dans le répertoire de sortie, au fur et à mesure qu'ils sont enregistrés, et les relit au démarrage. Un déploiement n'efface donc pas l'historique d'échecs d'un annotateur et ne débloque pas quelqu'un qui avait été bloqué.
Items de référence
Les items de référence (gold standards) sont des items étiquetés par des experts, mélangés au flux pour mesurer la justesse plutôt que l'attention. Ils sont silencieux par défaut, c'est-à-dire que les résultats vont au tableau de bord d'administration et que l'annotateur ne reçoit aucun retour, ce qui mesure la qualité sans modifier le comportement mesuré. Activez le retour quand vous formez les annotateurs plutôt que de les sélectionner.
Les items de référence sont insérés tous les frequency items, donc ce réglage arbitre entre la précision de la mesure et la part du budget consacrée à des items dont vous avez déjà les labels. Un sur 20 donne environ 25 items notés sur une session de 500 items :
gold_standards:
  enabled: true
  items_file: "data/gold_standards.json"
  mode: mixed                # mixed injects into the stream; this is the implemented mode
  frequency: 20

  accuracy:
    min_threshold: 0.7       # annotators below this are named in the dashboard
    evaluation_count: 10     # evaluate once an annotator has seen 10 gold items

  feedback:
    show_correct_answer: false
    show_explanation: false
Le fichier d'items contient l'annotation correcte pour chaque schéma, plus une explication facultative pour le cas avec retour :
[
  {
    "id": "gold_001",
    "text": "The service was absolutely terrible and I will never return.",
    "gold_label": {
      "sentiment": "negative"
    },
    "explanation": "Strong negative language indicates negative sentiment.",
    "difficulty": "easy"
  }
]
Choisissez des items de référence qui ne sont pas ambigus pour un expert. Un item dont débat votre propre équipe mesure les consignes plutôt que l'annotateur, et fera passer des annotateurs compétents sous le seuil. Potato peut aussi promouvoir des items au rang de référence dès que les annotateurs s'accordent unanimement sur eux, via gold_standards.auto_promote, ce qui agrandit le lot sans étiquetage expert supplémentaire.
La justesse par annotateur apparaît à /admin/api/quality_control, qui rapporte configured_correct et configured_total en plus des totaux. Citez les chiffres configurés pour comparer les annotateurs, car le lot configuré est le même pour tous alors que le lot promu automatiquement dépend du moment où chaque annotateur est arrivé.
Recouvrement et accord
Plusieurs annotateurs par item, c'est le contrôle qui repère les items ambigus plutôt que les mauvais annotateurs. Trois par item est la valeur courante, parce que trois donnent une majorité pour l'agrégation et assez de recouvrement pour un coefficient. Fixez la cible et activez le suivi :
num_annotators_per_item: 3

agreement_metrics:
  enabled: true
  min_overlap: 2
  refresh_interval: 60
L'alpha de Krippendorff apparaît alors dans le tableau de bord d'administration à mesure que les annotations arrivent, par schéma. Mesurer l'accord inter-annotateurs explique quel coefficient rapporter et ce que signifient les seuils.
Temps et télémétrie
Potato enregistre le temps passé sur chaque item, pas seulement la réponse. Chaque instance porte un objet behavioral_data dont le champ total_time_ms est le temps passé sur cet item, à côté des événements d'interaction, de l'historique des modifications de l'annotation et du cycle de vie des suggestions d'IA. C'est ce champ qui permet de distinguer un annotateur rapide parce que le corpus est facile d'un annotateur rapide parce qu'il ne regarde pas :
def flag_fast_annotations(export, min_seconds=2.0):
    """Instances submitted faster than a floor, from an exported annotation file."""
    flagged = []
    for instance in export:
        bd = instance.get("behavioral_data") or {}
        seconds = bd.get("total_time_ms", 0) / 1000
        if seconds < min_seconds:
            flagged.append((instance["id"], seconds))
    return flagged
Lisez le temps comme une distribution au sein de votre propre projet plutôt que par rapport à un nombre fixe de secondes, car le même seuil qui détecte la validation machinale sur un corpus difficile détecte la compétence sur un corpus facile. Pour les annotations dessinées, annotation_telemetry enregistre la même idée à un grain plus fin. Son signal le plus fort est la latence entre l'apparition d'une suggestion d'IA et son acceptation par l'annotateur. Suivi comportemental et télémétrie du dessin décrivent les champs et les alertes qu'ils alimentent.
Une configuration avec les quatre contrôles
Les quatre clés sont indépendantes, donc un projet peut les adopter une par une. Ensemble, elles donnent ceci :
annotation_task_name: "Sentiment Annotation with Quality Control"
task_description: "Classify the sentiment of short texts."

data_files:
  - data/items.json

item_properties:
  id_key: id
  text_key: text

annotation_schemes:
  - annotation_type: radio
    name: sentiment
    description: "What is the sentiment of this text?"
    labels:
      - Positive
      - Negative
      - Neutral

num_annotators_per_item: 3

attention_checks:
  enabled: true
  items_file: data/attention_checks.json
  frequency: 15
  min_response_time: 3.0
  failure_handling:
    warn_threshold: 2
    block_threshold: 5

gold_standards:
  enabled: true
  items_file: data/gold_standards.json
  mode: mixed
  frequency: 25
  accuracy:
    min_threshold: 0.7
    evaluation_count: 10

agreement_metrics:
  enabled: true
  min_overlap: 2
  refresh_interval: 60

output_annotation_dir: annotation_output
Commencez avec des seuils indulgents. Un seuil de blocage de 5 et un plancher de justesse de 0.7 vous laissent voir la distribution réelle de votre groupe d'annotateurs avant de décider ce qui compte comme un échec, et les resserrer plus tard ne coûte rien. Les fixer durement dès le premier jour écarte des annotateurs sur la base de consignes qui n'ont pas encore été testées en pilote.
Contrôles au niveau de la plateforme
Les plateformes de crowdsourcing filtrent le vivier avant que quiconque n'atteigne votre tâche. C'est un travail différent de celui des vérifications ci-dessus, et il vaut la peine de le faire en plus.
- Présélection. Prolific filtre sur le taux d'approbation et le travail déjà réalisé, ainsi que sur des critères démographiques et linguistiques.
- Tests de qualification. Un court test dans la phase de formation de Potato conditionne l'accès à la tâche principale, quelle que soit la plateforme.
- Vérification avant paiement. Approuvez vite quand le travail est correct, car la lenteur d'approbation est ce dont les annotateurs se plaignent le plus, et utilisez le rejet avec parcimonie parce qu'il nuit à la réputation du travailleur sur la plateforme.
La présélection par la plateforme et les vérifications propres à Potato sont complémentaires. La présélection décide qui atteint la tâche ; les vérifications d'attention et les items de référence mesurent ce que les annotateurs y ont fait.
Avant de collecter quoi que ce soit
Deux décisions sont difficiles à défaire une fois la collecte lancée, alors prenez-les d'abord. Décidez quels champs il vous faut dans l'export, car une analyse du temps prévue après coup suppose que behavioral_data ait été enregistré pendant la collecte. Et faites un pilote de quelques dizaines d'items avec tous les contrôles activés, car c'est dans le pilote que vous découvrez que vos vérifications d'attention sont ambiguës ou que vos items de référence sont contestés, et cela coûte un après-midi au lieu d'un jeu de données.
Pour aller plus loin
- Items de référence et vérifications d'attention
- Référence de la fonction de contrôle qualité
- Phase de formation pour former les annotateurs avant la vraie tâche
- Rédiger des consignes d'annotation efficaces
- Mener une étude en crowdsourcing
- La documentation source du contrôle qualité de Potato