Comment recueillir des données de récompense de processus pour entraîner de meilleurs agents de coding
Recueillez des étiquettes de récompense par étape pour l'entraînement de PRM dans Potato, avec les modes première erreur et par étape, et un script qui met l'export en forme pour l'entraînement.
Qu'est-ce qu'un modèle de récompense de processus ?
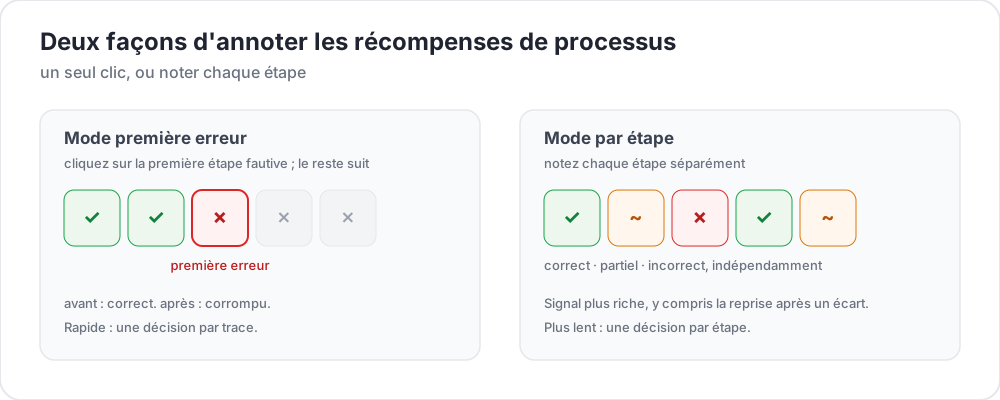 Deux façons d'étiqueter les récompenses de processus
Les modèles de récompense de résultat ne regardent que la fin de la trajectoire d'un agent de coding : le code a-t-il compilé, les tests passent-ils, le problème est-il résolu ? Les modèles de récompense de processus notent plutôt chaque étape intermédiaire. Avec un signal à chaque étape, l'entraînement peut localiser l'endroit où l'agent s'est trompé.
Des travaux récents ont poussé dans cette direction. AgentPRM redéfinit les récompenses de processus pour les tâches d'agent, en notant chaque action selon le progrès qu'elle apporte vers l'objectif plutôt que selon sa justesse, et rapporte une efficacité de calcul plus de 8× supérieure à celle des références auxquelles il se compare. ToolRM a constaté que les modèles de récompense entraînés sur des sorties en langage naturel jugent mal les appels d'outils, et a construit des modèles de récompense spécifiques aux outils ainsi que FC-RewardBench pour les évaluer. À titre de contraste, DeepSWE entraîne un agent de coding avec une seule récompense de résultat éparse, le fait que les tests passent, et atteint 42,2 % en Pass@1 et 59 % avec mise à l'échelle au moment du test sur SWE-bench Verified. C'est ce cadre fondé uniquement sur le résultat que la supervision de processus cherche à améliorer.
Tous ces travaux ont besoin d'annotation humaine au niveau de l'étape, et c'est généralement là que se trouve le goulot d'étranglement. Pour la référence du schéma, consultez la documentation sur la récompense de processus.
Deux modes d'annotation
Mode première erreur
L'annotateur lit la trajectoire de haut en bas et clique sur la première étape où l'agent se trompe. Toutes les étapes précédentes sont enregistrées comme correctes, et cette étape ainsi que toutes les suivantes comme incorrectes. C'est rapide parce qu'il n'y a qu'une décision par trace, et cela convient au cas courant où un agent qui dévie ne se rattrape pas.
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent makes a mistake. Steps after it are flagged automatically."
    mode: first_error
    steps_key: structured_turns
    step_text_key: content
Mode par étape
Chaque étape reçoit sa propre étiquette, ce qui capture ce que le mode première erreur ne peut pas saisir : un rétablissement partiel, un détour sans conséquence, ou une étape correcte isolément mais fausse dans son contexte. allow_neutral ajoute la troisième option à la manière de PRM800K.
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Rate each step correct, neutral, or incorrect"
    mode: per_step
    steps_key: structured_turns
    step_text_key: content
    allow_neutral: true
    inline_with_trace: true
inline_with_trace rattache les contrôles à chaque étape de l'affichage, ce qui compte sur une trace longue, où un panneau séparé fait perdre à l'annotateur l'endroit où il en était.
Mettre en place le projet
Étape 1 : préparer les traces
Chaque ligne est une trajectoire. steps_key nomme la liste des étapes et step_text_key nomme le champ de chaque étape à afficher :
{
  "id": "trace_001",
  "issue_description": "Fix the TypeError in parse_config() when the config file is empty",
  "structured_turns": [
    {"step_idx": 0, "type": "thinking", "content": "I need to find where the TypeError occurs. Let me read the file."},
    {"step_idx": 1, "type": "file_read", "content": "def parse_config(path):\n    with open(path) as f:\n        data = json.load(f)\n    return data['settings']"},
    {"step_idx": 2, "type": "thinking", "content": "When the file is empty json.load returns None, so None['settings'] raises. Add a check."},
    {"step_idx": 3, "type": "file_edit", "content": "+    if data is None:\n+        return {}"},
    {"step_idx": 4, "type": "bash_command", "content": "python -m pytest tests/test_config.py -v  ->  2 passed"}
  ]
}
La conversion depuis un autre format d'agent se fait en ligne de commande :
python -m potato.trace_converter \
  --input claude_code_sessions.json \
  --input-format claude_code \
  --output data/traces.jsonl
--list-formats affiche les formats pris en charge, parmi lesquels claude_code, aider, swe_agent_trajectory, swebench, react, langchain et neuf autres. Utilisez --auto-detect si vous ne savez pas lequel vous avez.
Étape 2 : écrire la configuration
annotation_task_name: "PRM Data Collection"
task_dir: "."

data_files:
  - "data/traces.jsonl"

item_properties:
  id_key: id
  text_key: issue_description

instance_display:
  fields:
    - key: issue_description
      type: text
      label: "Issue"

    - key: structured_turns
      type: coding_trace
      label: "Agent trajectory"
      display_options:
        diff_view: unified
        show_file_tree: true
        show_reasoning: true
        terminal_theme: dark
        collapse_long_outputs: true
        max_output_lines: 50

annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent makes an error"
    mode: first_error
    steps_key: structured_turns
    step_text_key: content

  - annotation_type: radio
    name: outcome
    description: "Did the agent resolve the issue?"
    labels:
      - name: resolved
        text: "Fully resolved"
      - name: partial
        text: "Partially resolved"
      - name: not_resolved
        text: "Not resolved"

  - annotation_type: text
    name: error_description
    description: "If the trajectory went wrong, describe the error briefly"
    rows: 3
    placeholder: "e.g. edited the wrong file"
    label_requirement:
      required: false

num_annotators_per_item: 2

attention_checks:
  enabled: true
  items_file: "data/attention_checks.json"
  frequency: 20
  min_response_time: 20.0
  failure_handling:
    warn_threshold: 2
    block_threshold: 5

user_config:
  allow_all_users: false
  users:
    - reviewer1@example.com
    - reviewer2@example.com
    - reviewer3@example.com

output_annotation_dir: "annotation_output/"
export_annotation_format: jsonl
Un objet d'étiquette est identifié par name. Le champ text est ce que lit l'annotateur, si bien que la valeur stockée reste un identifiant stable même si la formulation change.
min_response_time: 20.0 est le réglage utile ici. Personne ne lit en vingt secondes une trajectoire de plusieurs étapes avec des diffs, donc il repère la précipitation qu'une limite de temps par trace ne repérerait pas.
Étape 3 : lancer le serveur
potato start config.yaml -p 8000Exporter pour l'entraînement
L'exportateur coding_eval écrit directement les formats d'entraînement, la mise en forme est donc faite pour vous :
python -m potato.export -c config.yaml -f coding_eval -o ./export/Il écrit prm_training_data.jsonl avec les étiquettes par étape, preference_pairs.jsonl avec des traces choisies et rejetées à la manière de DPO construites à partir des annotations, swebench_results.jsonl et code_reviews.jsonl. Les quatre sont écrits par défaut. Pour restreindre la sortie, passez l'option types de l'exportateur : --option types=prm,preference. Lorsqu'un type demandé ne trouve aucune donnée dans l'étude, il le signale au lieu d'écrire un fichier vide.
L'annotation est stockée sous le nom du schéma, sous forme d'une liste steps accompagnée du mode. reward vaut 1 pour correct, -1 pour incorrect, 0 pour neutre et null pour une étape que personne n'a jugée :
{
  "step_rewards": {
    "mode": "first_error",
    "steps": [
      {"reward": 1, "source": "human", "verified": true},
      {"reward": 1, "source": "human", "verified": true},
      {"reward": -1, "source": "human", "verified": true},
      {"reward": -1, "source": "human", "verified": true}
    ]
  }
}
N'écrivez un script que si vous avez besoin d'une forme que l'exportateur n'écrit pas. La raison habituelle est de traiter vous-même les étapes non jugées, puisqu'une étape que personne n'a jugée vaut null et non 0 :
import json
from pathlib import Path

SCHEME = "step_rewards"

examples = []
for f in Path("export/").rglob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            rec = json.loads(line)
            payload = (rec.get("labels", rec) or {}).get(SCHEME)
            if not payload:
                continue

            steps = payload.get("steps", [])
            # Drop traces with unjudged steps rather than guessing at them.
            if any(s.get("reward") is None for s in steps):
                continue

            item = items_by_id[rec["instance_id"]]      # your own data file
            examples.append({
                "trace_id": rec["instance_id"],
                "prompt": item["issue_description"],
                "steps": [
                    {"content": src["content"], "label": s["reward"]}
                    for src, s in zip(item["structured_turns"], steps)
                ],
            })

with open("prm_labels.jsonl", "w") as out:
    for ex in examples:
        out.write(json.dumps(ex) + "\n")

print(f"Wrote {len(examples)} traces")
Les paires de préférence proviennent des mêmes annotations. Lorsque deux traces ont traité le même problème, l'exportateur les apparie et retient comme trace choisie celle dont la première erreur survient le plus tard, ou qui n'en a aucune.
Analyse
Où tombe la première erreur
import json
from pathlib import Path

SCHEME = "step_rewards"

traces = []
for f in Path("export/").rglob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            payload = (json.loads(line).get("labels", {}) or {}).get(SCHEME)
            if payload:
                traces.append(payload)

positions = []
all_correct = 0
for t in traces:
    steps = t.get("steps", [])
    first = next((i for i, s in enumerate(steps) if s.get("reward") == -1), None)
    if first is None:
        all_correct += 1
    elif len(steps) > 1:
        positions.append(first / (len(steps) - 1))

print(f"Traces annotated: {len(traces)}")
print(f"No errors: {all_correct} ({all_correct / len(traces):.1%})")
if positions:
    print(f"Average first-error position: {sum(positions) / len(positions):.2f} (0=start, 1=end)")
Accord sur la première erreur
Deux annotateurs choisissent rarement la même étape, et l'accord exact sous-estime à quel point ils sont d'accord. Regrouper d'abord la position en classes donne une comparaison plus informative :
def bin_position(steps):
    first = next((i for i, s in enumerate(steps) if s.get("reward") == -1), None)
    if first is None:
        return "all_correct"
    return "early_error" if first < len(steps) / 2 else "late_error"
Comparez ces classes entre les annotateurs qui partagent des éléments, en vous appuyant sur le recouvrement que fournit num_annotators_per_item.
Conseils
Utilisez le mode première erreur pour la rapidité. Pour entraîner un PRM qui guide une recherche, il fournit assez de signal pour une fraction du coût d'annotation, et la plupart des agents échouent de toute façon en cascade.
Utilisez le mode par étape quand vous avez besoin du détail. Le rétablissement partiel et les détours sans conséquence n'existent comme étiquettes qu'en mode par étape.
Commencez avec des annotateurs expérimentés. Il s'agit de lire du code, des diffs et de la sortie de terminal. Commencez avec un petit groupe, mesurez l'accord, calibrez sur des exemples communs, puis passez à l'échelle.
Fixez un temps de réponse minimal. Les trajectoires s'allongent, et un plancher empêche les annotateurs de survoler les diffs.
Faites une passe de calibration. Faites étiqueter à tout le monde les mêmes dix à vingt traces et discutez des désaccords avant le début de l'annotation de production.