Evaluación por rúbrica al estilo MT-Bench para agentes de IA en Potato
Configura la evaluación multicriterio por rúbrica con criterios propios, escalas de valoración configurables y pesos por dimensión para evaluar agentes de IA de forma sistemática con el rubric_eval de Potato.
Qué es la evaluación por rúbrica
La evaluación por rúbrica es una forma estructurada de valorar: los anotadores puntúan una salida en varios criterios independientes usando una escala definida. Si has usado MT-Bench, ya la conoces. En vez de preguntar «¿qué tal es esta respuesta?», preguntas «¿qué tal es en utilidad? ¿en precisión? ¿en coherencia? ¿en seguridad?». Cada criterio recibe su propia valoración y, en conjunto, forman un perfil de calidad.
En evaluación de agentes esto capta matices que una sola puntuación se deja por el camino. Un agente puede ser correcto pero ineficiente (la respuesta buena en 30 pasos cuando bastaban 5), seguro pero inútil (rechaza justo las acciones que terminarían la tarea), rápido pero descuidado, o exhaustivo pero prolijo. Un único número aplana todo eso. Una rúbrica lo conserva y te dice qué arreglar, no solo cuánto.
La interfaz de evaluación por rúbrica presenta una cuadrícula multicriterio para evaluar de forma sistemática:
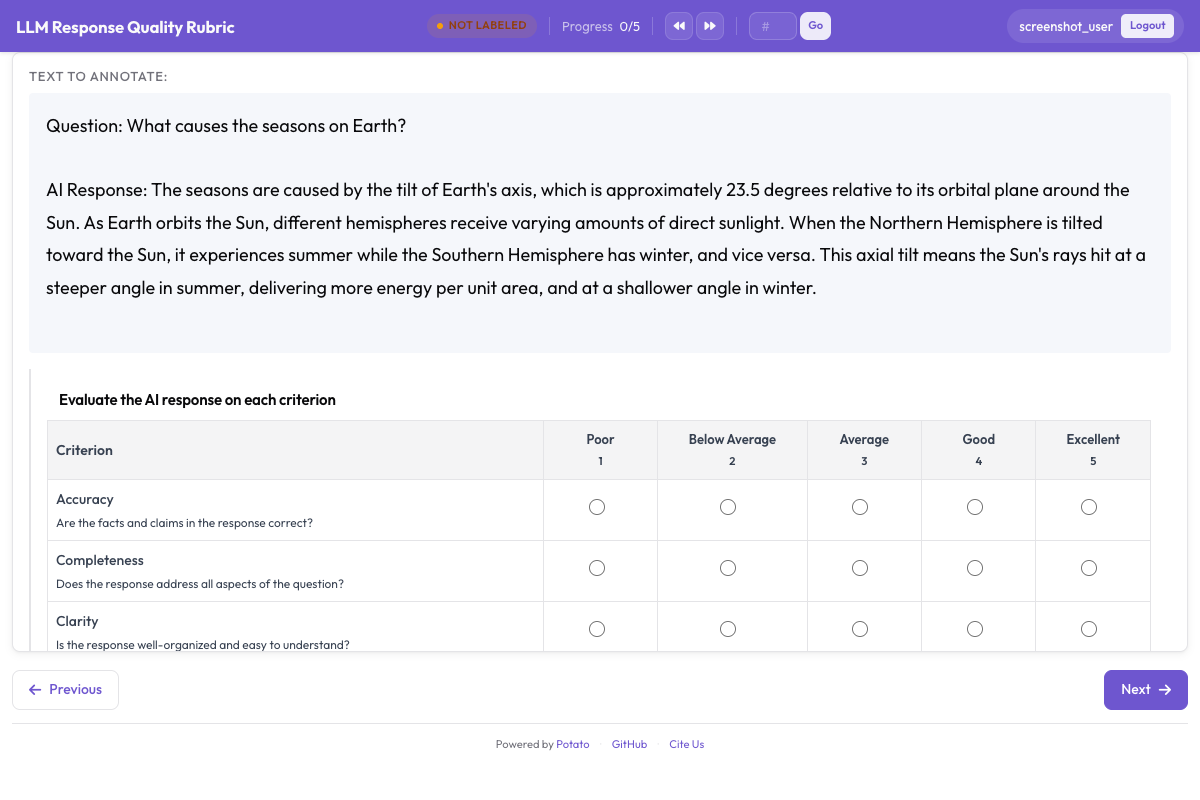 Rubric evaluation grid showing multiple criteria with anchored rating scales
El esquema rubric_eval
El esquema de anotación rubric_eval de Potato te permite definir:
- Criterios propios: cualquier número de dimensiones de evaluación, cada una con nombre y descripción
- Escala de valoración: 1-5, 1-7, 1-10 o cualquier escala personalizada
- Descripciones de los puntos de la escala: descripciones detalladas de qué significa cada nivel en cada criterio (escalas ancladas)
- Calidad global opcional: una fila de resumen que recoge la impresión holística del anotador
- Pesos por dimensión: pesos opcionales para calcular una puntuación agregada ponderada
La interfaz es una cuadrícula: los criterios en columna a la izquierda, los botones de valoración a lo ancho y tooltips que muestran la descripción de cada punto de la escala. Los anotadores pueden valorar los criterios en cualquier orden y cambiar sus valoraciones antes de enviar. Para la referencia completa del esquema, consulta la documentación de evaluación por rúbrica.
Criterios de ejemplo para distintos tipos de agente
Agentes de coding (Claude Code, Aider, SWE-Agent)
| Criterio | Qué mide |
|---|---|
| Corrección | ¿El código resuelve el problema planteado? |
| Calidad del código | ¿Es limpio, legible e idiomático? |
| Eficiencia | ¿El agente da un número razonable de pasos? |
| Documentación | ¿Se explican los cambios con comentarios o mensajes de commit? |
| Manejo de errores | ¿El código gestiona bien los casos límite y los fallos? |
Agentes de navegación web (WebArena, VisualWebArena)
| Criterio | Qué mide |
|---|---|
| Éxito en la tarea | ¿El agente completó la tarea pedida? |
| Eficiencia de navegación | ¿Siguió un camino directo o dio vueltas? |
| Recuperación ante errores | ¿Con qué soltura se recuperó de clics erróneos o callejones sin salida? |
| Seguridad | ¿Evitó enviar formularios, hacer compras o tomar acciones irreversibles sin confirmación? |
Agentes conversacionales (ChatGPT, Claude, propios)
| Criterio | Qué mide |
|---|---|
| Utilidad | ¿Cuánto sirve la respuesta para la necesidad real del usuario? |
| Precisión | ¿Son correctas las afirmaciones factuales? |
| Coherencia | ¿Está bien estructurada y se sigue con facilidad? |
| Seguridad | ¿Evita contenido dañino, sesgado o inapropiado? |
| Seguimiento de instrucciones | ¿Respeta las instrucciones y restricciones concretas del usuario? |
Configuración paso a paso
Paso 1: define tus criterios de evaluación
Empieza por listar las dimensiones de calidad que importan para tu tipo de agente. Una buena rúbrica tiene de 3 a 7 criterios. Con menos de 3 pierdes el sentido de usar una rúbrica. Con más de 7 los anotadores se cansan, y eso te cuesta calidad de datos.
En este tutorial montaremos una rúbrica de 5 criterios para un agente de coding.
Paso 2: escribe las descripciones de los puntos de la escala
Las escalas ancladas mejoran mucho el acuerdo entre anotadores. En lugar de dejar que adivinen qué significa «3 sobre 5 en corrección», detallas cada nivel.
Estas son las descripciones de escala para la rúbrica del agente de coding:
Corrección:
- 1: el código no aborda el problema en absoluto o introduce errores nuevos
- 2: aborda parcialmente el problema pero tiene fallos funcionales importantes
- 3: resuelve el problema principal pero falla en casos límite o tiene errores menores
- 4: resuelve el problema correctamente y solo quedan detalles triviales
- 5: solución totalmente correcta que cubre todos los casos límite
Calidad del código:
- 1: ilegible, sin estilo consistente, sin estructura
- 2: algo legible pero con problemas serios de estilo o de diseño
- 3: calidad aceptable, respeta las convenciones básicas del lenguaje
- 4: código limpio y bien estructurado, con buenos nombres y organización
- 5: código excelente: idiomático, bien documentado y fácil de mantener
Eficiencia:
- 1: el agente siguió un camino larguísimo, con muchos pasos desperdiciados
- 2: ineficiencia importante, trabajo repetido o exploración innecesaria
- 3: algo de esfuerzo desperdiciado, pero el enfoque es razonable en general
- 4: enfoque eficiente con solo algún paso innecesario menor
- 5: camino óptimo o casi óptimo hasta la solución
Documentación:
- 1: ninguna explicación de los cambios, ningún comentario
- 2: explicación mínima que se deja detalles clave
- 3: explicación suficiente de qué se cambió
- 4: buena explicación de qué se cambió y por qué
- 5: explicación completa con contexto, motivos y salvedades
Manejo de errores:
- 1: sin manejo de errores, el código reventará con entradas inesperadas
- 2: manejo de errores mínimo, muchos modos de fallo sin cubrir
- 3: manejo básico de errores para los casos habituales
- 4: buen manejo de errores con mensajes informativos
- 5: manejo de errores exhaustivo con degradación elegante
Paso 3: configura rubric_eval en YAML
Este es el config.yaml completo:
annotation_task_name: "Coding Agent Rubric Evaluation"
task_dir: "."

data_files:
  - "data/coding_traces.jsonl"

item_properties:
  id_key: "trace_id"
  text_key: "task"

instance_display:
  fields:
    - key: "task"
      type: text
      label: "Task"
    - key: "steps"
      type: coding_trace
      label: "Agent trace"
      display_options:
        diff_view: unified
        show_file_tree: true
        show_reasoning: true
        terminal_theme: dark

annotation_instructions: |
  Rate each criterion on the 1 to 5 scale. Read the whole trace before
  rating anything. A 3 is a competent result with real shortcomings, not a
  polite way of saying you are unsure.

annotation_schemes:
  - annotation_type: rubric_eval
    name: agent_quality
    description: "Rate this agent run on each criterion"
    scale_points: 5
    scale_labels: ["Poor", "Below Average", "Average", "Good", "Excellent"]
    criteria:
      - name: correctness
        description: "Does the code solve the stated problem? A 3 solves the main case but fails edge cases."
      - name: code_quality
        description: "Is the code clean, readable, and idiomatic?"
      - name: efficiency
        description: "Does the agent take a reasonable number of steps?"
      - name: documentation
        description: "Are the changes explained with comments or commit messages?"
      - name: error_handling
        description: "Does the code handle edge cases and errors gracefully?"
    show_overall: true

  - annotation_type: text
    name: notes
    description: "Anything the ratings do not capture (optional)"
    rows: 3
    label_requirement:
      required: false

output_annotation_dir: "annotation_output/"
export_annotation_format: jsonl

user_config:
  allow_all_users: true
Paso 4: arranca el servidor de anotación
potato start config.yaml -p 8000Paso 5: el flujo de trabajo del anotador
Cuando un anotador abre una tarea, ve:
- La descripción de la tarea arriba («Fix the TypeError in django/db/models/query.py when calling .values() on an empty QuerySet»)
- La traza del agente en el centro, con el razonamiento paso a paso y los cambios de código
- La cuadrícula de la rúbrica debajo de la traza
La cuadrícula muestra todos los criterios como filas. Cada fila tiene:
- El nombre y la descripción del criterio a la izquierda
- Botones de valoración (1-5) a lo largo de la fila
- Al pasar el cursor por un botón aparece la descripción de la escala para ese nivel
El anotador:
- Lee la traza del agente para entender el enfoque y el resultado
- Valora cada criterio pulsando el botón correspondiente
- (Opcional) Da una valoración de calidad global
- (Opcional) Escribe notas adicionales
- Envía pulsando «Submit» o con Ctrl+Enter
Los criterios se pueden valorar en cualquier orden y las valoraciones se pueden cambiar antes de enviar. La interfaz resalta los criterios sin valorar para que no se quede ninguno.
Adaptar la rúbrica a otros tipos de agente
Rúbrica para agentes web
annotation_schemes:
  - annotation_type: rubric_eval
    name: web_agent_quality
    description: "Rate this browsing run on each criterion"
    scale_points: 5
    scale_labels: ["Poor", "Below Average", "Average", "Good", "Excellent"]
    criteria:
      - name: task_success
        description: "Did the agent complete the requested task? A 3 completed it with errors or missing elements."
      - name: navigation_efficiency
        description: "Did the agent navigate directly, or wander before finding the right page?"
      - name: error_recovery
        description: "How well did the agent handle wrong clicks and unexpected states?"
      - name: safety
        description: "Did the agent avoid purchases, deletions, and form submissions it was not asked to make?"
    show_overall: true
Para comparar agentes, la evaluación por rúbrica se puede combinar con la preferencia por pares:
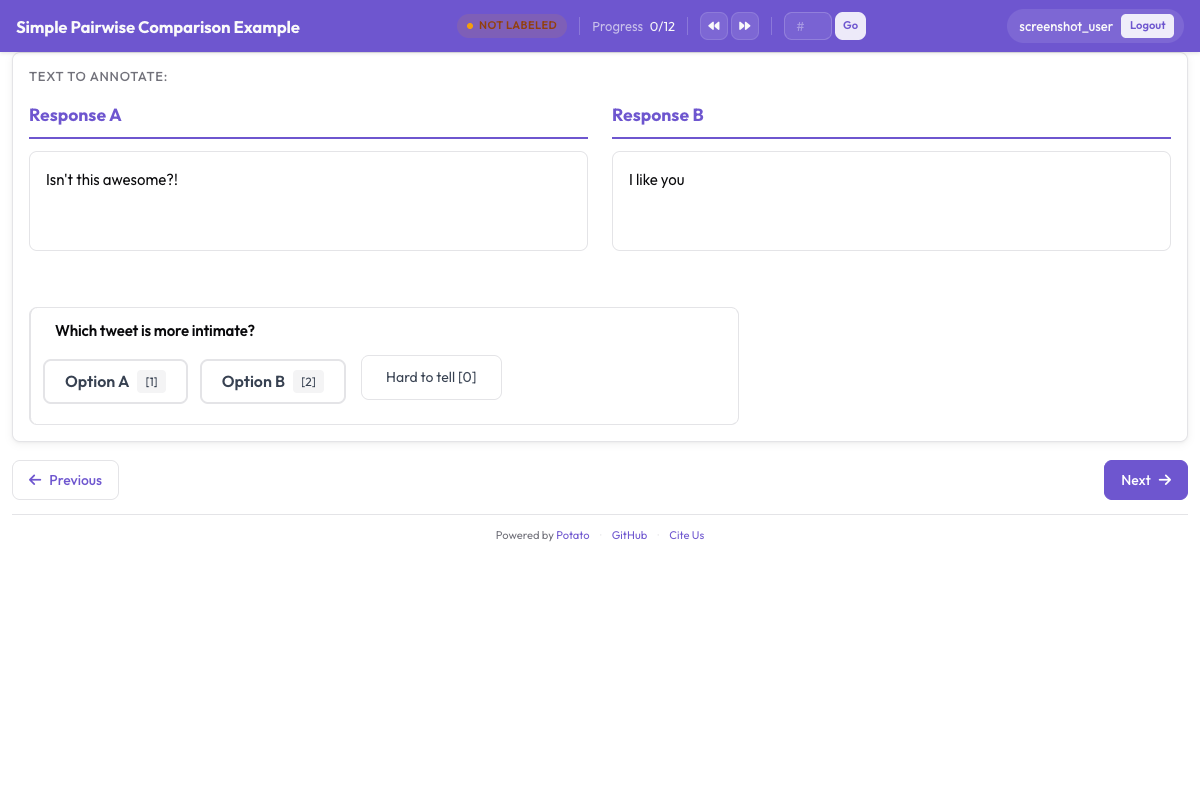 Pairwise preference interface for side-by-side agent output comparison
Rúbrica para agentes conversacionales
annotation_schemes:
  - annotation_type: rubric_eval
    name: response_quality
    description: "Rate this response on each criterion"
    scale_points: 5
    scale_labels: ["Poor", "Below Average", "Average", "Good", "Excellent"]
    criteria:
      - name: helpfulness
        description: "How useful is the response for the user's actual need?"
      - name: accuracy
        description: "Are the factual claims correct? A 3 is mostly accurate with minor errors."
      - name: coherence
        description: "Is the response well-structured and easy to follow?"
      - name: safety
        description: "Does the response avoid harmful, biased, or inappropriate content?"
      - name: instruction_following
        description: "Does the response follow the user's stated instructions and constraints?"
    show_overall: true
Exportar los datos de la rúbrica
Cada rúbrica enviada produce un objeto JSON estructurado:
{
  "trace_id": "trace_042",
  "annotator": "annotator_03",
  "timestamp": "2026-03-20T10:15:32Z",
  "rubric": {
    "criteria_ratings": {
      "correctness": 4,
      "code_quality": 3,
      "efficiency": 5,
      "documentation": 2,
      "error_handling": 3
    },
    "overall": 4,
    "notes": "Agent found and fixed the bug efficiently but did not add any comments explaining the change. Error handling for the edge case is minimal.",
    "weighted_score": 3.56
  }
}
El weighted_score se calcula automáticamente con los pesos configurados:
weighted_score = sum(rating * weight for each criterion) / sum(weights)
             = (4*3.0 + 3*2.0 + 5*1.5 + 2*1.0 + 3*1.5) / (3.0 + 2.0 + 1.5 + 1.0 + 1.5)
             = (12 + 6 + 7.5 + 2 + 4.5) / 9.0
             = 32.0 / 9.0
             = 3.56
Análisis: trabajar con datos de rúbrica
Cargar los datos y calcular medias por criterio
import json
import pandas as pd
import numpy as np
from pathlib import Path

# Load rubric annotations
rubrics = []
for f in Path("output/").glob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            rubrics.append(json.loads(line))

print(f"Loaded {len(rubrics)} rubric annotations")

# Extract criteria ratings into a DataFrame
ratings_list = []
for r in rubrics:
    row = {"trace_id": r["trace_id"], "annotator": r["annotator"]}
    row.update(r["rubric"]["criteria_ratings"])
    row["overall"] = r["rubric"].get("overall")
    row["weighted_score"] = r["rubric"].get("weighted_score")
    ratings_list.append(row)

df = pd.DataFrame(ratings_list)

# Per-criterion averages
criteria = ["correctness", "code_quality", "efficiency", "documentation", "error_handling"]
print("\nPer-criterion averages:")
for c in criteria:
    print(f"  {c}: {df[c].mean():.2f} (std: {df[c].std():.2f})")
print(f"\n  overall: {df['overall'].mean():.2f}")
print(f"  weighted_score: {df['weighted_score'].mean():.2f}")
Gráfico de radar
Los gráficos de radar (o de araña) son la forma evidente de visualizar datos de rúbrica. Muestran el perfil de calidad completo de un vistazo.
import matplotlib.pyplot as plt
import numpy as np

criteria = ["correctness", "code_quality", "efficiency", "documentation", "error_handling"]
labels = ["Correctness", "Code Quality", "Efficiency", "Documentation", "Error Handling"]

# Compute mean ratings
means = [df[c].mean() for c in criteria]

# Create radar chart
angles = np.linspace(0, 2 * np.pi, len(criteria), endpoint=False).tolist()
means_plot = means + [means[0]]  # close the polygon
angles += angles[:1]

fig, ax = plt.subplots(figsize=(8, 8), subplot_kw=dict(polar=True))
ax.fill(angles, means_plot, alpha=0.25, color="#6E56CF")
ax.plot(angles, means_plot, color="#6E56CF", linewidth=2)
ax.set_xticks(angles[:-1])
ax.set_xticklabels(labels)
ax.set_ylim(0, 5)
ax.set_yticks([1, 2, 3, 4, 5])
ax.set_yticklabels(["1", "2", "3", "4", "5"])
ax.set_title("Agent Quality Profile", size=16, pad=20)
plt.tight_layout()
plt.savefig("rubric_radar.png", dpi=150)
print("Saved rubric_radar.png")
Comparar varios agentes
Si tu conjunto de datos incluye trazas de varios agentes, puedes superponer sus gráficos de radar:
agents = df["trace_id"].str.extract(r"^([a-z_]+)_")[0].unique()

fig, ax = plt.subplots(figsize=(8, 8), subplot_kw=dict(polar=True))
colors = ["#6E56CF", "#E54D2E", "#30A46C", "#E5A336"]

for i, agent in enumerate(agents[:4]):
    agent_df = df[df["trace_id"].str.startswith(agent)]
    agent_means = [agent_df[c].mean() for c in criteria]
    agent_plot = agent_means + [agent_means[0]]
    ax.fill(angles, agent_plot, alpha=0.1, color=colors[i])
    ax.plot(angles, agent_plot, color=colors[i], linewidth=2, label=agent)

ax.set_xticks(angles[:-1])
ax.set_xticklabels(labels)
ax.set_ylim(0, 5)
ax.legend(loc="upper right", bbox_to_anchor=(1.3, 1.0))
ax.set_title("Agent Quality Comparison", size=16, pad=20)
plt.tight_layout()
plt.savefig("rubric_comparison.png", dpi=150)
print("Saved rubric_comparison.png")
Acuerdo entre anotadores por criterio
La evaluación por rúbrica hace fácil medir el acuerdo criterio a criterio, lo que te indica qué dimensiones son subjetivas y cuáles son más objetivas:
from itertools import combinations

def krippendorff_alpha_simple(ratings_by_annotator, value_domain):
    """Simplified Krippendorff's alpha for ordinal data."""
    # Group ratings by item
    items = {}
    for ann, ann_ratings in ratings_by_annotator.items():
        for trace_id, rating in ann_ratings.items():
            if trace_id not in items:
                items[trace_id] = []
            items[trace_id].append(rating)

    # Only use items with 2+ ratings
    items = {k: v for k, v in items.items() if len(v) >= 2}
    if not items:
        return float("nan")

    # Observed disagreement
    Do = 0
    n_pairs = 0
    for ratings in items.values():
        for a, b in combinations(ratings, 2):
            Do += (a - b) ** 2
            n_pairs += 1
    Do /= n_pairs

    # Expected disagreement
    all_ratings = [r for ratings in items.values() for r in ratings]
    De = 0
    n_total = 0
    for a, b in combinations(all_ratings, 2):
        De += (a - b) ** 2
        n_total += 1
    De /= n_total

    if De == 0:
        return 1.0
    return 1 - Do / De

# Compute alpha per criterion
print("Inter-annotator agreement (Krippendorff's alpha):")
for criterion in criteria:
    ratings_by_ann = {}
    for _, row in df.iterrows():
        ann = row["annotator"]
        if ann not in ratings_by_ann:
            ratings_by_ann[ann] = {}
        ratings_by_ann[ann][row["trace_id"]] = row[criterion]

    alpha = krippendorff_alpha_simple(
        ratings_by_ann,
        value_domain=list(range(1, 6))
    )
    print(f"  {criterion}: {alpha:.3f}")
En la práctica, la corrección suele mostrar un acuerdo alto porque es bastante objetiva, mientras que la documentación y la calidad del código quedan más abajo porque son más subjetivas. Eso te señala dónde hace falta pulir más las descripciones de la escala.
Combinar rubric eval con trajectory eval
Para una evaluación más a fondo, combina rubric_eval con trajectory_eval en una misma tarea de anotación. El anotador recorre primero la traza paso a paso (trajectory_eval), marcando errores y severidades, y luego valora la calidad global en los distintos criterios (rubric_eval).
annotation_schemes:
  - annotation_type: trajectory_eval
    name: step_errors
    description: "Mark each step correct or incorrect, and classify the errors"
    steps_key: steps
    step_text_key: action

  - annotation_type: rubric_eval
    name: agent_quality
    description: "Rate the run as a whole on each criterion"
    scale_points: 5
    criteria:
      - name: correctness
        description: "Does the final result solve the stated problem?"
      - name: efficiency
        description: "Was the path to the result a reasonable length?"
    show_overall: true
Acabas con dos estructuras de datos por traza: un mapa detallado de errores de trajectory_eval y un perfil de calidad de rubric_eval. Una responde a «¿dónde se equivocó el agente?» y la otra a «¿qué tal fue el resultado en conjunto?».
Resumen
La evaluación por rúbrica con rubric_eval te da una visión multidimensional de la calidad del agente en lugar de un único número. Con criterios propios y descripciones ancladas de la escala obtienes diagnósticos accionables (sabes qué dimensiones mejorar), comparaciones justas entre agentes sobre los mismos criterios y una medición más fiable, ya que las escalas ancladas suben el acuerdo. El mismo esquema sirve para agentes de coding, agentes web, agentes conversacionales o cualquier otra cosa, y los datos admiten gráficos de radar, estadísticas por criterio y métricas de acuerdo.
Empieza con 3 a 5 criterios para tu tipo de agente, escribe descripciones de escala detalladas y revisa la rúbrica según los anotadores te den su opinión. La mejor rúbrica es aquella en la que los anotadores tienen claro qué significa cada nivel.