So sammelt man Process-Reward-Daten für das Training besserer Coding-Agenten
Reward-Labels pro Schritt für das PRM-Training in Potato sammeln, mit First-Error-Modus und Modus pro Schritt sowie einem Skript, das den Export für das Training aufbereitet.
Was sind Process Reward Models?
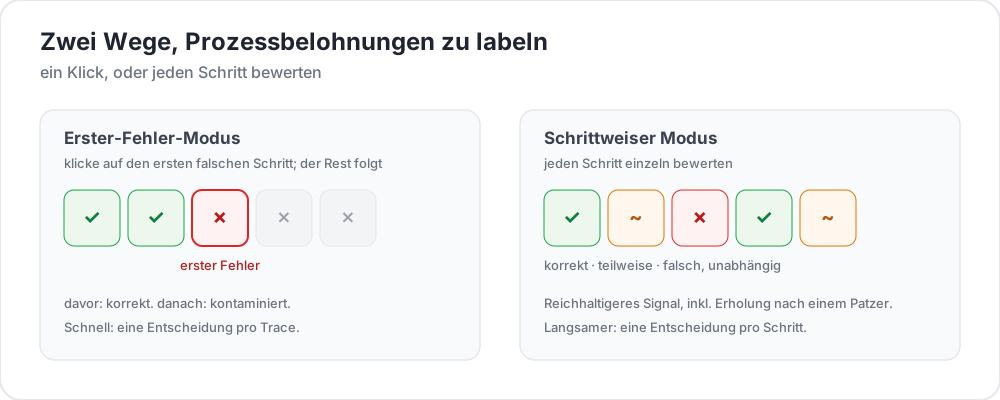 Zwei Wege, Process Rewards zu labeln
Outcome Reward Models betrachten nur das Ende der Trajektorie eines Coding-Agenten: Hat der Code kompiliert, sind die Tests durchgelaufen, wurde das Issue gelöst? Process Reward Models bewerten stattdessen jeden Zwischenschritt. Mit einem Signal an jedem Schritt kann das Training genau festmachen, wo ein Agent falsch lag.
Neuere Arbeiten haben hier angesetzt. AgentPRM definiert Process Rewards für Agentenaufgaben neu, bewertet jede Aktion nach dem Fortschritt, den sie in Richtung Ziel bringt, statt nach ihrer Korrektheit, und berichtet eine mehr als 8× bessere Recheneffizienz als die Baselines, mit denen es sich vergleicht. ToolRM stellte fest, dass Reward-Modelle, die auf natürlichsprachlichen Ausgaben trainiert wurden, Tool-Aufrufe schlecht beurteilen, und baute toolspezifische Reward-Modelle sowie FC-RewardBench, um sie zu evaluieren. Zum Vergleich trainiert DeepSWE einen Coding-Agenten allein mit einem spärlichen Outcome Reward, nämlich ob die Tests durchlaufen, und erreicht 42,2 % Pass@1 sowie 59 % mit Test-Time-Scaling auf SWE-bench Verified. Das ist das rein ergebnisbasierte Setup, das Process Supervision verbessern will.
All diese Arbeiten brauchen menschliche Annotation auf Schrittebene, und die ist meist der Engpass. Die Schema-Referenz findet sich in der Process-Reward-Dokumentation.
Zwei Annotationsmodi
First-Error-Modus
Der Annotator liest die Trajektorie von oben nach unten und klickt den ersten Schritt an, an dem der Agent einen Fehler macht. Jeder frühere Schritt wird als korrekt erfasst, dieser Schritt und alle folgenden als inkorrekt. Das geht schnell, weil pro Trace nur eine Entscheidung anfällt, und es passt zum häufigen Fall, dass ein Agent, der vom Kurs abkommt, nicht wieder zurückfindet.
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent makes a mistake. Steps after it are flagged automatically."
    mode: first_error
    steps_key: structured_turns
    step_text_key: content
Modus pro Schritt
Jeder Schritt bekommt ein eigenes Label. Das erfasst, was der First-Error-Modus nicht kann: teilweise Erholung, einen harmlosen Umweg oder einen Schritt, der für sich genommen in Ordnung, im Kontext aber falsch ist. allow_neutral fügt die dritte Option im Stil von PRM800K hinzu.
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Rate each step correct, neutral, or incorrect"
    mode: per_step
    steps_key: structured_turns
    step_text_key: content
    allow_neutral: true
    inline_with_trace: true
inline_with_trace hängt die Bedienelemente an jeden Schritt in der Anzeige. Das ist bei einem langen Trace wichtig, bei dem ein separates Panel dazu führt, dass der Annotator die Stelle verliert, an der er war.
Das Projekt aufsetzen
Schritt 1: Die Traces vorbereiten
Jede Zeile ist eine Trajektorie. steps_key benennt die Liste der Schritte und step_text_key das Feld innerhalb jedes Schritts, das angezeigt wird:
{
  "id": "trace_001",
  "issue_description": "Fix the TypeError in parse_config() when the config file is empty",
  "structured_turns": [
    {"step_idx": 0, "type": "thinking", "content": "I need to find where the TypeError occurs. Let me read the file."},
    {"step_idx": 1, "type": "file_read", "content": "def parse_config(path):\n    with open(path) as f:\n        data = json.load(f)\n    return data['settings']"},
    {"step_idx": 2, "type": "thinking", "content": "When the file is empty json.load returns None, so None['settings'] raises. Add a check."},
    {"step_idx": 3, "type": "file_edit", "content": "+    if data is None:\n+        return {}"},
    {"step_idx": 4, "type": "bash_command", "content": "python -m pytest tests/test_config.py -v  ->  2 passed"}
  ]
}
Die Konvertierung aus einem anderen Agentenformat ist ein CLI-Schritt:
python -m potato.trace_converter \
  --input claude_code_sessions.json \
  --input-format claude_code \
  --output data/traces.jsonl
--list-formats gibt die unterstützten Formate aus, darunter claude_code, aider, swe_agent_trajectory, swebench, react, langchain und neun weitere. Verwenden Sie --auto-detect, wenn Sie nicht sicher sind, welches Format Sie haben.
Schritt 2: Die Konfiguration schreiben
annotation_task_name: "PRM Data Collection"
task_dir: "."

data_files:
  - "data/traces.jsonl"

item_properties:
  id_key: id
  text_key: issue_description

instance_display:
  fields:
    - key: issue_description
      type: text
      label: "Issue"

    - key: structured_turns
      type: coding_trace
      label: "Agent trajectory"
      display_options:
        diff_view: unified
        show_file_tree: true
        show_reasoning: true
        terminal_theme: dark
        collapse_long_outputs: true
        max_output_lines: 50

annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent makes an error"
    mode: first_error
    steps_key: structured_turns
    step_text_key: content

  - annotation_type: radio
    name: outcome
    description: "Did the agent resolve the issue?"
    labels:
      - name: resolved
        text: "Fully resolved"
      - name: partial
        text: "Partially resolved"
      - name: not_resolved
        text: "Not resolved"

  - annotation_type: text
    name: error_description
    description: "If the trajectory went wrong, describe the error briefly"
    rows: 3
    placeholder: "e.g. edited the wrong file"
    label_requirement:
      required: false

num_annotators_per_item: 2

attention_checks:
  enabled: true
  items_file: "data/attention_checks.json"
  frequency: 20
  min_response_time: 20.0
  failure_handling:
    warn_threshold: 2
    block_threshold: 5

user_config:
  allow_all_users: false
  users:
    - reviewer1@example.com
    - reviewer2@example.com
    - reviewer3@example.com

output_annotation_dir: "annotation_output/"
export_annotation_format: jsonl
Ein Label-Objekt wird über name identifiziert. Das Feld text ist das, was der Annotator liest. So bleibt der gespeicherte Wert ein stabiler Bezeichner, während sich der Wortlaut ändern kann.
min_response_time: 20.0 ist hier die nützliche Stellschraube. Niemand liest eine mehrstufige Trajektorie mit Diffs in zwanzig Sekunden, also fängt sie das Durchhetzen ab, das ein Zeitlimit pro Trace nicht erkennen würde.
Schritt 3: Den Server starten
potato start config.yaml -p 8000Export für das Training
Der Exporter coding_eval schreibt die Trainingsformate direkt, die Aufbereitung wird also für Sie erledigt:
python -m potato.export -c config.yaml -f coding_eval -o ./export/Er schreibt prm_training_data.jsonl mit den Labels auf Schrittebene, preference_pairs.jsonl mit gewählten und abgelehnten Traces im DPO-Stil, die aus den Annotationen gebildet werden, swebench_results.jsonl und code_reviews.jsonl. Alle vier werden standardmäßig geschrieben. Um die Ausgabe einzuschränken, übergeben Sie die Option types des Exporters: --option types=prm,preference. Findet ein angeforderter Typ keine Daten in der Studie, meldet der Exporter das, statt eine leere Datei zu schreiben.
Die Annotation wird unter dem Schemanamen als Liste steps zusammen mit dem Modus gespeichert. reward ist 1 für korrekt, -1 für inkorrekt, 0 für neutral und null für einen Schritt, den niemand beurteilt hat:
{
  "step_rewards": {
    "mode": "first_error",
    "steps": [
      {"reward": 1, "source": "human", "verified": true},
      {"reward": 1, "source": "human", "verified": true},
      {"reward": -1, "source": "human", "verified": true},
      {"reward": -1, "source": "human", "verified": true}
    ]
  }
}
Greifen Sie nur dann zu einem Skript, wenn Sie eine Form brauchen, die der Exporter nicht schreibt. Der übliche Grund ist, nicht beurteilte Schritte selbst zu behandeln, denn ein Schritt, den niemand beurteilt hat, ist null und nicht 0:
import json
from pathlib import Path

SCHEME = "step_rewards"

examples = []
for f in Path("export/").rglob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            rec = json.loads(line)
            payload = (rec.get("labels", rec) or {}).get(SCHEME)
            if not payload:
                continue

            steps = payload.get("steps", [])
            # Drop traces with unjudged steps rather than guessing at them.
            if any(s.get("reward") is None for s in steps):
                continue

            item = items_by_id[rec["instance_id"]]      # your own data file
            examples.append({
                "trace_id": rec["instance_id"],
                "prompt": item["issue_description"],
                "steps": [
                    {"content": src["content"], "label": s["reward"]}
                    for src, s in zip(item["structured_turns"], steps)
                ],
            })

with open("prm_labels.jsonl", "w") as out:
    for ex in examples:
        out.write(json.dumps(ex) + "\n")

print(f"Wrote {len(examples)} traces")
Präferenzpaare entstehen aus denselben Annotationen. Wo zwei Traces dasselbe Issue bearbeitet haben, paart der Exporter sie und behandelt den Trace, dessen erster Fehler später kommt oder der keinen hat, als gewählten Trace.
Auswertung
Wo der erste Fehler liegt
import json
from pathlib import Path

SCHEME = "step_rewards"

traces = []
for f in Path("export/").rglob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            payload = (json.loads(line).get("labels", {}) or {}).get(SCHEME)
            if payload:
                traces.append(payload)

positions = []
all_correct = 0
for t in traces:
    steps = t.get("steps", [])
    first = next((i for i, s in enumerate(steps) if s.get("reward") == -1), None)
    if first is None:
        all_correct += 1
    elif len(steps) > 1:
        positions.append(first / (len(steps) - 1))

print(f"Traces annotated: {len(traces)}")
print(f"No errors: {all_correct} ({all_correct / len(traces):.1%})")
if positions:
    print(f"Average first-error position: {sum(positions) / len(positions):.2f} (0=start, 1=end)")
Übereinstimmung beim ersten Fehler
Zwei Annotatoren wählen selten denselben Schritt, und exakte Übereinstimmung unterschätzt, wie sehr sie übereinstimmen. Die Position zuerst in Klassen einzuteilen, ist der aussagekräftigere Vergleich:
def bin_position(steps):
    first = next((i for i, s in enumerate(steps) if s.get("reward") == -1), None)
    if first is None:
        return "all_correct"
    return "early_error" if first < len(steps) / 2 else "late_error"
Vergleichen Sie diese Klassen zwischen den Annotatoren, die sich Items teilen, anhand der Überlappung, die num_annotators_per_item Ihnen liefert.
Tipps
Nutzen Sie den First-Error-Modus für Geschwindigkeit. Für das Training eines PRM, das eine Suche steuert, liefert er genug Signal zu einem Bruchteil der Annotationskosten, und die meisten Agenten scheitern ohnehin in einer Kaskade.
Nutzen Sie den Modus pro Schritt, wenn Sie die Details brauchen. Teilweise Erholung und harmlose Umwege gibt es als Labels nur im Modus pro Schritt.
Beginnen Sie mit erfahrenen Annotatoren. Die Aufgabe verlangt, Code, Diffs und Terminalausgabe zu lesen. Starten Sie mit einer kleinen Gruppe, messen Sie die Übereinstimmung, kalibrieren Sie an gemeinsamen Beispielen und skalieren Sie dann.
Legen Sie eine Mindestantwortzeit fest. Trajektorien werden lang, und eine Untergrenze hält Annotatoren davon ab, über die Diffs hinwegzuhetzen.
Führen Sie einen Kalibrierungsdurchgang durch. Lassen Sie alle dieselben zehn bis zwanzig Traces labeln und besprechen Sie die Abweichungen, bevor die produktive Annotation beginnt.