Potato vs. LangSmith und Langfuse für die Agentenevaluation: ein praktischer Vergleich
Wofür LangSmith, Langfuse und Potato in der Agentenevaluation jeweils gebaut sind, wie Traces zwischen ihnen wandern und wo menschliches Urteil gemessen wird.
LangSmith und Langfuse sind dafür gebaut, LLM-Anwendungen in Produktion zu tracen und zu überwachen. Potato ist dafür gebaut, strukturierte menschliche Urteile darüber zu sammeln, was diese Traces zeigen, und zu messen, wie stark die Urteilenden übereinstimmen. Teams, die beides brauchen, erfassen meist in einem Observability-Tool und führen die Studie mit Menschen in Potato durch.
Die drei Tools überschneiden sich so weit, dass der Vergleich oft aufkommt, und sie überschneiden sich nur an einer Stelle. Alle drei können ein menschliches Urteil an einen aufgezeichneten Agentenlauf hängen. Worum sie herum organisiert sind, unterscheidet sich, und dieser Unterschied entscheidet, welches zu der Frage passt, die Sie stellen.
Wofür jedes Tool gebaut ist
LangSmith instrumentiert, tract und debuggt LLM-Anwendungen, mit der tiefsten Integration in LangChain und LangGraph. Traces einer Anwendung, die auf diesen Frameworks aufbaut, kommen ohne zusätzliche Instrumentierung an, und die Plattform ist darum herum organisiert, Läufe zu untersuchen, Latenz und Kosten zu verfolgen und Evaluationsexperimente über Datensätze laufen zu lassen. Ihre Annotation Queues unterstützen Feedback-Keys mit Bewertungsraster, eine konfigurierbare Zahl von Reviewern pro Lauf, paarweise Queues und Reviewer, die das Feedback der anderen nicht sehen.
Langfuse deckt dasselbe Feld als Open Source ab, für jede LLM-Anwendung statt für ein einzelnes Framework, und bündelt Prompt-Verwaltung mit dem Tracing. Bewertet werden kann auf Trace-Ebene und auf Observation-Ebene (Span), und mit seinen kategorialen Score Configs lässt sich ein fester Labelsatz definieren und mehrere benannte Scores an einen Span hängen.
Potato ist eine Annotationsplattform, die auf Agenten-Traces erweitert wurde. Sie ist um die Studie statt um die Anwendung herum organisiert, ihre Grundbausteine sind also, wer was annotiert, wie viele Personen jedes Item sehen, was passiert, wenn sie sich nicht einig sind, und was die Übereinstimmungsstatistiken darüber sagen, ob die Labels etwas bedeuten. Agenten-Traces sind ein Item-Typ unter den 61 Annotationstypen, die das aktuelle Release registriert, und deshalb erben sie Inter-Annotator-Übereinstimmung, Trainingsphasen, Adjudikation und Crowdsourcing, ohne dass irgendetwas davon für Agenten neu gebaut wurde.
Keines der drei ist im Abstrakten besser. Die nützliche Frage ist, ob Ihr Engpass darin liegt, zu sehen, was der Agent getan hat, oder darin, den menschlichen Labels zu vertrauen, die Sie darüber sammeln.
Traces zwischen ihnen bewegen
Potato liest Traces im Nachhinein, statt Ihren Code zu instrumentieren, und registriert deshalb Konverter für 15 Trace-Formate:
python -m potato.trace_converter --list-formatsDie Liste umfasst react, openai, anthropic, langchain, langfuse, multi_agent, mcp, otel, atif, webarena, web_agent, swebench, swe_agent_trajectory, claude_code und aider. LangSmith-Laufexporte gehen durch den Konverter langchain, weil es keinen eigenen langsmith gibt. Logs aus CrewAI, AutoGen und LangGraph gehen durch multi_agent.
Einen Export umzuwandeln ist in jeder Richtung des Workflows ein einziger Befehl:
# LangSmith runs, exported from LangSmith, converted for annotation
python -m potato.trace_converter \
  --input langsmith_export.jsonl \
  --output data/traces.jsonl \
  --input-format langchain

# Langfuse traces, exported from Langfuse
python -m potato.trace_converter \
  --input langfuse_traces.json \
  --output data/traces.jsonl \
  --input-format langfuse
Steht Ihr Framework nicht auf der Liste, wählt --auto-detect anhand der Feldsignaturen einen Konverter, und ein neuer Konverter ist eine Unterklasse von BaseTraceConverter. Die Erkennung nimmt den ersten passenden Konverter, nennen Sie das Format also explizit, sobald Sie wissen, welches zu Ihren Dateien passt.
Traces können auch ohne Exportschritt ankommen. Die Trace-Ingestion von Potato nimmt Läufe an, die im Payload-Format für LangSmith-Läufe an /api/traces/* gesendet werden, sodass ein LangChain-Callback oder das Tracing-SDK Läufe in die Annotations-Queue schieben kann, während sie passieren:
trace_ingestion:
  enabled: true
  api_key: "your-api-key"
  notify_annotators: true
Was Potato hinzufügt, sobald der Trace drin ist
In den Schemas verdient sich eine Annotationsplattform ihren Platz. trajectory_eval trägt das Korrektheitslabel, eine hierarchische Fehlertaxonomie mit Untertypen, Schweregrade mit konfigurierbaren Gewichten und einen laufenden Qualitätsscore, in einem Schema, das an einem Trace hängt:
annotation_schemes:
  - annotation_type: trajectory_eval
    name: step_evaluation
    description: "Mark each step and classify anything that went wrong"
    steps_key: conversation
    step_text_key: text
    error_types:
      - name: execution
        subtypes: [wrong_tool, wrong_args, api_error]
    severities:
      - name: minor
        weight: -1
      - name: critical
        weight: -10
    show_score: true
Die Schweregewichte sind der Teil, der beim Vergleich von Traces zählt. Eine flache Zählung markierter Schritte sagt, dass ein Agent vier Fehler gemacht hat und ein anderer zwei, und der gewichtete Score sagt, ob die vier kosmetisch und die zwei gefährlich waren.
Vergleichende Evaluation läuft über das Schema pairwise, das drei Modi hat. Der Binärmodus zeigt zwei anklickbare Kacheln mit optionalem Unentschieden-Button, der Skalenmodus ersetzt die Auswahl durch einen Schieberegler zwischen den beiden Items, und der Modus multi_dimension verlangt ein unabhängiges A/B-Urteil pro benannter Dimension, etwa Hilfreichkeit, Genauigkeit und Sicherheit.
Coding-Agenten bekommen eine eigene Anzeige, weil ein Unified Diff, gelesen als JSON-String, nicht reviewbar ist:
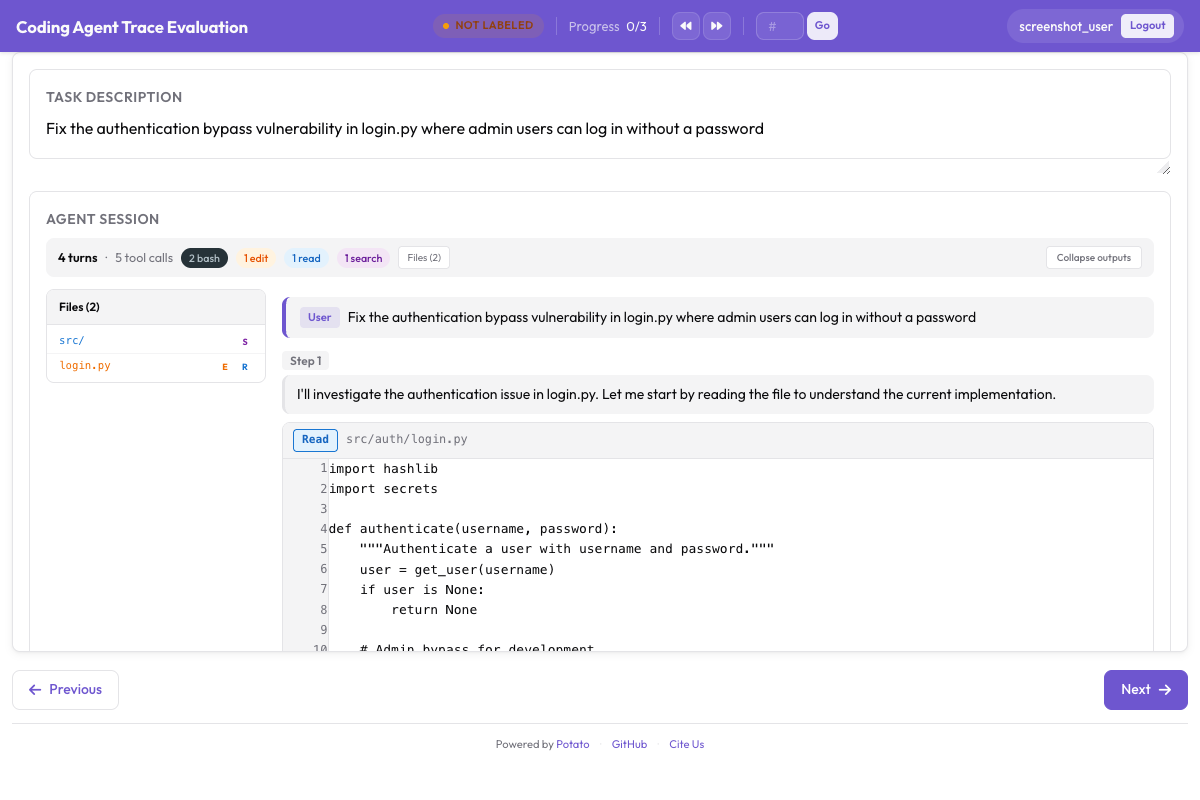 Potatos Anzeige für Coding-Traces mit Unified-Diff-Darstellung, Syntaxhervorhebung und Dateibaum
Die Anzeige coding_trace stellt Diffs mit einem Dateibaum dar und klappt lange Terminalausgaben ein, und das Schema code_review sammelt zeilengebundene Kommentare in konfigurierbaren Kategorien, Bewertungsdimensionen pro Datei und ein Urteil im Stil eines Pull Requests. Der Exporter coding_eval schreibt anschließend Labels für Process Reward Models, Code-Review-Annotationen, DPO-Präferenzpaare und SWE-bench-kompatible Scores, also die Form, die Trainingsdaten brauchen, und nicht die Form, die ein Dashboard braucht.
Traces von Web-Agenten werden als Screenshots mit SVG-Overlays der Aktionen und einem Filmstreifen dargestellt:
 Trace-Viewer für Web-Agenten mit Screenshots, SVG-Overlays der Aktionen und Filmstreifen-Navigation
Multi-Agenten-Läufe haben eigene Annotationsflächen, statt zu einem einzigen Schrittstrom abgeflacht zu werden. Die Registry enthält Schemas für einen von Annotatoren bearbeitbaren Interaktionsgraphen, agentenübergreifende Fehlerzuordnung, Handoff-Review, Scorecards pro Agent und pro Team, Werkzeugkonkurrenz über eine gemeinsame Zeitachse und das Taggen emergenten Verhaltens. Dasselbe gilt für verkörperte und multimodale Agenten, mit Computer-Use-Trajektorien, Vollduplex-Sprachinteraktion und zeitlichem Grounding in Videos als vollwertigen Schemas.
Die Urteile messen, nicht nur sammeln
Der Unterschied, der sich in einem Projekt am spätesten zeigt, ist, was passiert, nachdem zwei Annotatoren sich nicht einig sind. Potato behandelt eine Uneinigkeit als Messung statt als Konflikt, der aufzulösen ist, sodass dieselben Übereinstimmungsstatistiken, dieselbe Adjudikations-Queue, dieselben Trainingsphasen und dieselben Gold-Items, die eine Textannotationsstudie verwendet, ohne zusätzliche Konfiguration auf Agenten-Traces greifen. Potatos eigener Tool-Vergleich hält mit Stand der Prüfung vom 2026-06-24 fest, dass die Tracing-Plattformen dafür gebaut sind, menschliche Urteile als Scores zu sammeln, und dass keine von ihnen eine Reliabilitätsstatistik über diese Urteile dokumentiert, und dass Langfuse eine frühere Annotation auf demselben Trace ersetzt, sodass unabhängige Doppelannotation dort einen Umweg braucht.
Das zählt, wenn die Evaluation der Beleg ist. Eine Erfolgsquote, die aus einzelnen, nicht überprüften Urteilen gebildet wird, hat keinen Fehlerbalken, und ein Reviewer, der abgedriftet ist, sieht genauso aus wie ein Agent, der sich verbessert hat.
Einen Agenten beobachten, während er läuft
Potato kann einen Agenten auch innerhalb der Annotationsseite laufen lassen, statt eine Aufzeichnung abzuspielen. Der Block live_agent verbindet ein Vision-Modell mit einem Headless-Browser und streamt die Sitzung an den Annotator, der sie pausieren, Anweisungen senden oder die manuelle Steuerung übernehmen kann:
live_agent:
  endpoint_type: anthropic_vision
  ai_config:
    model: claude-sonnet-4-20250514
    api_key: ${ANTHROPIC_API_KEY}
  max_steps: 30
  allow_takeover: true
  allow_instructions: true

instance_display:
  fields:
    - key: agent_trace
      type: live_agent
      label: "Live Agent Session"
      display_options:
        show_overlays: true
        show_filmstrip: true
Drei Situationen machen den Einrichtungsaufwand gegenüber einem nachträglichen Review lohnend. Einen Lauf vor einer destruktiven Aktion zu stoppen, ist eine Sicherheitsmaßnahme, die aufgezeichnete Traces nicht bieten können. Eine mitten im Lauf aufgezeichnete menschliche Übernahme wird zu Demonstrationsdaten. Und zu beobachten, wie ein Agent sich von einem Eingriff erholt, beantwortet eine Frage, die kein abgeschlossener Trace enthält.
Beide zusammen einsetzen
Das übliche Produktions-Setup nutzt beide, und die Aufteilung ist sauber, weil die Tools Unterschiedliches wollen. Instrumentieren Sie den Agenten mit LangSmith oder Langfuse und lassen Sie jeden Lauf tracen. Ziehen Sie eine Stichprobe der Läufe, die ein menschliches Urteil wert sind, meist die Fehlschläge, die Randfälle und eine zufällige Kontrollstichprobe. Wandeln Sie diese für Potato um, führen Sie die Annotationsstudie mit mehreren Annotatoren pro Trace durch und lesen Sie den Übereinstimmungsbericht neben den Scores. Geben Sie die Zählungen aus der Fehlertaxonomie an die Entwicklung zurück, wo die Verteilung der Untertypen zeigt, ob Sie einen systematischen Fehler haben oder einen Long Tail.
python -m potato.trace_converter \
  --input langfuse_failed_traces.json \
  --output data/traces_to_review.jsonl \
  --input-format langfuse

potato start config.yaml -p 8000
Die Wahl
Greifen Sie zu LangSmith, wenn die Anwendung auf LangChain oder LangGraph aufbaut und Sichtbarkeit in der Produktion gebraucht wird, weil Traces dann ohne Instrumentierungsarbeit ankommen und der verwaltete Dienst die Infrastrukturfrage erledigt. Greifen Sie zu Langfuse, wenn Sie dieselbe Sichtbarkeit als Open Source über mehrere Anbieter hinweg wollen, mit Prompt-Versionierung im selben Tool. Greifen Sie zu Potato, wenn das Ergebnis, das Sie brauchen, ein belastbarer Satz menschlicher Labels ist, wenn die Studie mehrere Annotatoren pro Item und eine Übereinstimmungszahl braucht, wenn es sich um Coding-, Multi-Agenten- oder verkörperte Agenten handelt, deren Traces eine eigens gebaute Anzeige brauchen, oder wenn die Daten auf Ihrer eigenen Infrastruktur bleiben müssen. Potato steht unter GPL-3.0-or-later und wird selbst gehostet, ohne Kosten pro Platz oder pro Trace.
Aussagen über LangSmith und Langfuse geben hier deren Dokumentation mit Stand vom 2026-06-24 wieder, und beide liefern schnell neue Versionen aus. Korrekturen sind im GitHub-Repository willkommen. Für die Einrichtung selbst siehe den Leitfaden zur Agentenevaluation, und für ein durchgearbeitetes Beispiel von rohen Traces bis zu exportierten Urteilen siehe KI-Agenten evaluieren.