Schlüsselwörter automatisch hervorheben
Schlüsselwort-Hervorhebung in Potato einrichten, mit einer festen Schlüsselwortdatei oder einem LLM-Schlüsselwortassistenten, einschließlich Farben pro Label, zufälliger Ablenkwörter und Zwischenspeicherung der Antworten.
Potato hebt Schlüsselwörter auf zwei Arten hervor. Eine keyword_highlights_file markiert eine feste Liste von Begriffen in jedem Element, ganz ohne Modell, und ai_support fügt einen Keyword-Button hinzu, mit dem Annotierende ein LLM die Wörter markieren lassen, die für jedes Label relevant sind.
Die beiden Mechanismen scheitern auf unterschiedliche Weise, deshalb ist die Wahl wichtiger als die Einrichtung. Eine feste Liste ist deterministisch, kostet pro Element nichts und lässt sich in einem Methodenteil angeben, markiert aber dieselben Zeichenketten, egal was der umgebende Satz aussagt. Der LLM-Assistent liest jedes Element und kann eine Wendung markieren, die keine Wortliste erfasst hätte. Der Preis dafür ist ein API-Aufruf pro Anfrage und die Abhängigkeit von einem Modell, das sich ohne dein Zutun ändern kann.
Wie die Hervorhebung von Optionen und Schlüsselwörtern implementiert ist, steht in der Quelldokumentation.
Eine feste Schlüsselwortliste
Greif zur Schlüsselwortdatei, wenn alle Annotierenden dieselben Hervorhebungen sehen sollen und du später genau sagen können musst, welche das waren. Lass keyword_highlights_file auf eine CSV- oder TSV-Datei zeigen, dann markiert Potato jeden Treffer im Text des Elements mit einem umrandeten Kasten.
annotation_task_name: "Sentiment with keyword highlights"
task_dir: .
output_annotation_dir: annotation_output
export_annotation_format: jsonl

data_files:
  - data/reviews.json

item_properties:
  id_key: id
  text_key: text

keyword_highlights_file: data/sentiment_keywords.tsv

ui:
  label_colors:
    sentiment:
      positive: "(22, 163, 74)"
      negative: "(239, 68, 68)"

annotation_schemes:
  - annotation_type: span
    name: sentiment
    description: "Mark the phrases that carry sentiment. Highlighted keywords are suggestions, not answers."
    labels:
      - name: positive
        tooltip: "Phrases expressing a positive opinion"
      - name: negative
        tooltip: "Phrases expressing a negative opinion"

user_config:
  allow_all_users: true
Die Farben werden pro Schema und pro Label festgelegt, nicht global, denn eine Hervorhebung in derselben Farbe wie das Span-Label, das die annotierende Person gleich ziehen will, ist schlechter als gar keine.
Die Schlüsselwortdatei braucht eine Kopfspalte keyword. Eine Spalte label gibt an, zu welcher Kategorie der Begriff gehört, eine Spalte schema gibt an, für welches Annotationsschema er relevant ist, und eine optionale Spalte color überschreibt die Palette für dieses Label.
keyword,label,schema,color
excellent,positive,sentiment,(34, 197, 94)
terrible,negative,sentiment,#ef4444
excel*,positive,sentiment,
Ein * passt auf jede Folge von Wortzeichen, sodass excel* in einer einzigen Zeile excellent, excels und excelled abdeckt. Potato liest außerdem eine einfache Datei mit einem Schlüsselwort pro Zeile sowie JSON, JSONL oder YAML mit einer Schlüsselwortliste oder einer {keyword: label}-Zuordnung.
Zufällige Hervorhebungen für eine Studie
Wenn du misst, ob die Hervorhebung verändert, was Annotierende tun, bleibt dir nichts zum Vergleichen, wenn jede Person jedes Schlüsselwort sieht. keyword_highlight_settings dünnt die Schlüsselwörter aus und mischt Köder darunter.
keyword_highlights_file: data/keywords.csv

keyword_highlight_settings:
  keyword_probability: 0.5        # show half the matched keywords
  random_word_probability: 0.05   # highlight about 5% of other words
  random_word_label: "distractor"
  random_word_schema: "keyword"
keyword_probability: 0.5 ist der Wert, mit dem der Vergleich funktioniert, denn dann sieht jede annotierende Person im selben Korpus bei der Hälfte der Begriffe eine Hervorhebung und bei der anderen Hälfte keine. Die Auswahl wird pro Nutzer und pro Instanz zwischengespeichert und mit einem Hash aus Benutzername und Instanz-ID als Seed erzeugt, sodass jemand, der zu einem Element zurückkehrt, dasselbe sieht wie beim ersten Mal. Welche Wörter angezeigt wurden, wird im Feld keyword_highlights_shown der Verhaltensdaten festgehalten, sodass die Analyse darauf konditionieren kann.
Der LLM-Schlüsselwortassistent
KI-Hervorhebung von Schlüsselwörtern ist ein Button, kein Hintergrundprozess. Mit aktiviertem ai_support trägt jedes Annotationsformular die Buttons Hint, Keyword und Rationale, und ein Klick auf Keyword fragt das Modell, welche Wörter in diesem Element mit jedem verfügbaren Label zusammenhängen. Die Antwort kommt als Kastenüberlagerungen auf dem Text zurück.
ai_support:
  enabled: true
  endpoint_type: openai

  ai_config:
    model: gpt-4o-mini
    api_key: ${OPENAI_API_KEY}
    temperature: 0.3
    max_tokens: 800
    include:
      all: true
max_tokens: 800 ist der Standardwert und liegt nahe an der Untergrenze für diesen Assistenten. Die Prompts für Keyword und Rationale antworten in einer einzigen Antwort für alle Labels, daher schneidet ein kleineres Budget die Antwort ab und der Assistent bleibt ohne Fehlermeldung leer.
include.all: true schaltet die Assistenten für jedes Schema ein. Um sie nur für bestimmte Seiten und Schemata zu aktivieren, verwende special_include, das einem Seitenindex eine Annotations-ID und dieser eine Liste von Assistentennamen zuordnet:
ai_support:
  enabled: true
  endpoint_type: openai
  ai_config:
    model: gpt-4o-mini
    api_key: ${OPENAI_API_KEY}
    include:
      all: false
      special_include:
        "0":
          "0": ["hint", "keyword"]
        "1":
          "1": ["hint"]
Schlüsselwort-Hervorhebung braucht Text, den sie hervorheben kann, deshalb blendet Potato den Button bei Bildelementen aus, selbst wenn der Endpoint ein Vision-Modell ist. Bei einem Textelement bietet ein Vision-Modell alle drei Assistenten an.
Anthropic
ai_support:
  enabled: true
  endpoint_type: anthropic

  ai_config:
    model: claude-sonnet-4-20250514
    api_key: ${ANTHROPIC_API_KEY}
    temperature: 0.3
    max_tokens: 800
    include:
      all: true
Ollama, ohne API-Rechnung
ai_support:
  enabled: true
  endpoint_type: ollama

  ai_config:
    model: qwen3:0.6b
    base_url: http://localhost:11434
    temperature: 0.3
    max_tokens: 800
    include:
      all: true
Ein lokaler Endpoint ist den Qualitätsverlust wert, wenn der Korpus deinen Rechner nicht verlassen darf oder wenn du Zehntausende Elemente hervorhebst und die Kosten pro Element sonst das Studienbudget dominieren würden.
Stattdessen die wahrscheinlichen Labels hervorheben
Wenn das Problem eine lange Optionsliste ist und kein langer Text, ist option_highlighting das bessere Werkzeug. Es fragt das Modell nach den wahrscheinlichsten Optionen und zeigt sie mit voller Deckkraft und einem Stern an, während der Rest abgedunkelt wird. Jede Option bleibt anklickbar.
ai_support:
  enabled: true
  endpoint_type: openai
  ai_config:
    model: gpt-4o-mini
    api_key: ${OPENAI_API_KEY}
    temperature: 0.3
    max_tokens: 800

  option_highlighting:
    enabled: true
    top_k: 3
    dim_opacity: 0.4
    auto_apply: true
    schemas: null
    prefetch_count: 10
top_k: 3 passt zu einem Schema mit acht bis zwölf Labels, bei dem drei markierte Optionen das Lesen verkürzen, ohne die Antwort zu verstecken. Es funktioniert bei radio, multiselect, likert und select und hat keine Wirkung auf Spans, Freitext oder Slider.
Zwischenspeichern und Vorabladen
Ein LLM-Aufruf verlängert das Laden einer Seite um Sekunden, und wer warten muss, hört auf, den Button zu drücken. Zwischenspeichern auf der Festplatte und Vorabladen vor dem Cursor beseitigen den größten Teil dieser Wartezeit, und der Cache verhindert außerdem, dass du für ein Element, das jemand erneut aufruft, zweimal zahlst.
ai_support:
  enabled: true
  endpoint_type: openai
  ai_config:
    model: gpt-4o-mini
    api_key: ${OPENAI_API_KEY}
    max_tokens: 800
    include:
      all: true

  cache_config:
    disk_cache:
      enabled: true
      path: annotation_output/ai_cache.json

    prefetch:
      warm_up_page_count: 10
      on_next: 5
      on_prev: 2
on_next: 5 gegenüber on_prev: 2 spiegelt wider, wie sich Annotierende bewegen. Die meiste Navigation geht vorwärts, also geht auch das Budget nach vorn, mit genug hinter dem Cursor, um eine Korrektur abzudecken.
Eine vollständige Konfiguration
Die beiden Mechanismen lassen sich kombinieren. Die Schlüsselwortdatei gibt allen Annotierenden dieselben Basis-Hervorhebungen, und die Assistenten liegen hinter Buttons für die Elemente, zu denen die feste Liste nichts zu sagen hat.
annotation_task_name: "Entity annotation with keyword support"
task_dir: .
output_annotation_dir: annotation_output
export_annotation_format: jsonl

data_files:
  - data/documents.json

item_properties:
  id_key: id
  text_key: text

keyword_highlights_file: data/entity_keywords.csv

annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Mark people, organizations and locations."
    labels:
      - name: PERSON
        color: "#FECACA"
      - name: ORG
        color: "#BBF7D0"
      - name: LOCATION
        color: "#BFDBFE"

ai_support:
  enabled: true
  endpoint_type: openai

  ai_config:
    model: gpt-4o-mini
    api_key: ${OPENAI_API_KEY}
    temperature: 0.3
    max_tokens: 800
    include:
      all: true

  cache_config:
    disk_cache:
      enabled: true
      path: annotation_output/ai_cache.json
    prefetch:
      warm_up_page_count: 10
      on_next: 5
      on_prev: 2

user_config:
  allow_all_users: true
Starte den Server, und die Hervorhebungen erscheinen beim ersten Element:
potato start config.yaml -p 8000Wenn KI-Hervorhebung von Schlüsselwörtern aktiviert ist, markiert ein Klick auf den Keyword-Button die relevanten Begriffe im Annotationstext:
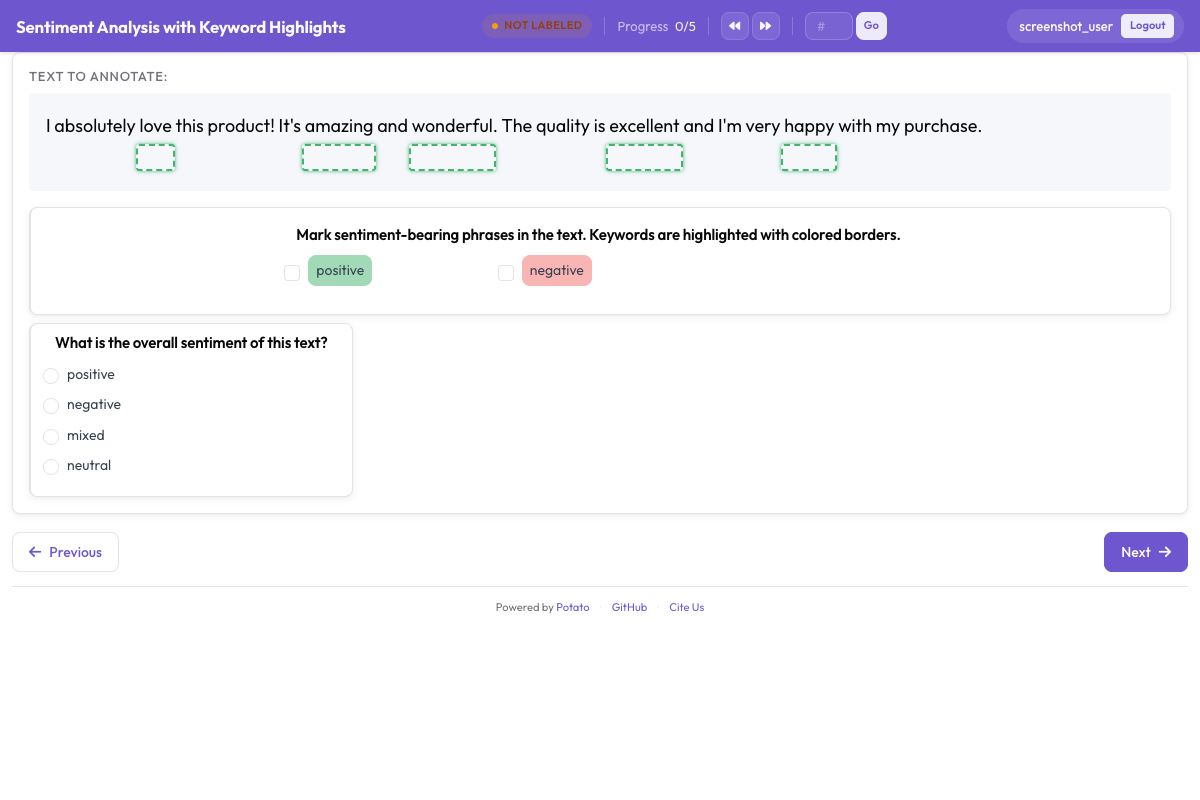 Schlüsselwörter und Entitäten, mit Kastenüberlagerungen markiert, lenken die Aufmerksamkeit der Annotierenden
Weiterführende Links
- AI-Unterstützung behandelt die Endpoint-Konfiguration für jeden Anbieter.
- Optionshervorhebung beschreibt die Variante, die Labels abdunkelt, ausführlicher.
- Spannen-Annotation behandelt das Schema, neben dem die Hervorhebungen stehen.
- Produktivitätsfunktionen behandelt das Format der Schlüsselwortdatei und die übrigen Einstellungen, die Annotierende schneller machen.