Психометрический движок
Теория ответов на задания для разметки. Каждая метка получает апостериорную вероятность и интервал чувствительности, без золотых меток и без LLM.
Новое в v2.7.0
Potato может рассматривать ваше исследование разметки как то, чем оно и является на самом деле: как измерительный инструмент. Психометрический слой на лету, по мере поступления разметки, подгоняет модель теории ответов на задания (IRT) и совместно оценивает истинную метку каждого объекта в виде вероятности, способность каждого разметчика со стандартной ошибкой, трудность каждого объекта и диагностику различающей способности для каждого объекта, которая отмечает вероятные ошибки в кодбуке.
Золотые метки не нужны, и LLM не участвует. Модель (многоклассовое обобщение GLAD, Whitehill et al. 2009) выводит всё из самой картины согласия, так же как стандартизированный тест узнаёт, какие вопросы трудные, хотя никто этого не объявлял. Подгонка детерминирована и на масштабе исследования разметки занимает миллисекунды.
Конфигурация
# Adaptive routing is opt-in via the standard assignment strategy key.
# Omit this line to keep your existing strategy and use psychometrics
# as a pure analytics layer.
assignment_strategy: psychometric

# Give items a redundancy target so early-stopped items translate into
# concrete saved judgments on the dashboard.
num_annotators_per_item: 4

psychometrics:
  enabled: true
  schema: sarcasm            # scheme to model; default: first radio/likert scheme
  refit_interval: 5          # refit after this many new labels (fits are ~ms)
  min_observations: 20       # cold-start gate before adaptive routing engages
  min_annotators_per_item: 2 # never early-stop an item below this many annotators
  confidence_threshold: 0.95 # posterior at which an item counts as resolved
  cost_per_judgment: 0.08    # optional: expresses savings in currency
  discrimination_flag_threshold: -0.2  # codebook-bug flag sensitivity
Поддерживаются категориальные схемы с одним вариантом ответа: radio и likert (пункты шкалы Лайкерта рассматриваются как номинальные категории). Схемы с множественным выбором не моделируются.
Метки с погрешностями
Вместо sarcastic (2 of 3 votes) экспорт пишет sarcastic, p = 0.94 [0.88 – 0.97]. Вероятность равна апостериорной вероятности модели, которая учитывает, кто голосовал, а не только сколько, а интервал представляет собой полосу чувствительности в ±1 стандартную ошибку по оценкам способности.
Дальше можно обучаться на мягких метках, отбирать в оценочные наборы только объекты с высокой уверенностью или считать объекты с низкой вероятностью действительно неоднозначными, а не шумом. Дополняющий подход, при котором распределения собираются прямо у разметчиков, описан на странице разметка мягкими метками.
Способность разметчика без приукрашивания
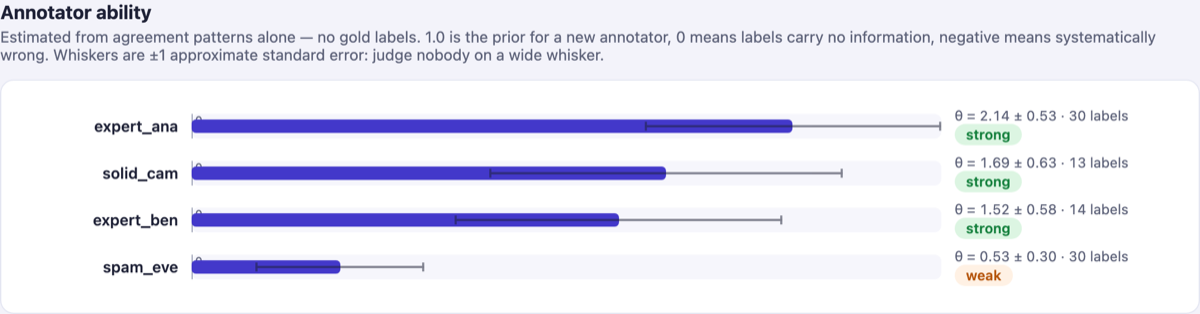
Способность θ оценивается по картине согласия. Значение 1,0 служит априорным для нового разметчика, 0 означает, что его метки не несут информации, а отрицательные значения означают систематические ошибки. Каждая оценка идёт со стандартной ошибкой: у разметчика с 12 метками широкие усы, и панель об этом говорит.
Не принимайте кадровых решений по широким усам. Стандартные ошибки приближённые (информация Фишера в моде) и по построению несколько оптимистичны.
Детектор ошибок в кодбуке
Трудность объекта оценивается совместно со способностью, но полезнее другой сигнал, различающая способность: корреляция между способностью разметчика и правильностью ответа на каждом объекте.
Когда различающая способность сильно отрицательна, то есть с общим консенсусом расходятся именно ваши лучшие разметчики, ошибка или неоднозначность обычно кроется в инструкции для этого объекта, а не в разметчиках. Панель выводит такие объекты в разделе «Likely codebook bugs». Исправьте инструкцию, а затем вернитесь к этим объектам. Разбирать их команды обычно приходят в Multiplayer Rooms.
Адаптивная маршрутизация
При assignment_strategy: psychometric, когда разметчик запрашивает работу, оставшиеся объекты ранжируются по точному ожидаемому приросту информации за один шаг, если этот разметчик разметит этот объект. Объекты с высокой неопределённостью сначала уходят разметчикам с высокой способностью, а объекты, чья апостериорная вероятность уже превышает confidence_threshold (при не менее чем min_annotators_per_item разметчиках), перестают расходовать бюджет. Число сэкономленных суждений по сравнению со схемой с фиксированным N на объект показывается на панели, а если задан cost_per_judgment, то и в деньгах.
Два практических замечания:
- Холодный старт. Пока не набралось
min_observationsметок, назначение откатывается к случайному, потому что модели нужны пересекающиеся разметчики, чтобы отделить способность от трудности. На этом этапе панель показывает индикатор прогрева. - Пакеты. Назначение происходит, когда очередь пользователя пополняется. Ранжирование актуальнее всего при коротких очередях; очень большие пакеты на пользователя размывают адаптивность.
Анализ мощности до начала трат
Каждый проект разметки гадает, сколько разметчиков нужно на объект. Планировщик исследования отвечает на этот вопрос моделированием Монте-Карло с фиксированным зерном:
python -m potato.psychometrics.design --items 500 --accuracy 0.75 \
--classes 3 --target-ci 0.10 --cost 0.08ann/item alpha 95% interval width majority acc judgments cost
2 0.392 [ 0.330, 0.439] 0.109 0.751 1000 80.00
3 0.388 [ 0.338, 0.431] 0.093 0.864 1500 120.00 <- recommended
Рекомендуется наименьшая избыточность, при которой 95%-й интервал для α Криппендорфа уже, чем --target-ci, то есть самая дешёвая схема, которая всё ещё даёт обоснованно точную оценку согласованности. Входное значение --accuracy лучше всего измерить на небольшом пилоте. Тот же анализ доступен на панели и через админ-API (GET /psychometrics/api/design).
Его также можно запустить интерактивно в браузере в калькуляторе мощности разметки.
Эндпоинты
Все эндпоинты требуют прав администратора (RBAC VIEW_ADMIN_DASHBOARD; подходит общий ключ админ-API, а в режиме отладки также запросы с машины самого сервера).
| Эндпоинт | Назначение |
|---|---|
GET /psychometrics/dashboard | Живая панель |
GET /psychometrics/api/stats | Агрегаты для панели (принудительно выполняет новую подгонку) |
GET /psychometrics/api/export | Расширенный экспорт: апостериорные вероятности, полосы, способности |
GET /psychometrics/api/design | Анализ мощности |
Как это соотносится с MACE
В Potato также есть MACE, который в виде апостериорной аналитики оценивает компетентность разметчиков и предсказанные метки. Это два родственных метода из одной литературы с разными задачами.
| MACE | Психометрия | |
|---|---|---|
| Модель разметчика | компетентность: знает или угадывает | непрерывная способность со стандартными ошибками |
| Модель объекта | нет | трудность и различающая способность (флаги ошибок в кодбуке) |
| Когда работает | пакетная аналитика после N разметок | на лету, в цикле назначения |
| Управляет назначением | нет | да, через маршрутизацию по приросту информации и раннюю остановку |
| Неопределённость меток | энтропия | апостериорная вероятность и интервал чувствительности |
| Планирование до исследования | нет | анализ мощности методом Монте-Карло |
MACE подходит для быстрой оценки компетентности на любой категориальной схеме (он охватывает и multiselect). Психометрия нужна, когда требуется измерение с учётом трудности, которое влияет на исследование прямо по ходу работы.
Устранение неполадок
- Панель бесконечно показывает «warming up». Модели нужны хотя бы две разные метки и пересекающиеся разметчики. При одном разметчике или единогласных метках подгонка вырождена по построению. Добавьте разметчиков или уменьшите
min_observations. assignment_strategy: psychometricзадан, но маршрутизация выглядит случайной. Это откат на этапе холодного старта. Проверьте индикатор прогрева иmin_observations.- Все способности близки к 1,0 и с большими усами. Пересечения пока недостаточно. Способности расходятся по мере того, как у разметчиков накапливаются общие объекты.
- 404 на
/psychometrics/.... В конфигурации нет блокаpsychometrics.enabled: true.
Дополнительные материалы
- Truth Serum: оценка по методу взаимного предсказания, второй сигнал качества без золотых меток
- Стратегии назначения задач
- Согласованность разметчиков
- Сколько нужно разметчиков?
- Исходная документация