Potato face à LangSmith et Langfuse pour l'évaluation d'agents : une comparaison pratique
Ce pour quoi LangSmith, Langfuse et Potato sont chacun conçus en évaluation d'agents, comment faire passer des traces de l'un à l'autre, et où le jugement humain est mesuré.
LangSmith et Langfuse sont conçus pour tracer et surveiller des applications LLM en production. Potato est conçu pour recueillir des jugements humains structurés sur ce que montrent ces traces et pour mesurer à quel point les juges sont d'accord. Les équipes qui ont besoin des deux capturent en général dans un outil d'observabilité et mènent l'étude humaine dans Potato.
Les trois outils se recoupent assez pour que la comparaison revienne souvent, et ils ne se recoupent qu'en un point. Tous trois peuvent attacher un jugement humain à une exécution d'agent enregistrée. Ce autour de quoi ils sont organisés diffère, et cette différence décide lequel convient à la question que vous vous posez.
Ce pour quoi chaque outil est conçu
LangSmith instrumente, trace et débogue des applications LLM, avec l'intégration la plus poussée dans LangChain et LangGraph. Les traces d'une application construite sur ces frameworks arrivent sans instrumentation supplémentaire, et la plateforme est organisée autour de l'inspection des exécutions, du suivi de la latence et du coût, et du lancement d'expériences d'évaluation sur des jeux de données. Ses files d'annotation prennent en charge des clés de feedback avec grille, un nombre configurable de relecteurs par exécution, des files par paires et des relecteurs qui ne voient pas le feedback des autres.
Langfuse couvre le même terrain en open source, pour n'importe quelle application LLM plutôt qu'un seul framework, et regroupe la gestion des prompts avec le traçage. La notation est disponible au niveau de la trace et au niveau de l'observation (span), et ses score configs catégorielles permettent de définir un ensemble fixe de labels et d'attacher plusieurs scores nommés à un même span.
Potato est une plateforme d'annotation qui a été étendue aux traces d'agents. Elle est organisée autour de l'étude plutôt que de l'application, si bien que ses primitives sont qui annote quoi, combien de personnes voient chaque item, ce qui se passe quand elles ne sont pas d'accord, et ce que disent les statistiques d'accord sur la question de savoir si les labels veulent dire quelque chose. Les traces d'agents sont un type d'item parmi les 61 types d'annotation que la version actuelle enregistre, et c'est pourquoi elles héritent de l'accord inter-annotateurs, des phases d'entraînement, de l'adjudication et du crowdsourcing sans que rien de cela ait été reconstruit pour les agents.
Aucun des trois n'est meilleur dans l'absolu. La question utile est de savoir si votre goulot d'étranglement est de voir ce qu'a fait l'agent, ou de pouvoir vous fier aux labels humains que vous recueillez à son sujet.
Faire passer des traces de l'un à l'autre
Potato lit les traces après coup au lieu d'instrumenter votre code, et enregistre donc des convertisseurs pour 15 formats de trace :
python -m potato.trace_converter --list-formatsLa liste couvre react, openai, anthropic, langchain, langfuse, multi_agent, mcp, otel, atif, webarena, web_agent, swebench, swe_agent_trajectory, claude_code et aider. Les exports d'exécutions LangSmith passent par le convertisseur langchain, puisqu'il n'en existe pas de langsmith distinct. Les journaux CrewAI, AutoGen et LangGraph passent par multi_agent.
Convertir un export se fait en une commande dans chaque sens du flux de travail :
# LangSmith runs, exported from LangSmith, converted for annotation
python -m potato.trace_converter \
  --input langsmith_export.jsonl \
  --output data/traces.jsonl \
  --input-format langchain

# Langfuse traces, exported from Langfuse
python -m potato.trace_converter \
  --input langfuse_traces.json \
  --output data/traces.jsonl \
  --input-format langfuse
Si votre framework ne figure pas dans la liste, --auto-detect choisit un convertisseur d'après la signature des champs, et un nouveau convertisseur est une sous-classe de BaseTraceConverter. La détection retient le premier convertisseur qui correspond, donc nommez le format explicitement une fois que vous savez lequel convient à vos fichiers.
Les traces peuvent aussi arriver sans étape d'export. L'ingestion de traces de Potato accepte les exécutions envoyées vers /api/traces/* au format de payload des exécutions LangSmith, si bien qu'un callback LangChain ou le SDK de traçage peut pousser des exécutions dans la file d'annotation au fil de l'eau :
trace_ingestion:
  enabled: true
  api_key: "your-api-key"
  notify_annotators: true
Ce que Potato apporte une fois la trace importée
C'est dans les schémas qu'une plateforme d'annotation justifie sa place. trajectory_eval porte le label de correction, une taxonomie d'erreurs hiérarchique avec sous-types, des niveaux de gravité aux poids configurables et un score de qualité cumulé, dans un seul schéma attaché à une seule trace :
annotation_schemes:
  - annotation_type: trajectory_eval
    name: step_evaluation
    description: "Mark each step and classify anything that went wrong"
    steps_key: conversation
    step_text_key: text
    error_types:
      - name: execution
        subtypes: [wrong_tool, wrong_args, api_error]
    severities:
      - name: minor
        weight: -1
      - name: critical
        weight: -10
    show_score: true
Les poids de gravité sont ce qui compte pour comparer des traces. Un simple décompte des étapes marquées dit qu'un agent a fait quatre erreurs et un autre deux, et le score pondéré dit si ces quatre étaient cosmétiques et les deux dangereuses.
L'évaluation comparative passe par le schéma pairwise, qui a trois modes. Le mode binaire affiche deux tuiles cliquables avec un bouton d'égalité facultatif, le mode échelle remplace le choix par un curseur entre les deux items, et le mode multi_dimension demande un verdict A/B indépendant pour chaque dimension nommée, comme l'utilité, l'exactitude et la sécurité.
Les agents de programmation ont leur propre affichage, parce qu'un diff unifié lu comme une chaîne JSON est impossible à relire :
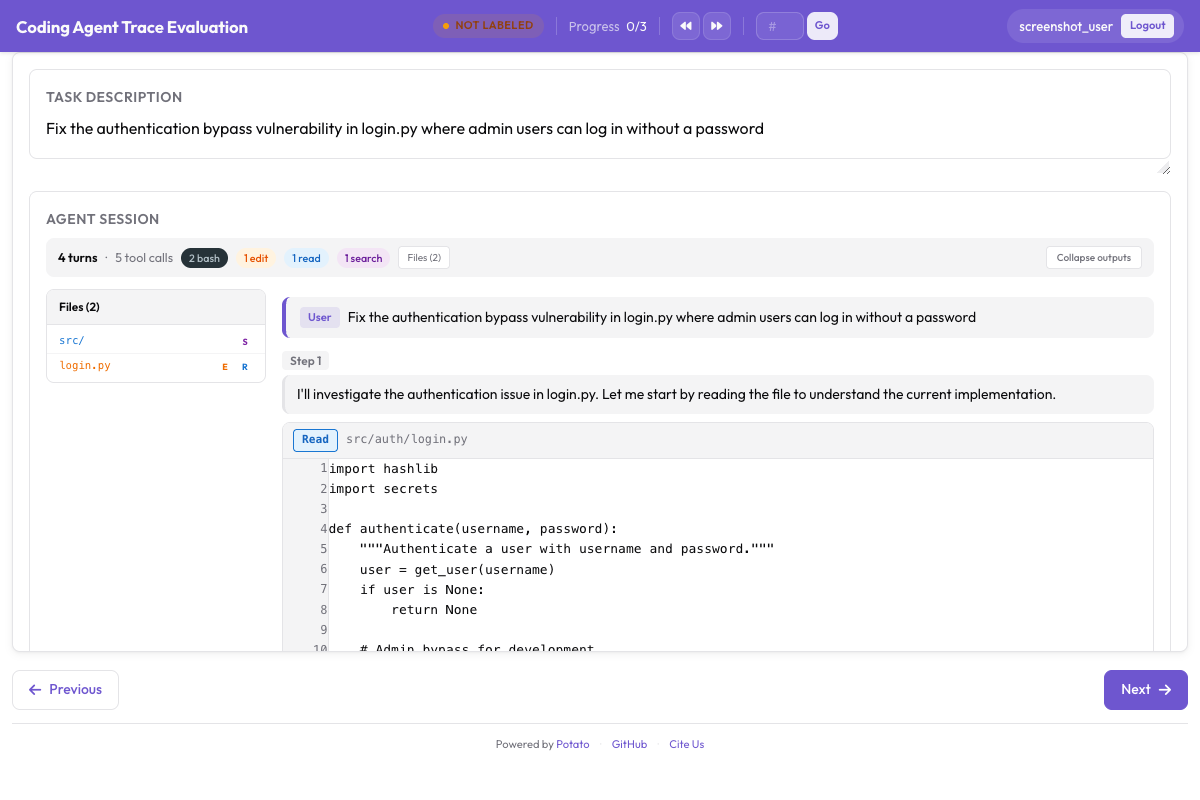 L'affichage des traces de programmation de Potato, avec rendu des diffs unifiés, coloration syntaxique et arborescence de fichiers
L'affichage coding_trace rend les diffs avec une arborescence de fichiers et replie les longues sorties de terminal, et le schéma code_review recueille des commentaires ancrés à des lignes dans des catégories configurables, des dimensions de notation par fichier et un verdict à la manière d'une pull request. L'exportateur coding_eval écrit ensuite des labels pour modèles de récompense de processus, des annotations de revue de code, des paires de préférence DPO et des scores compatibles SWE-bench, c'est-à-dire la forme dont les données d'entraînement ont besoin et non celle dont a besoin un tableau de bord.
Les traces d'agents web s'affichent sous forme de captures d'écran avec des surcouches SVG des actions et une pellicule :
 Visionneuse de traces d'agents web montrant des captures d'écran avec surcouches SVG des actions et navigation par pellicule
Les exécutions multi-agents ont leurs propres surfaces d'annotation au lieu d'être aplaties en un seul flux d'étapes. Le registre contient des schémas pour un graphe d'interaction modifiable par l'annotateur, l'attribution des échecs entre agents, la revue des passations, des fiches de score par agent et par équipe, la contention d'outils sur une chronologie partagée et l'étiquetage des comportements émergents. Il en va de même pour les agents incarnés et multimodaux, avec les trajectoires d'utilisation d'ordinateur, l'interaction vocale en full-duplex et l'ancrage temporel dans la vidéo comme schémas à part entière.
Mesurer les jugements, pas seulement les recueillir
La différence qui apparaît le plus tard dans un projet, c'est ce qui se passe quand deux annotateurs ne sont pas d'accord. Potato traite un désaccord comme une mesure plutôt que comme un conflit à résoudre, si bien que les mêmes statistiques d'accord, la même file d'adjudication, les mêmes phases d'entraînement et les mêmes items de référence qu'utilise une étude d'annotation de texte s'appliquent aux traces d'agents sans configuration supplémentaire. La comparaison d'outils de Potato relève, à la date de la vérification du 2026-06-24, que les plateformes de traçage sont conçues pour recueillir les jugements humains sous forme de scores et qu'aucune ne documente de statistique de fiabilité sur ces jugements, et que Langfuse remplace une annotation antérieure sur la même trace, de sorte qu'une double annotation indépendante y demande un contournement.
Cela compte quand l'évaluation sert de preuve. Un taux de réussite construit à partir de jugements uniques non relus n'a pas de barre d'erreur, et un relecteur qui a dérivé ressemble exactement à un agent qui s'est amélioré.
Observer un agent pendant son exécution
Potato peut aussi exécuter un agent dans la page d'annotation au lieu de rejouer un enregistrement. Le bloc live_agent connecte un modèle de vision à un navigateur headless et diffuse la session à l'annotateur, qui peut la mettre en pause, envoyer des instructions ou prendre le contrôle manuel :
live_agent:
  endpoint_type: anthropic_vision
  ai_config:
    model: claude-sonnet-4-20250514
    api_key: ${ANTHROPIC_API_KEY}
  max_steps: 30
  allow_takeover: true
  allow_instructions: true

instance_display:
  fields:
    - key: agent_trace
      type: live_agent
      label: "Live Agent Session"
      display_options:
        show_overlays: true
        show_filmstrip: true
Trois situations font que cela vaut la mise en place, par rapport à la relecture a posteriori. Arrêter une exécution avant une action destructrice est une mesure de sécurité que des traces enregistrées ne peuvent pas offrir. Une prise de contrôle humaine enregistrée en cours d'exécution devient une donnée de démonstration. Et observer comment un agent se remet d'une intervention répond à une question qu'aucune trace terminée ne contient.
Les utiliser ensemble
La configuration de production courante utilise les deux, et le partage est net parce que les outils veulent des choses différentes. Instrumentez l'agent avec LangSmith ou Langfuse et laissez chaque exécution être tracée. Échantillonnez les exécutions qui méritent un avis humain, en général les échecs, les cas limites et un échantillon témoin aléatoire. Convertissez-les pour Potato, menez l'étude d'annotation avec plusieurs annotateurs par trace et lisez le rapport d'accord à côté des scores. Renvoyez les décomptes de la taxonomie d'erreurs vers le développement, où la distribution des sous-types indique si vous avez un échec systématique ou une longue traîne.
python -m potato.trace_converter \
  --input langfuse_failed_traces.json \
  --output data/traces_to_review.jsonl \
  --input-format langfuse

potato start config.yaml -p 8000
Choisir
Tournez-vous vers LangSmith quand l'application est construite sur LangChain ou LangGraph et que le besoin est la visibilité en production, puisque les traces arrivent sans travail d'instrumentation et que le service géré règle la question de l'infrastructure. Tournez-vous vers Langfuse quand vous voulez cette même visibilité en open source avec plusieurs fournisseurs, et le versionnage des prompts dans le même outil. Tournez-vous vers Potato quand le résultat dont vous avez besoin est un ensemble défendable de labels humains, quand l'étude exige plusieurs annotateurs par item et un chiffre d'accord, quand les agents sont des agents de programmation, multi-agents ou incarnés au point que la trace demande un affichage conçu pour elle, ou quand les données doivent rester sur votre propre infrastructure. Potato est sous licence GPL-3.0-or-later et auto-hébergé, sans coût par siège ni par trace.
Ce qui est dit ici de LangSmith et de Langfuse reflète leur documentation telle que consultée le 2026-06-24, et les deux évoluent vite. Les corrections sont bienvenues sur le dépôt GitHub. Pour la mise en place elle-même, voir le guide d'évaluation d'agents, et pour un exemple complet allant des traces brutes aux jugements exportés, voir Évaluer des agents d'IA.