Cómo recopilar datos de recompensa de proceso para entrenar mejores agentes de coding
Recopila etiquetas de recompensa por paso para entrenar PRM en Potato, con los modos de primer error y por paso y un script que da forma a la exportación para el entrenamiento.
¿Qué son los modelos de recompensa de proceso?
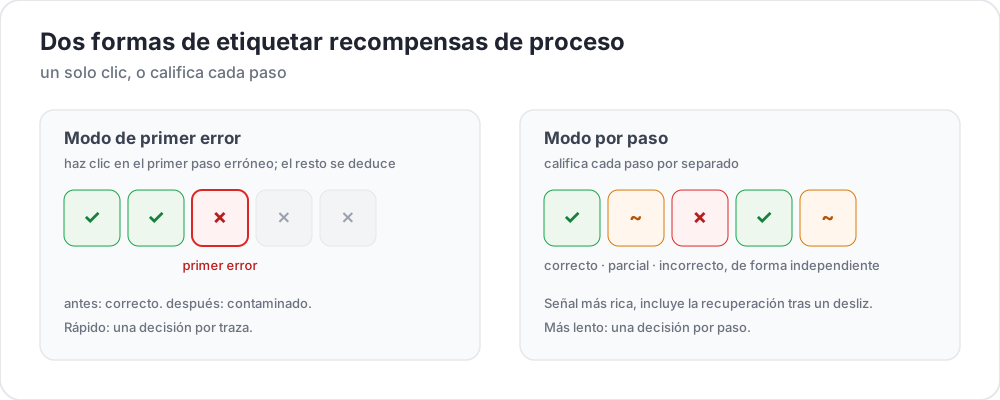 Dos formas de etiquetar recompensas de proceso
Los modelos de recompensa de resultado solo miran el final de la trayectoria de un agente de coding: ¿compiló el código?, ¿pasaron las pruebas?, ¿se resolvió el problema? Los modelos de recompensa de proceso, en cambio, puntúan cada paso intermedio. Con una señal en cada paso, el entrenamiento puede señalar dónde se equivocó el agente.
Hay trabajo reciente en esta dirección. AgentPRM redefine las recompensas de proceso para tareas de agente: puntúa cada acción por el avance que logra hacia el objetivo y no por si es correcta, y reporta más de 8× mejor eficiencia de cómputo que las líneas base con las que se compara. ToolRM encontró que los modelos de recompensa entrenados con salidas en lenguaje natural juzgan mal las llamadas a herramientas, y construyó modelos de recompensa específicos para herramientas junto con FC-RewardBench para evaluarlos. En contraste, DeepSWE entrena un agente de coding solo con una recompensa de resultado dispersa, si pasan las pruebas, y alcanza 42,2 % de Pass@1 y 59 % con escalado en tiempo de inferencia en SWE-bench Verified. Ese es el montaje basado solo en resultados que la supervisión de proceso intenta mejorar.
Lo que todos ellos necesitan es anotación humana a nivel de paso, y ahí suele estar el cuello de botella. Para la referencia del esquema, consulta la documentación de recompensa de proceso.
Dos modos de anotación
Modo de primer error
El anotador lee la trayectoria de arriba abajo y hace clic en el primer paso en el que el agente se equivoca. Todos los pasos anteriores se registran como correctos, y ese paso y todos los siguientes como incorrectos. Es rápido porque hay una sola decisión por traza, y encaja con el caso habitual en el que un agente que se desvía ya no se recupera.
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent makes a mistake. Steps after it are flagged automatically."
    mode: first_error
    steps_key: structured_turns
    step_text_key: content
Modo por paso
Cada paso recibe su propia etiqueta, lo que recoge lo que el modo de primer error no puede: una recuperación parcial, un desvío inofensivo o un paso que está bien por sí solo y es erróneo en su contexto. allow_neutral añade la tercera opción al estilo de PRM800K.
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Rate each step correct, neutral, or incorrect"
    mode: per_step
    steps_key: structured_turns
    step_text_key: content
    allow_neutral: true
    inline_with_trace: true
inline_with_trace coloca los controles junto a cada paso en la visualización, lo que importa en una traza larga, donde un panel aparte hace que el anotador pierda el punto en el que estaba.
Montar el proyecto
Paso 1: prepara las trazas
Cada línea es una trayectoria. steps_key nombra la lista de pasos y step_text_key nombra el campo de cada paso que se muestra:
{
  "id": "trace_001",
  "issue_description": "Fix the TypeError in parse_config() when the config file is empty",
  "structured_turns": [
    {"step_idx": 0, "type": "thinking", "content": "I need to find where the TypeError occurs. Let me read the file."},
    {"step_idx": 1, "type": "file_read", "content": "def parse_config(path):\n    with open(path) as f:\n        data = json.load(f)\n    return data['settings']"},
    {"step_idx": 2, "type": "thinking", "content": "When the file is empty json.load returns None, so None['settings'] raises. Add a check."},
    {"step_idx": 3, "type": "file_edit", "content": "+    if data is None:\n+        return {}"},
    {"step_idx": 4, "type": "bash_command", "content": "python -m pytest tests/test_config.py -v  ->  2 passed"}
  ]
}
La conversión desde otro formato de agente es un paso de CLI:
python -m potato.trace_converter \
  --input claude_code_sessions.json \
  --input-format claude_code \
  --output data/traces.jsonl
--list-formats muestra los formatos que admite, entre ellos claude_code, aider, swe_agent_trajectory, swebench, react, langchain y nueve más. Usa --auto-detect cuando no estés seguro de cuál tienes.
Paso 2: escribe la configuración
annotation_task_name: "PRM Data Collection"
task_dir: "."

data_files:
  - "data/traces.jsonl"

item_properties:
  id_key: id
  text_key: issue_description

instance_display:
  fields:
    - key: issue_description
      type: text
      label: "Issue"

    - key: structured_turns
      type: coding_trace
      label: "Agent trajectory"
      display_options:
        diff_view: unified
        show_file_tree: true
        show_reasoning: true
        terminal_theme: dark
        collapse_long_outputs: true
        max_output_lines: 50

annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent makes an error"
    mode: first_error
    steps_key: structured_turns
    step_text_key: content

  - annotation_type: radio
    name: outcome
    description: "Did the agent resolve the issue?"
    labels:
      - name: resolved
        text: "Fully resolved"
      - name: partial
        text: "Partially resolved"
      - name: not_resolved
        text: "Not resolved"

  - annotation_type: text
    name: error_description
    description: "If the trajectory went wrong, describe the error briefly"
    rows: 3
    placeholder: "e.g. edited the wrong file"
    label_requirement:
      required: false

num_annotators_per_item: 2

attention_checks:
  enabled: true
  items_file: "data/attention_checks.json"
  frequency: 20
  min_response_time: 20.0
  failure_handling:
    warn_threshold: 2
    block_threshold: 5

user_config:
  allow_all_users: false
  users:
    - reviewer1@example.com
    - reviewer2@example.com
    - reviewer3@example.com

output_annotation_dir: "annotation_output/"
export_annotation_format: jsonl
Un objeto de etiqueta se identifica por name. El campo text es lo que lee el anotador, así que el valor almacenado sigue siendo un identificador estable aunque cambie la redacción.
min_response_time: 20.0 es el control útil aquí. Nadie lee una trayectoria de varios pasos con diffs en veinte segundos, así que detecta las prisas que un límite de tiempo por traza no detectaría.
Paso 3: arranca el servidor
potato start config.yaml -p 8000Exportar para el entrenamiento
El exportador coding_eval escribe directamente los formatos de entrenamiento, así que no tienes que darles forma tú:
python -m potato.export -c config.yaml -f coding_eval -o ./export/Escribe prm_training_data.jsonl con las etiquetas por paso, preference_pairs.jsonl con trazas elegidas y rechazadas al estilo DPO construidas a partir de las anotaciones, swebench_results.jsonl y code_reviews.jsonl. Los cuatro se escriben por defecto. Para acotarlo, pasa la opción types del exportador: --option types=prm,preference. Si un tipo solicitado no encontró datos en el estudio, lo informa en lugar de escribir un archivo vacío.
La anotación se guarda bajo el nombre del esquema como una lista steps más el modo. reward vale 1 para correcto, -1 para incorrecto, 0 para neutral y null para un paso que nadie juzgó:
{
  "step_rewards": {
    "mode": "first_error",
    "steps": [
      {"reward": 1, "source": "human", "verified": true},
      {"reward": 1, "source": "human", "verified": true},
      {"reward": -1, "source": "human", "verified": true},
      {"reward": -1, "source": "human", "verified": true}
    ]
  }
}
Recurre a un script solo cuando necesites una forma que el exportador no escribe. El motivo habitual es tratar tú mismo los pasos sin juzgar, ya que un paso que nadie juzgó vale null y no 0:
import json
from pathlib import Path

SCHEME = "step_rewards"

examples = []
for f in Path("export/").rglob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            rec = json.loads(line)
            payload = (rec.get("labels", rec) or {}).get(SCHEME)
            if not payload:
                continue

            steps = payload.get("steps", [])
            # Drop traces with unjudged steps rather than guessing at them.
            if any(s.get("reward") is None for s in steps):
                continue

            item = items_by_id[rec["instance_id"]]      # your own data file
            examples.append({
                "trace_id": rec["instance_id"],
                "prompt": item["issue_description"],
                "steps": [
                    {"content": src["content"], "label": s["reward"]}
                    for src, s in zip(item["structured_turns"], steps)
                ],
            })

with open("prm_labels.jsonl", "w") as out:
    for ex in examples:
        out.write(json.dumps(ex) + "\n")

print(f"Wrote {len(examples)} traces")
Los pares de preferencia salen de las mismas anotaciones. Cuando dos trazas abordaron el mismo problema, el exportador las empareja y toma como traza elegida aquella cuyo primer error aparece más tarde, o que no tiene ninguno.
Análisis
Dónde cae el primer error
import json
from pathlib import Path

SCHEME = "step_rewards"

traces = []
for f in Path("export/").rglob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            payload = (json.loads(line).get("labels", {}) or {}).get(SCHEME)
            if payload:
                traces.append(payload)

positions = []
all_correct = 0
for t in traces:
    steps = t.get("steps", [])
    first = next((i for i, s in enumerate(steps) if s.get("reward") == -1), None)
    if first is None:
        all_correct += 1
    elif len(steps) > 1:
        positions.append(first / (len(steps) - 1))

print(f"Traces annotated: {len(traces)}")
print(f"No errors: {all_correct} ({all_correct / len(traces):.1%})")
if positions:
    print(f"Average first-error position: {sum(positions) / len(positions):.2f} (0=start, 1=end)")
Acuerdo sobre el primer error
Dos anotadores rara vez eligen el mismo paso, y el acuerdo exacto subestima cuánto coinciden. Agrupar antes la posición en intervalos da una comparación más informativa:
def bin_position(steps):
    first = next((i for i, s in enumerate(steps) if s.get("reward") == -1), None)
    if first is None:
        return "all_correct"
    return "early_error" if first < len(steps) / 2 else "late_error"
Compara esos intervalos entre los anotadores que comparten ítems, usando el solapamiento que te da num_annotators_per_item.
Consejos
Usa el modo de primer error si buscas velocidad. Para entrenar un PRM que guíe la búsqueda, da señal suficiente por una fracción del coste de anotación, y de todas formas la mayoría de los agentes fallan en cascada.
Usa el modo por paso cuando necesites el detalle. La recuperación parcial y los desvíos inofensivos solo existen como etiquetas en el modo por paso.
Empieza con anotadores con experiencia. La tarea implica leer código, diffs y salida de terminal. Empieza con un grupo pequeño, mide el acuerdo, calibra con ejemplos compartidos y luego amplía.
Fija un tiempo mínimo de respuesta. Las trayectorias se alargan, y un mínimo evita que los anotadores pasen de largo por los diffs.
Haz una pasada de calibración. Que todo el mundo etiquete las mismas diez a veinte trazas y comentad los desacuerdos antes de que empiece la anotación de producción.