Anotación de agentes de coding: evalúa trazas de Claude Code, Aider y SWE-Agent
Potato muestra las trazas de agentes de coding como diffs y bloques de terminal, con esquemas de recompensa de proceso y revisión de código y conversores para Claude Code, Aider y SWE-Agent.
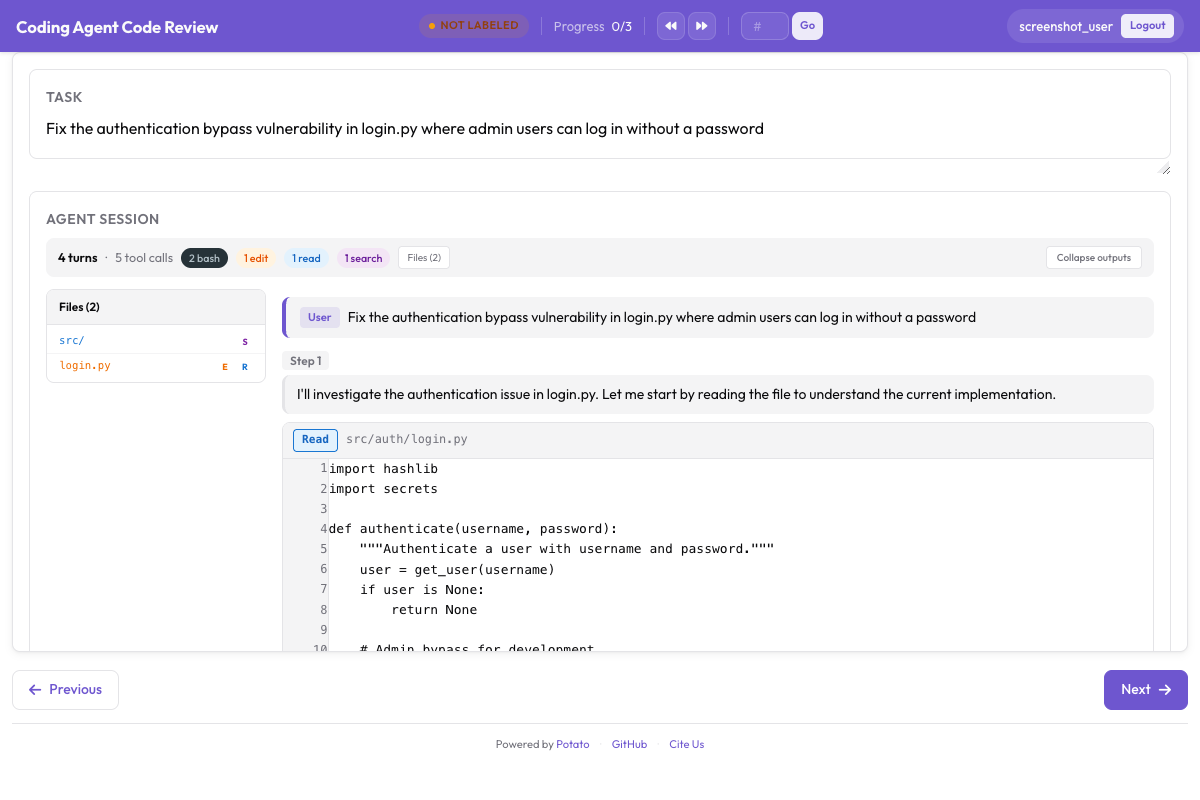
Potato ya anota directamente las sesiones de agentes de coding. Una traza se muestra como diffs unificados, bloques oscuros de terminal, lecturas de archivos con números de línea y un árbol con todos los archivos que tocó el agente. Hay tres conversores para formatos de agentes de coding (claude_code, aider y swe_agent_trajectory), además de los otros doce formatos de trazas que Potato ya lee, y dos esquemas de anotación pensados para estos datos: process_reward para la corrección a nivel de paso y code_review para revisar los diffs al estilo de GitHub.
Una ejecución de un agente de coding es una trayectoria larga de lecturas de archivos, ediciones, comandos de terminal y razonamiento. Una interfaz de anotación de texto plano lo aplana todo en un muro de caracteres, y por eso los equipos que evalúan agentes han tendido a escribir su propia interfaz de revisión y a quedarse con conjuntos de datos que nadie más puede usar. Para la referencia completa, consulta la documentación de anotación de agentes de coding y la guía de evaluación de agentes.
Dos cosas que comprobar antes de planificar un estudio
Las transcripciones de Claude Code no contienen el texto de razonamiento del modelo. Los archivos conservan el bloque thinking y su firma, pero descartan el contenido: se midieron 6393 bloques en 40 sesiones locales y ninguno tenía texto. La traza convertida informa del recuento, para que la ausencia quede a la vista en lugar de pasar inadvertida. Si los anotadores necesitan el razonamiento para juzgar los pasos, captúralo en vivo con claude -p --output-format stream-json o con el Agent SDK en lugar de leerlo después desde el disco.
Las transcripciones también llevan rutas absolutas, nombres de ramas, detalles del entorno y cualquier código fuente que haya leído la sesión. Elimina esos datos antes de compartir un conjunto de datos y obtén el consentimiento de las personas a quienes pertenecen las sesiones.
La visualización de trazas
Las trazas de código se muestran mediante el tipo de visualización coding_trace, declarado en instance_display junto con cualquier otra cosa que deba ver el anotador. Potato separa lo que se muestra de lo que se pregunta, así que la misma visualización de trazas funciona con cualquier esquema de anotación:
instance_display:
  layout:
    direction: vertical
    gap: 16px
  fields:
    - key: task_description
      type: text
      label: "Task"
    - key: structured_turns
      type: coding_trace
      label: "Agent Session"
      display_options:
        show_file_tree: true
        diff_view: unified
        collapse_long_outputs: true
        max_output_lines: 50
        terminal_theme: dark
        show_step_numbers: true
        show_reasoning: true
Cada llamada a herramienta se muestra según lo que hizo la herramienta, de modo que el anotador lee un diff como un diff y no como texto escapado:
| Herramienta | Visualización |
|---|---|
Read | Bloque de código con números de línea |
Edit, Replace | Diff unificado con líneas en rojo y verde |
Write, Create | Bloque de código de archivo nuevo, todo en verde |
Bash, Terminal, Shell | Bloque oscuro de terminal con un prompt $ |
Grep, Glob, Search, Find | Bloque de código con los resultados de búsqueda |
| Cualquier otra | Entrada y salida con formato JSON |
 Una traza de código con diffs unificados, salida de terminal y la barra lateral del árbol de archivos
collapse_long_outputs con max_output_lines: 50 es el ajuste que decide si una traza es legible. Una sola ejecución de pytest puede imprimir varios cientos de líneas, y un anotador que tiene que desplazarse más allá de eso en cada paso deja de leer los pasos.
El formato de datos
El formato structured_turns conserva la estructura de llamadas a herramientas que necesita la visualización. Cada turno lleva un rol, el contenido de texto y una lista de llamadas a herramientas:
{
  "id": "session_001",
  "task_description": "Fix the authentication bypass in login.py",
  "model": "claude-sonnet-4-20250514",
  "structured_turns": [
    {
      "role": "assistant",
      "content": "I'll investigate the auth issue.",
      "tool_calls": [
        {
          "tool": "Read",
          "input": {"file_path": "src/auth/login.py"},
          "output": "def login(user, password):\n    if user.role == 'admin':\n        return True",
          "output_type": "code",
          "language": "python"
        },
        {
          "tool": "Bash",
          "input": {"command": "pytest tests/test_auth.py -v"},
          "output": "4 passed",
          "output_type": "terminal"
        }
      ]
    }
  ]
}
output_type admite code, diff, terminal o generic, y Potato lo infiere a partir de la herramienta y la extensión del archivo cuando lo omites. Indícalo explícitamente cuando la salida de una herramienta no es lo que sugiere su nombre.
Convertir las trazas que ya tienes
El conversor lee un formato y escribe el JSONL que carga Potato. Tres de sus formatos corresponden a agentes de coding:
# Claude Code, or any Anthropic Messages API transcript
python -m potato.trace_converter -i traces.json -f claude_code -o data/traces.jsonl

# Aider chat history with SEARCH/REPLACE blocks
python -m potato.trace_converter -i chat.md -f aider -o data/traces.jsonl

# SWE-Agent trajectories
python -m potato.trace_converter -i trajectory.json -f swe_agent_trajectory -o data/traces.jsonl

# Mixed directory, format detected per file
python -m potato.trace_converter -i traces.json --auto-detect -o data/traces.jsonl
El conversor claude_code lee las propias transcripciones de sesión de Claude Code además del formato sin procesar de la API de mensajes. Claude Code escribe un archivo JSONL por sesión en ~/.claude/projects/<slugified-working-directory>/<session-id>.jsonl, y el conversor convierte una sesión en una traza, no en una por línea:
python -m potato.trace_converter \
  -i ~/.claude/projects/-home-me-myrepo/3c853f0f-....jsonl \
  --auto-detect -o data/session.jsonl
Sigue la cadena de parentUuid y conserva solo el camino que sobrevive, de modo que los intentos rebobinados se descartan y se cuentan en lugar de anotarse como si hubieran ocurrido. Los mensajes de cadenas laterales van a sidechain_runs, fuera de los turnos principales. Los comandos con barra se descartan, porque son la CLI hablando consigo misma. La forma en disco pertenece a la CLI y no a una API publicada, así que trata el lector como un esfuerzo razonable que puede fallar entre actualizaciones. Ignora los tipos de registro que no conoce y lanza un error, en lugar de devolver una traza vacía, cuando un archivo deja de poder analizarse.
Anotación de recompensa de proceso
Un modelo de recompensa de proceso asigna el crédito paso a paso en lugar de puntuar solo el resultado final, y process_reward recoge las etiquetas con las que se entrena. Dos modos intercambian velocidad por detalle.
En el modo first_error, el predeterminado, el anotador hace clic en el primer paso en el que el agente se equivocó. Todos los pasos anteriores se marcan como correctos, y ese paso y todos los siguientes como incorrectos. Un solo clic etiqueta toda la trayectoria, y por eso es el modo que conviene cuando necesitas volumen.
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent makes a mistake."
    steps_key: structured_turns
    mode: first_error
En el modo per_step, cada paso se juzga por separado. Cuesta más tiempo de anotación y produce la señal que first_error no puede dar, porque una cascada supone que un error es irrecuperable y los agentes reales se recuperan. Activa allow_neutral junto con él y las etiquetas siguen la convención de PRM800K de +1, 0 y -1, en la que un paso realmente inocuo se registra como neutral en lugar de forzarse a un extremo:
  - annotation_type: process_reward
    name: step_rewards
    description: "Label each step as correct, neutral, or incorrect."
    steps_key: structured_turns
    step_text_key: content
    mode: per_step
    allow_neutral: true
Añade cualquiera de los dos esquemas a la configuración anterior. Con allow_neutral activado, un paso sin marcar se queda en null, así que la exportación distingue un juicio neutral deliberado de un paso al que el anotador nunca llegó. allow_neutral solo se aplica a per_step y se desactiva a la fuerza en first_error, que no tiene lugar para un juicio neutral.
Anotación de revisión de código
El esquema code_review lleva la revisión de pull requests a la salida del agente. Los anotadores hacen clic en una línea del diff para adjuntar un comentario categorizado, califican cada archivo y dan un veredicto:
  - annotation_type: code_review
    name: review
    description: "Review the agent's code changes."
    comment_categories: [bug, style, suggestion, security]
    verdict_options: [approve, request_changes, comment_only]
    file_rating_dimensions: [correctness, quality]
Añade este esquema a la configuración anterior. Cada dimensión de calificación de archivos se puntúa de 1 a 5. Los valores predeterminados son razonables para trabajo de revisión general, así que cámbialos cuando tu taxonomía sea el objeto del estudio, por ejemplo en una revisión de seguridad en la que bug y security tengan que ser categorías separadas con definiciones separadas en las instrucciones.
 Comentarios en línea sobre el diff, calificaciones por archivo y el veredicto global
El tutorial de revisión de código recorre un estudio de revisión completo, incluido cómo las categorías de comentarios condicionan lo que notan los anotadores. Ejecuta ese estudio con un puñado de trazas antes de ampliarlo, porque una lista de categorías que parecía completa en la configuración suele ganar una entrada más tras las primeras veinte revisiones.
Una configuración completa
Esta configuración muestra las trazas y recoge un veredicto a nivel de tarea, recompensas de proceso en modo de primer error y una revisión de código, con tres anotadores por traza para poder medir el acuerdo:
annotation_task_name: "Coding Agent Trace Evaluation"
task_description: "Judge whether the agent completed the task and review its changes."

data_files:
  - data/traces.jsonl

item_properties:
  id_key: id
  text_key: task_description

port: 8000
output_annotation_dir: annotation_output/coding-agent-eval/
export_annotation_format: jsonl

instance_display:
  layout:
    direction: vertical
    gap: 16px
  fields:
    - key: task_description
      type: text
      label: "Task"
    - key: structured_turns
      type: coding_trace
      label: "Agent Session"
      display_options:
        show_file_tree: true
        diff_view: unified
        collapse_long_outputs: true
        max_output_lines: 50
        terminal_theme: dark
        show_step_numbers: true

annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: success
        tooltip: "Completed correctly with no issues"
      - name: partial
        tooltip: "Completed with minor issues"
      - name: failure
        tooltip: "Not completed, or completed incorrectly"
    sequential_key_binding: true

  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent makes a mistake."
    steps_key: structured_turns
    mode: first_error

  - annotation_type: code_review
    name: review
    description: "Review the agent's code changes."
    comment_categories: [bug, style, suggestion, security]
    verdict_options: [approve, request_changes, comment_only]
    file_rating_dimensions: [correctness, quality]

  - annotation_type: text
    name: notes
    description: "Anything else worth recording about this trace"
    placeholder: "Optional"

num_annotators_per_item: 3

user_config:
  allow_all_users: false
  users:
    - annotator1
    - annotator2
Instala Potato, convierte tus trazas y arranca el servidor:
pip install potato-annotation
python -m potato.trace_converter -i ./my_traces.json --auto-detect -o data/traces.jsonl
potato start config.yaml -p 8000
El repositorio incluye una versión funcional de este proyecto en examples/agent-traces/coding-agent-evaluation/, que es la forma más rápida de ver la visualización antes de convertir nada propio. Arranca esa configuración, lee una traza como lo haría un anotador, y en pocos minutos sabrás si la granularidad de pasos que piensas etiquetar es la que muestra la visualización.
Exportar para el entrenamiento
Las anotaciones salen a través del exportador de evaluación de código, que escribe un archivo por tipo de salida:
python -m potato.export -c config.yaml -f coding_eval -o exports/ \
--option types=prm,preference,swebench,code_review| Tipo | Archivo | Para qué sirve |
|---|---|---|
prm | prm_training_data.jsonl | Entrenamiento de modelos de recompensa de proceso |
preference | preference_pairs.jsonl | DPO o RLHF, a partir de anotaciones por pares |
swebench | swebench_results.jsonl | Evaluación compatible con SWE-bench |
code_review | code_reviews.jsonl | Datos de revisión estructurados |
El tipo preference necesita anotaciones por pares a partir de las cuales construirse, así que un estudio que solo recoge recompensas de proceso produce los otros tres. Decide cuáles de los cuatro quieres antes de diseñar los esquemas, porque añadir una comparación por pares a posteriori significa anotar cada traza una segunda vez frente a otra.
Ver trabajar a un agente
Las trazas grabadas son una mitad del panorama. live_coding_agent ejecuta un agente dentro de la página de anotación, donde los anotadores lo ven trabajar, intervienen, revierten cambios y repiten la ejecución con otras instrucciones, con un backend de Ollama, Anthropic o Claude SDK en un directorio de trabajo aislado. La documentación del agente de coding en vivo cubre los backends y los modos de aislamiento.
Si tu equipo está evaluando agentes de coding y se topa con algo que esta configuración no cubre, abre un issue en el repositorio de GitHub. Un conversor nuevo es más o menos un archivo en potato/trace_converter/converters/, así que un formato que Potato aún no lee es una contribución y no un obstáculo.