تعليق مكافأة العملية
اجمع تسميات مكافأة لكل خطوة لنماذج مكافأة العملية بوضعَي الخطأ الأول وكل خطوة، مع تسميات محايدة اختيارية وتصنيف مسبق بنموذج لغوي كبير يتحقق منه البشر.
جديد في الإصدار v2.4.0
تقيّم نماذج مكافأة العملية خطوات الاستدلال التي يتخذها النموذج لا إجابته النهائية فقط، فيحتاج تدريب أحدها إلى تسمية لكل خطوة بدل تسمية واحدة لكل تتبع. ويجمع مخطط process_reward هذه التسميات.
يوازن وضعان بين السرعة والتفصيل. يطلب وضع الخطأ الأول نقرة واحدة: أول خطوة تسوء، مع اعتبار كل ما بعدها مشوباً. ويطلب وضع كل خطوة حكماً على كل خطوة، وهذا أكلف ويلتقط حالات يعجز عنها الخطأ الأول، مثل وكيل يتعافى من خطئه هو.
يعمل الوضعان مع عروض تتبع البرمجة وتتبع الوكيل وسلسلة الأفكار.
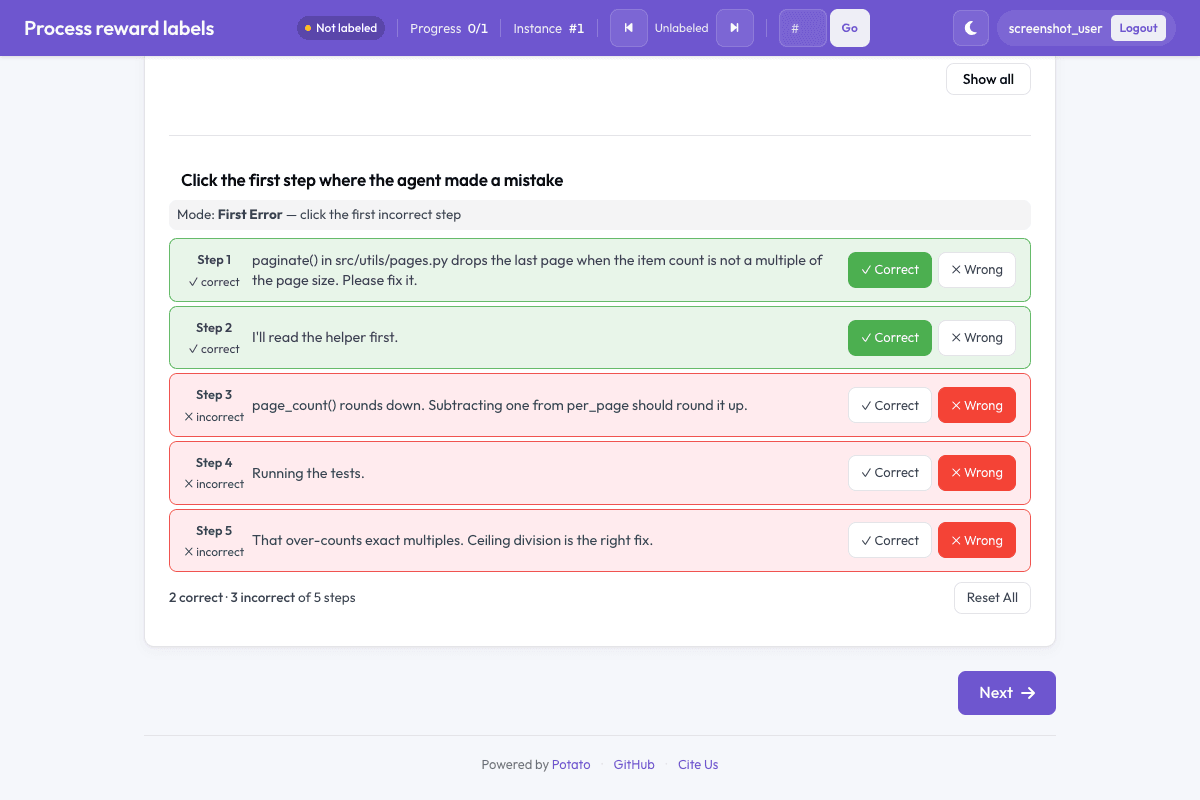 نقرة واحدة على أول خطوة خاطئة توسم التتبع كله
وضع الخطأ الأول
يقرأ المعلّق التتبع من الأعلى إلى الأسفل وينقر على أول خطوة خاطئة. تُسجَّل الخطوات التي قبلها صحيحة، وتُسجَّل الخطوة المنقور عليها وكل ما بعدها خاطئة. وهذا ينتج تسلسل التسميات الذي يتوقعه تدريب PRM الثنائي: 1 حتى الخطأ، ثم -1 من الخطأ فصاعداً.
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent made a mistake"
    mode: first_error
    steps_key: structured_turns
    step_text_key: content
يسمّي steps_key الحقل الذي يحمل قائمة الخطوات، ويسمّي step_text_key الحقل داخل كل خطوة الذي يُعرض.
سير عمل التعليق
- تبدأ الخطوات غير معلَّمة
- ينقر المعلّق على أول خطوة خاطئة
- يتحول كل ما قبلها إلى الأخضر
- تُعلَّم تلك الخطوة أول خطأ
- يُعلَّم كل ما بعدها مشوباً
تجعل الألوان التتالي مرئياً، وهذا هو غرض الوضع: حكم واحد يسم التتبع كله.
وضع كل خطوة
يُحكم على كل خطوة بمفردها. أضف allow_neutral للتسمية الثلاثية على نمط PRM800K، حيث يمكن ألا تكون الخطوة صحيحة ولا خاطئة:
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Rate each step correct, neutral, or incorrect"
    mode: per_step
    steps_key: structured_turns
    step_text_key: content
    allow_neutral: true
    inline_with_trace: true
ينطبق allow_neutral في وضع كل خطوة فقط. ليس في تتالي الخطأ الأول موضع لخطوة محايدة، فيُتجاهل الخيار هناك.
يربط inline_with_trace: true أدوات التقييم بكل خطوة في العرض بدل جمعها في لوحة منفصلة، وهذا ما تريده في تتبع طويل قد يفقد فيه المعلّق موضعه لولا ذلك.
إعادة تسمية التسميات
تقرأ الأزرار الثلاثة صحيح ومحايد وخاطئ افتراضياً. يعيد reward_labels تسميتها للمجالات التي لا تصلح فيها هذه الكلمات:
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Rate each reasoning step"
    mode: per_step
    steps_key: cot_steps
    allow_neutral: true
    reward_labels:
      correct: "Valid"
      neutral: "Neutral"
      incorrect: "Flawed"
تقطيع سلسلة الأفكار
تصل آثار الاستدلال عادةً سلسلةً نصية طويلة واحدة لا قائمة خطوات. يقسّمها cot_segmentation قبل بدء التعليق:
cot_segmentation:
  source_key: reasoning      # the item field holding the long CoT string
  strategy: auto             # blank_line | numbered | markers | sentence | llm | auto
  target_key: cot_steps      # where the step list is written
  min_step_chars: 30         # merge anything shorter into the previous step
  max_steps: 200

instance_display:
  fields:
    - key: cot_steps
      type: cot_trace
      label: "Reasoning"

annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Rate each reasoning step"
    mode: per_step
    steps_key: cot_steps
    allow_neutral: true
    inline_with_trace: true
يستحق min_step_chars أن يُضبط. فبدونه ينتج التقطيع بالجمل والأسطر الفارغة شظايا من سطر واحد لا يستطيع المعلّقون الحكم عليها منفردة، وتكون التسمية العائدة ضجيجاً.
التصنيف المسبق بنموذج لغوي كبير
يمكن لنموذج أن يقترح تسميات كل خطوة ويؤكدها المعلّق أو يتجاوزها واحدة واحدة، وهذا أسرع من التسمية من الصفر في التتبعات الطويلة:
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Verify or correct each suggested reward"
    mode: per_step
    steps_key: cot_steps
    allow_neutral: true
    inline_with_trace: true
    ai_prelabel: true
    require_verification: true

ai_support:
  enabled: true
  endpoint_type: openai
  ai_config:
    model: gpt-4o-mini
    max_tokens: 768
    temperature: 0.1
    include:
      all: true
يضيف ai_prelabel الزر الذي يطلب الاقتراحات. ويرفض require_verification قبول التعليق حتى تُؤكَّد كل الاقتراحات أو تُغيَّر، وهذا ما يُبقي المخرج تسمية بشرية لا تسمية نموذج.
امنح max_tokens هامشاً حقيقياً. فسلسلة أفكار طويلة مع حكم لكل خطوة رد كبير، والرد المقطوع يظهر على أنه لا اقتراحات إطلاقاً.
ما يحتويه المخرج
يُخزَّن التعليق تحت اسم المخطط قائمةَ steps مع mode الذي جُمع به:
{
  "step_rewards": {
    "mode": "per_step",
    "steps": [
      {"reward": 1, "source": "human", "verified": true},
      {"reward": -1, "source": "human", "verified": true},
      {"reward": 0, "source": "ai", "verified": true, "ai_reward": 0},
      {"reward": null, "source": null, "verified": false}
    ]
  }
}
reward هي 1 للصحيح و-1 للخاطئ و0 للمحايد. والخطوة المتروكة null لا 0، فتبقى الخطوة التي لم يحكم عليها أحد متميزة عن التي حُكم عليها بأنها لا صحيحة ولا خاطئة. وهذا التمييز مهم حين تصبح التسميات بيانات تدريب، لأن معاملة المتروكات محايدةً تخترع إشارة بصمت.
يسجّل source هل جاءت القيمة من شخص أم من نموذج، ويسجّل verified هل أكدها شخص. وحين يكون ai_prelabel مفعّلاً، يحتفظ ai_reward باقتراح النموذج الأصلي حتى بعد أن يتجاوزه المعلّق، وهذا ما يتيح لك الإبلاغ عن عدد مرات إصابة النموذج دون تمريرة ثانية.
التصدير
لا يملك Potato صيغة تصدير PRM أو DPO مدمجة. صدّر التعليقات وشكّلها بنفسك:
python -m potato.export -c config.yaml -f jsonl -o ./export/تحويل تعليقات الخطأ الأول إلى تسميات تدريب على مستوى الخطوة قصير، وكتابته بنفسك هو ما يتيح لك أن تقرر كيف تُعامَل الخطوات المتروكة:
import json
from pathlib import Path

SCHEME = "step_rewards"

examples = []
for f in Path("export/").rglob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            rec = json.loads(line)
            payload = (rec.get("labels", rec) or {}).get(SCHEME)
            if not payload:
                continue

            steps = payload.get("steps", [])
            # Drop traces with unjudged steps rather than guessing at them.
            if any(s.get("reward") is None for s in steps):
                continue

            item = items_by_id[rec["instance_id"]]      # your own data file
            examples.append({
                "trace_id": rec["instance_id"],
                "steps": [
                    {"content": src, "label": s["reward"]}
                    for src, s in zip(item["structured_turns"], steps)
                ],
            })

with open("prm_training_data.jsonl", "w") as out:
    for ex in examples:
        out.write(json.dumps(ex) + "\n")

print(f"Wrote {len(examples)} traces")
التحليل
import json
from collections import Counter
from pathlib import Path

SCHEME = "step_rewards"

traces = []
for f in Path("export/").rglob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            rec = json.loads(line)
            payload = (rec.get("labels", rec) or {}).get(SCHEME)
            if payload:
                traces.append(payload)

print(f"Traces annotated: {len(traces)}")

all_correct = sum(
    1 for t in traces
    if all(s.get("reward") == 1 for s in t.get("steps", []))
)
print(f"Traces with no errors: {all_correct} ({all_correct / len(traces):.1%})")

# Where the first error lands
first_error_positions = []
for t in traces:
    for i, s in enumerate(t.get("steps", [])):
        if s.get("reward") == -1:
            first_error_positions.append(i)
            break

if first_error_positions:
    avg = sum(first_error_positions) / len(first_error_positions)
    print(f"Average first-error position: step {avg:.1f}")
    print("By position:", Counter(first_error_positions).most_common(10))
حين يكون ai_prelabel مفعّلاً، تخبرك السجلات نفسها بعدد مرات بقاء اقتراح النموذج بعد المراجعة:
kept = changed = 0
for t in traces:
    for s in t.get("steps", []):
        if s.get("ai_reward") is None:
            continue
        if s.get("reward") == s.get("ai_reward"):
            kept += 1
        else:
            changed += 1

total = kept + changed
if total:
    print(f"AI suggestions kept: {kept}/{total} ({kept / total:.1%})")
معدل القبول هذا هو الرقم الذي ينبغي مراقبته قبل الوثوق بالتصنيف المسبق في مجال جديد. فالمعدل القريب من 100% يعني عادةً أن المعلّقين يؤكدون ولا يفحصون، لا أن النموذج مصيب.
السياق البحثي
يوجد تعليق مكافأة العملية لدعم العمل على نماذج المكافأة للأنظمة متعددة الخطوات، حيث الملاحظة التي تحفّز النهج كله أن إجابة نهائية صحيحة قد تقوم على استدلال معيب. وتفصل التسميات على مستوى الخطوة بين الأمرين، وتتوافق وضعا الخطأ الأول وكل خطوة هنا مع صيغ التسميات التي يستخدمها ذلك الخط من الأعمال.
ولتصميم التصنيف وأسئلة الاتفاق المصاحبة له، راجع توطين الأخطاء لكل خطوة، الذي يغطي التتبعات نفسها من جهة تصنيف الأخطاء.
انظر أيضاً
- التعليق التوضيحي لوكلاء البرمجة - عرض تتبعات وكلاء البرمجة والتعليق عليها
- التعليق التوضيحي للوكلاء - التعليق العام على تتبعات الوكلاء
- صيغ التصدير - الصيغ التي يصدّرها Potato فعلاً
- مراقبة الجودة - الاتفاق والتحكيم
- الضبط الدقيق لنموذج لغوي كبير على تعليقاتك التوضيحية - تدريب نموذج مكافأة عملية على تقييمات الخطوات بالمُدرِّب
prm-reward
لتفاصيل التنفيذ، راجع الوثائق المصدرية.