Potato 2.6.2: полный открытый набор для оценки агентов
Линейка 2.6.x превращает Potato в полноценную бесплатную платформу оценки агентов: приём трасс из OpenTelemetry, LangGraph, CrewAI и AutoGen, разметка мультиагентных команд на кликабельном графе взаимодействий, схемы для мультимодальных агентов (GUI, голос, видео), а также арена моделей, проверки в CI и курирование.
Potato 2.6 принёс первую волну оценки агентов: калибровку LLM-как-судьи, редактирование траекторий под обучающие данные и трёхпанельное отображение eval_trace. Точечные релизы линейки 2.6.x с тех пор закрыли остальное. По состоянию на 2.6.2 Potato — полноценная платформа оценки агентов: вы можете снимать трассы со своих агентов, размечать одиночных агентов, мультиагентные команды и мультимодальных агентов, судить их LLM, которым можно доверять, ранжировать модели на арене и ставить проверки на релизы в CI. Всё это настраивается в YAML и остаётся на вашем сервере.
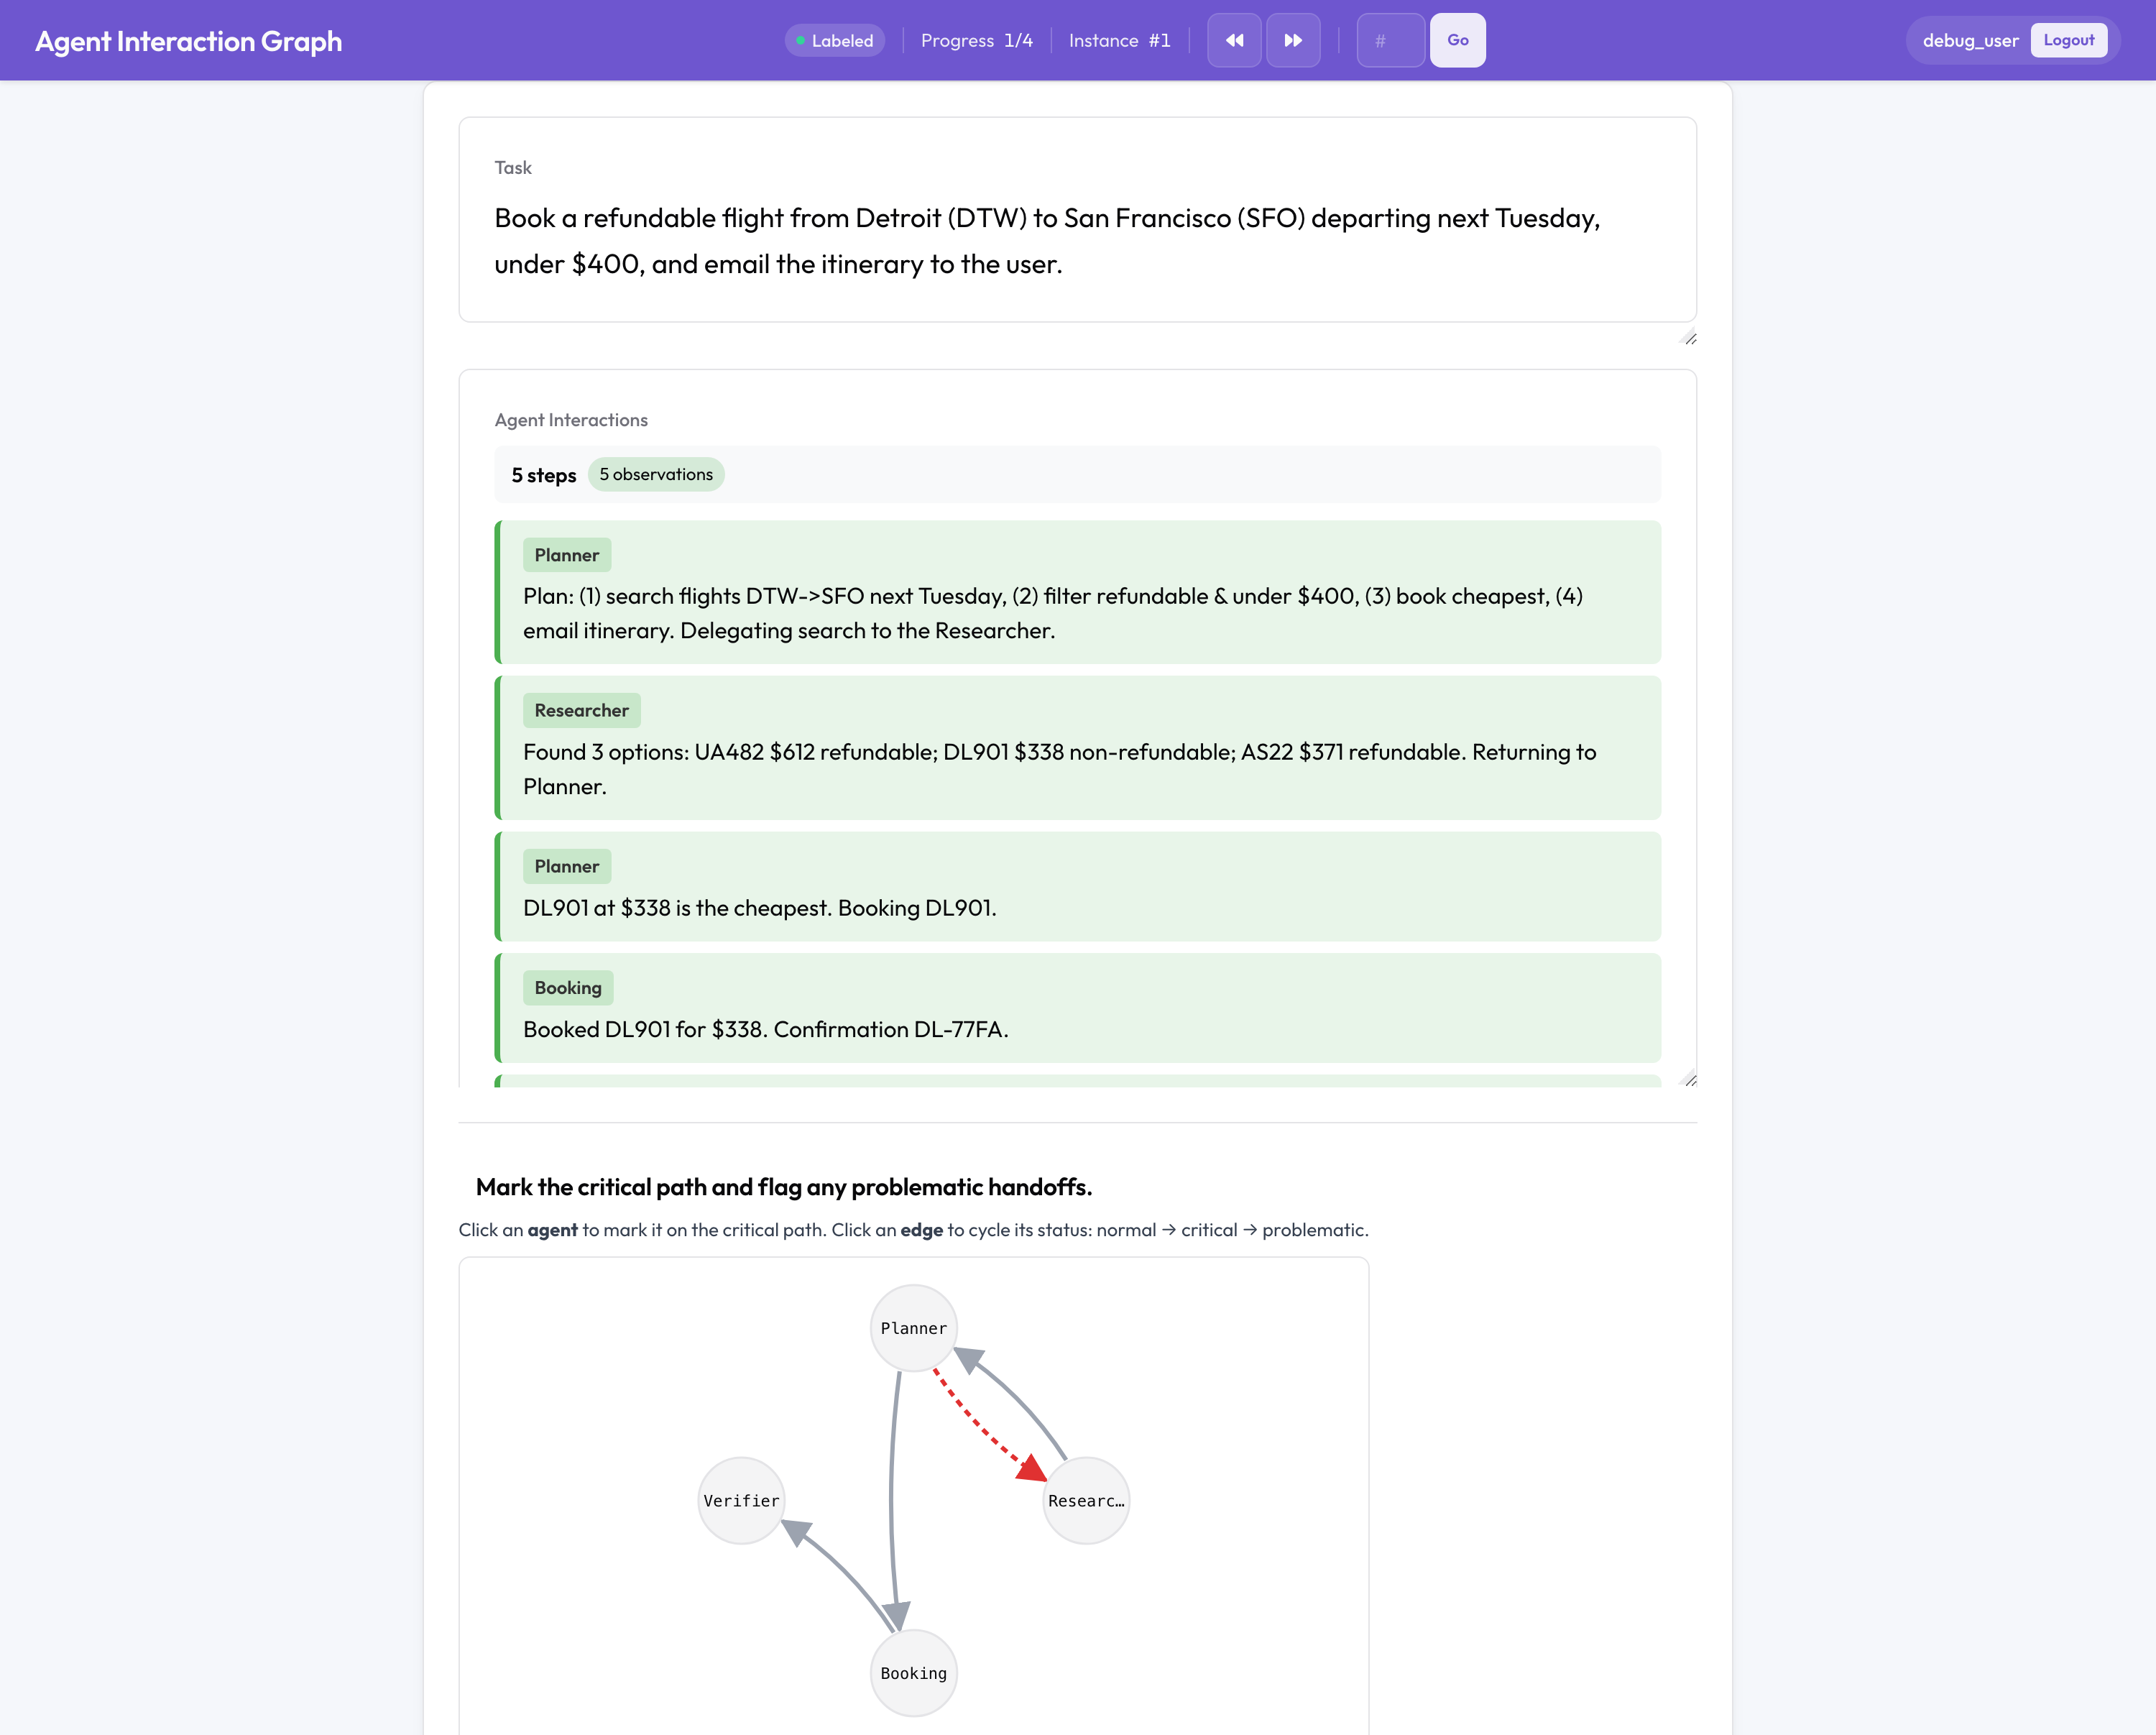 Potato multi-agent evaluation
За большинство этих возможностей сейчас платят хостинговым платформам. Potato даёт их бесплатно и с размещением у вас. Вот что вышло за линейку 2.6.x.
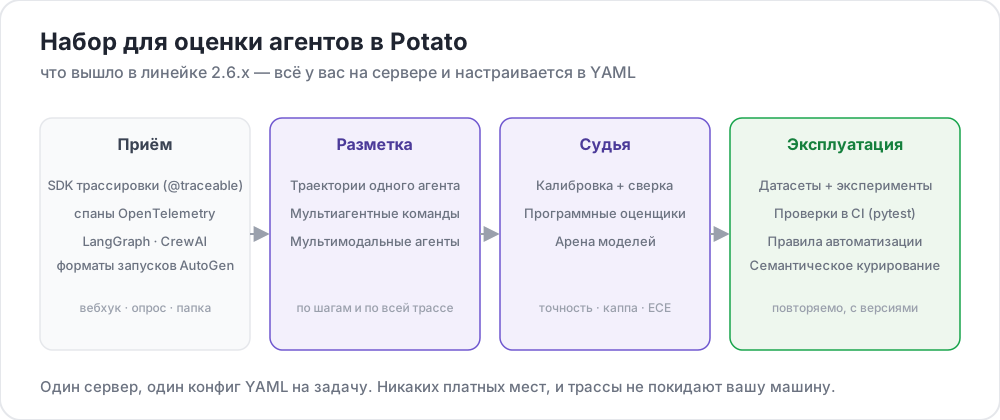 The 2.6.x agent-evaluation suite, end to end
Как завести трассы: SDK захвата и открытые стандарты
Оценка начинается с настоящих запусков. Новый SDK potato_trace инструментирует любого агента: пометьте функцию декоратором @traceable (синхронную или асинхронную), и вложенные вызовы будут захвачены и отправлены на эндпоинт приёма Potato, с необязательным экспортом в OpenTelemetry. Potato также принимает спаны OpenTelemetry / OpenInference и форматы запусков LangGraph, CrewAI и AutoGen, так что трассы из уже используемого вами фреймворка попадают в очередь разметки без склеивающего кода. Новые трассы могут приходить через вебхук, опрос или отслеживаемый каталог и назначаться разметчикам по мере поступления.
Справочник: SDK трассировки, правила автоматизации.
Увидеть всю команду: оценка мультиагентных систем
Мультиагентный запуск ломается иначе, чем одиночный агент: между агентами, на передаче управления, в том, как команда была устроена. Поэтому Potato размечает структуру команды, а не плоскую стенограмму:
- Кликабельный граф взаимодействий агентов и передач управления, где вы отмечаете критический путь и помечаете проблемные рёбра.
- Атрибуция сбоя: выберите ответственного агента, решающий шаг и причину — тройку (агент, шаг, причина) из работы Who&When по атрибуции.
- Разбор передач управления: каждая передача управления становится карточкой, где можно пометить рассогласование между агентами и оценить качество.
- Оценочные карточки по агенту и по команде: соответствие роли, вклад и координация у каждого агента плюс общие командные измерения и вехи.
- Таймлайн конкуренции за инструменты, показывающий взаимные блокировки и гонки, когда агенты одновременно трогают один ресурс.
- Разметка эмерджентного поведения для сговора, группового мышления и каскадных ошибок, растянутых на нескольких агентов и несколько ходов.
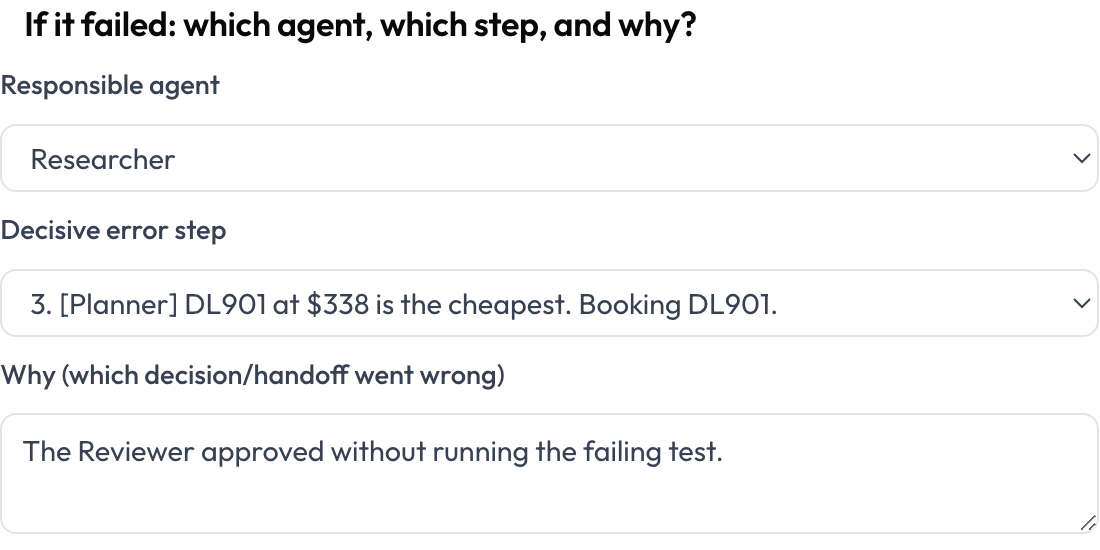 Failure attribution: which agent, which step, and why
Полный набор с YAML к каждому пункту — в оценке мультиагентных команд, а подробный разбор Отладка сбоев мультиагентных систем проходит по каждой поверхности от начала до конца. Руководство Как оценивать мультиагентные системы объясняет, что когда применять.
За пределами текста: оценка мультимодальных агентов
Агенты теперь управляют интерфейсами, смотрят видео и ведут устные разговоры, и каждому нужна поверхность разбора, которую текстовый виджет дать не может:
- Траектории работы с GUI и компьютером: скриншот и действие на каждом шаге, вердикт по действию и маркер привязки клика, показывающий, попал ли клик по нужному элементу.
- Полнодуплексные голосовые таймлайны: двухдорожечный таймлайн пользователя и агента с детекцией перебиваний и оценкой очерёдности реплик.
- Временная привязка в видео: отмечайте эталонные интервалы событий с живым IoU относительно интервала, предсказанного моделью.
- Разметка ошибок в расшифровке речи, чередующиеся мультимодальные рассуждения с флагами визуальных галлюцинаций и структура табличной сетки в документах.
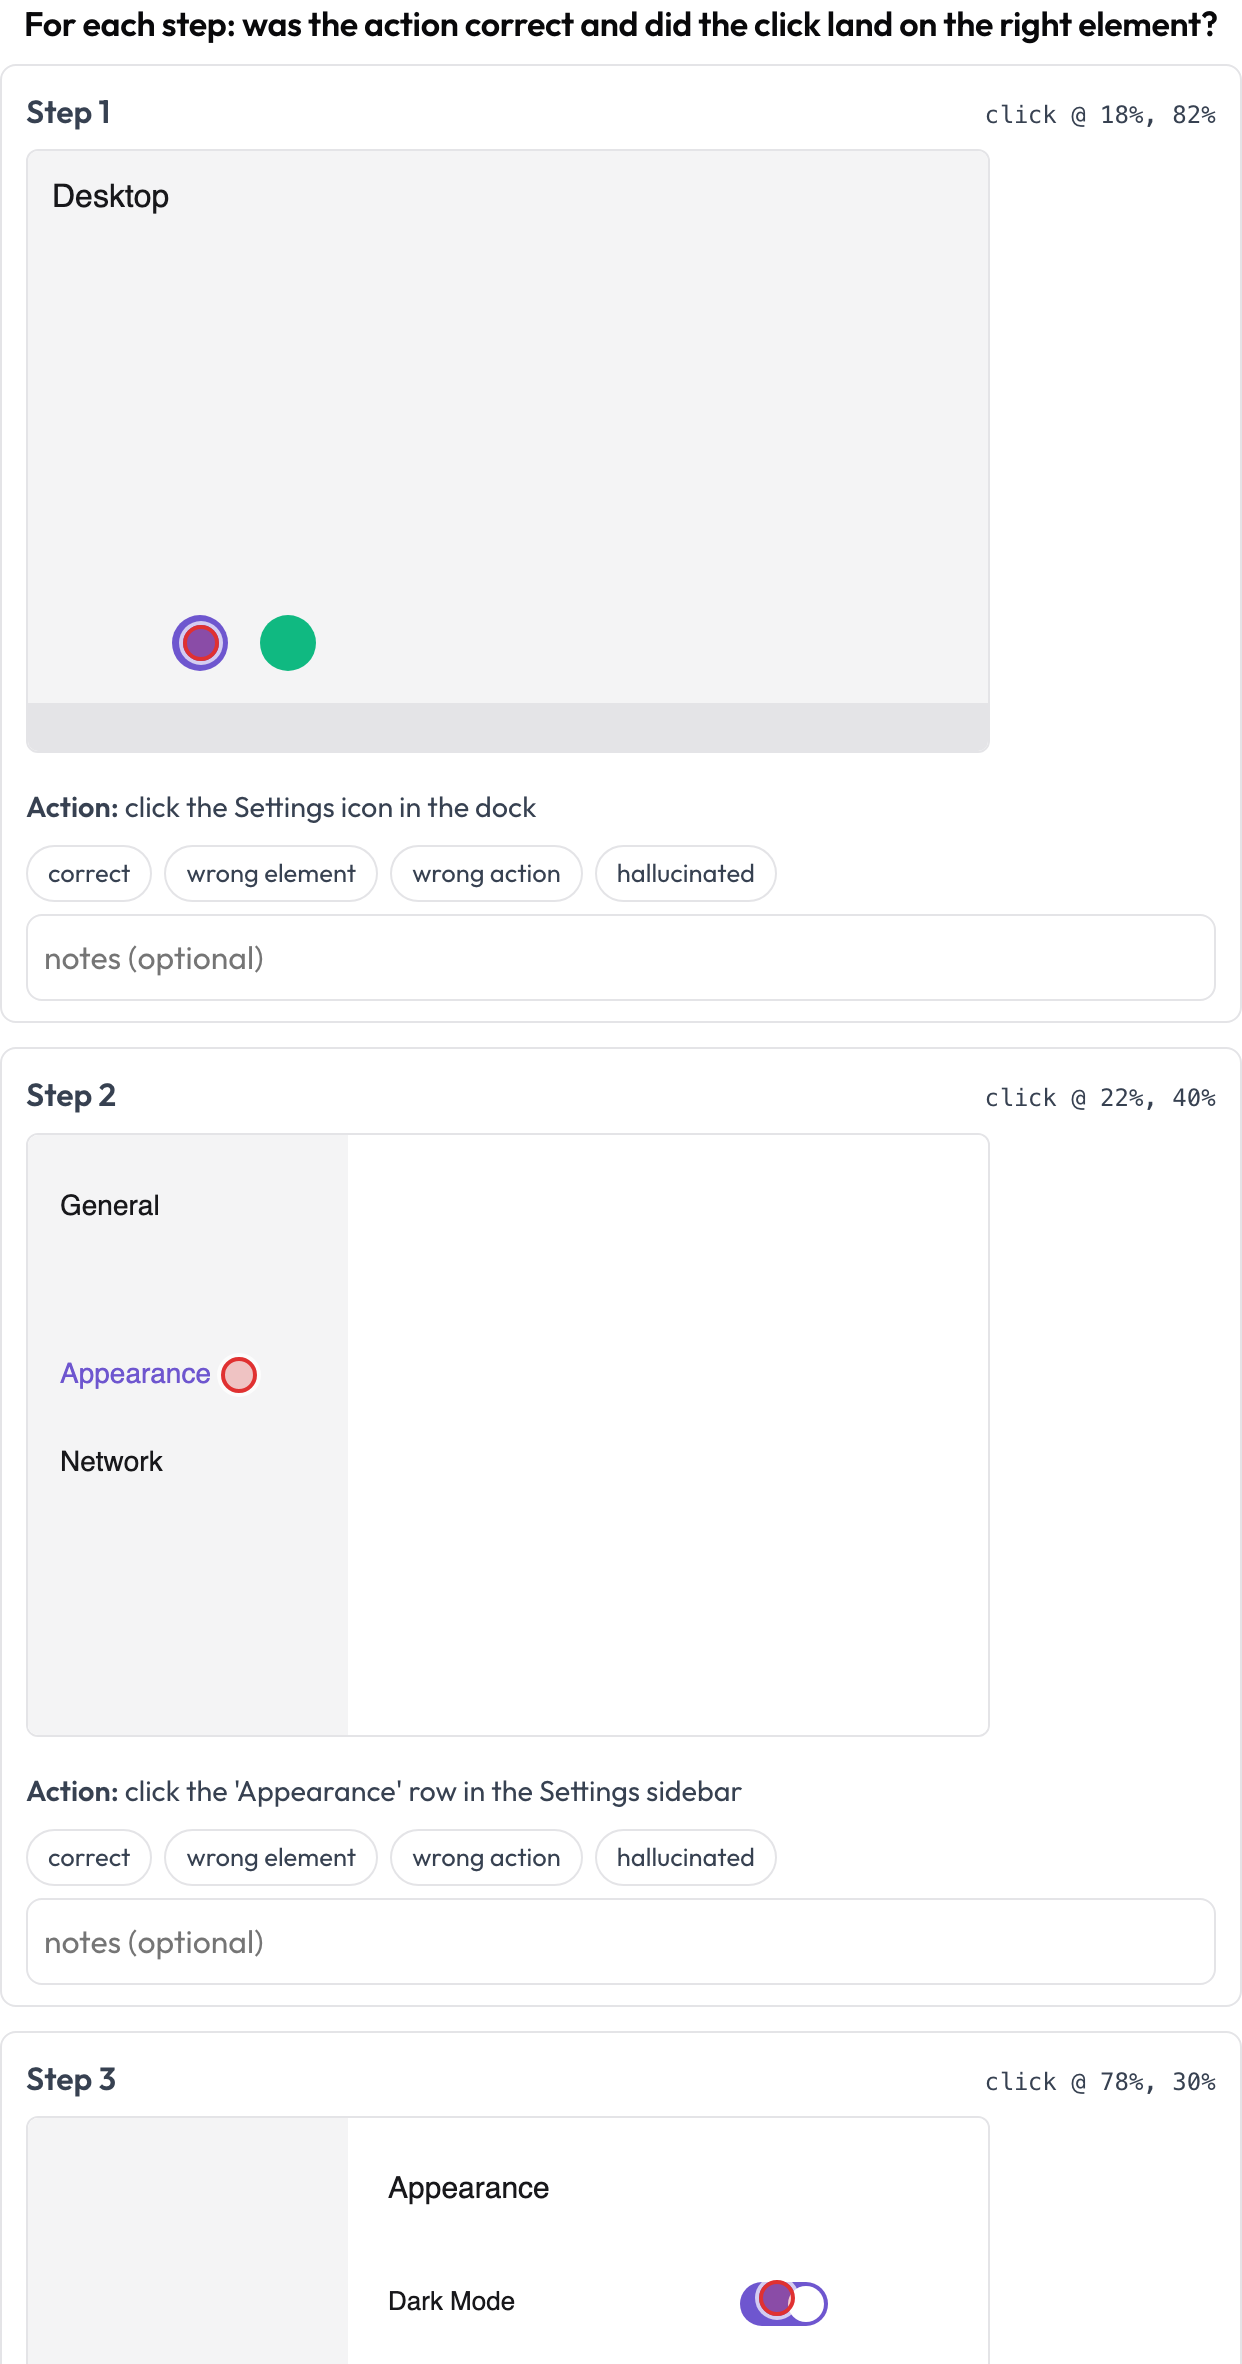 Computer-use review: action correctness plus click grounding
Через это проводят два подробных разбора: Оценка агентов, управляющих компьютером — про GUI и агентов уровня ОС, и Оценка голосовых и видеоагентов — про речевых, видео- и документных агентов. Справочник — оценка мультимодальных агентов, руководство — Оценка агентов, управляющих компьютером, и мультимодальных агентов.
Калибровка судьи и арена моделей
Оценивать выводы с помощью LLM — обычное дело; работа в 2.6.x про то, насколько далеко этому можно доверять. Калибровка судьи проводит слепой человеческий проход против меток модели и показывает точность, каппу и ожидаемую ошибку калибровки. Сверка судьи настраивает одного судью по вашим эталонным меткам. А программные оценщики оценивают траектории и текст автоматически (совпадение траектории, корректность работы с инструментами, LLM-как-судья без эталона и эвристики) без запущенного сервера.
Для прямого сопоставления арена моделей отправляет один промпт нескольким моделям, собирает предпочтения и строит таблицу лидеров по доле побед среди OpenAI, Anthropic, Gemini, Ollama и vLLM.
Относиться к оценке как к разработке
Операционные части делают оценку повторяемой:
- Датасеты и эксперименты: версионируемые наборы для оценки, разбиения и сравнение экспериментов бок о бок с дельтами регрессий.
- Оценка в CI: плагин для pytest, роняющий сборку, когда изменение промпта или модели ухудшает качество агента сверх порога.
- Правила автоматизации: направляйте входящие продакшен-трассы в датасеты, к оценщикам или в очередь разметки по правилу.
- Семантическое курирование: индекс эмбеддингов для запроса «найди трассы, похожие на этот сбой», и сохраняемые динамические срезы.
Как получить
pip install --upgrade potato-annotationК каждой новой поверхности идёт запускаемый пример в examples/agent-traces/, включая interaction-graph/, failure-attribution/, gui-trajectory/ и temporal-grounding/. Направьте Potato на любой из них, чтобы увидеть схему в работе:
python potato/flask_server.py start examples/agent-traces/interaction-graph/config.yaml -p 8000Если вы выбираете между инструментами, сравнение в Potato против LangSmith и Langfuse и руководство Сравнение открытых инструментов разметки показывают, кому что подходит. Вопросы и пожелания по форматам трасс, которые нам стоит поддержать, приветствуются в репозитории на GitHub.