Potato против LangSmith и Langfuse для оценки агентов: практическое сравнение
Сравнение Potato с LangSmith, Langfuse, Labelbox и Scale AI для оценки агентов: отрисовка трасс, разметка по шагам и мультиагентная, разбор мультимодальных агентов, кодовые агенты, наблюдение вживую, цены и размещение у себя.
Три инструмента, три отправные точки
Potato, LangSmith и Langfuse все так или иначе занимаются оценкой агентов, но подходят к ней с разных сторон:
- Potato идёт от разметки. Он создавался для сбора структурных человеческих суждений о выводах ИИ, а потом был расширен под трассы агентов, диффы кода и наблюдение вживую. Его сила — в глубине и настраиваемости схем разметки.
- LangSmith идёт от наблюдаемости. Он создавался, чтобы инструментировать, трассировать и отлаживать приложения на LangChain в продакшене. Возможности разметки появились позже, для сценариев оценки внутри экосистемы LangChain.
- Langfuse — наблюдаемость с открытым кодом. Он покрывает трассировку, управление промптами и оценку для любого приложения на LLM. Разметка в нём работает, но вторична по отношению к мониторингу.
Ни один из них не лучше остальных вообще. Выбор зависит от того, что вам нужно в первую очередь — разметка, наблюдаемость или и то и другое, — и от того, привязаны ли вы к экосистеме конкретного фреймворка.
Сравнение возможностей
В таблице ниже сравниваются возможности, важные для оценки ИИ-агентов. Мы добавили сюда же Label Studio, Argilla и Scale AI, потому что команды часто взвешивают и их.
| Возможность | Potato | LangSmith | Langfuse | Label Studio | Argilla | Scale AI |
|---|---|---|---|---|---|---|
| Основное назначение | Разметка | Наблюдаемость | Наблюдаемость | Разметка | Разметка | Разметка |
| Поддержка форматов трасс | 15 форматов | Родной LangChain | SDK Langfuse | Нет | Нет | Свой формат |
| Разметка по шагам | Полная (trajectory_eval) | Оценка и комментарий на спан | Структурные оценки на уровне спана | Да (импорт трасс) | Только реплики чата | Свой формат |
| Наблюдение за агентом в реальном времени | Да | Нет | Нет | Нет | Нет | Нет |
| Пауза, продолжение и перехват управления | Да | Нет | Нет | Нет | Нет | Нет |
| Отрисовка диффов кода | Да (единый дифф, подсветка синтаксиса) | Нет | Нет | Нет | Нет | Нет |
| Отрисовка вывода терминала | Да (с поддержкой цветов ANSI) | Нет | Частично | Нет | Нет | Нет |
| Сбор данных для PRM | Да (пошаговые метки корректности) | Нет | Нет | Нет | Нет | Нет |
| Ревью кода с комментариями в строках | Да (на уровне строк, с категориями) | Нет | Нет | Нет | Нет | Нет |
| Попарное сравнение | 3 режима (бок о бок, последовательно, вслепую) | Ограниченно (1 режим) | Нет | Нет | Да (1 режим) | Да (1 режим) |
| Многокритериальная рубрика | Да (настраиваемые измерения и шкалы) | Нет | Нет | Нет | Частично | Да |
| Таксономия ошибок | Иерархическая, настраиваемая | Нет | Настройка категориальных оценок | Нет | Нет | Свой формат |
| Оценка серьёзности | Да (со взвешиванием, текущий счёт) | Нет | Только числовые оценки | Нет | Нет | Свой формат |
| Мультиагентный граф взаимодействий (редактируемый разметчиком) | Да | Нет | Только визуализация ¹ | Нет | Нет | Нет |
| Атрибуция сбоев между агентами | Да | Нет | Только обходным путём | Нет | Нет | Только как услуга |
| Разбор передач управления (полноценный объект) | Да | Нет | Нет | Нет | Нет | Нет |
| Оценочные карточки по агенту и по команде | Да | Нет | Нет | Нет | Нет | Нет |
| Траектории работы с компьютером (привязка кликов) | Да | Нет | Нет | Универсальные инструменты для изображений | Нет | Как услуга по сбору датасета ² |
| Полнодуплексный голос (оценка перебиваний) | Да | Нет | Только воспроизведение | Нет | Нет | Только по репликам ³ |
| Временная привязка в видео (живой IoU) | Да | Нет | Нет | IoU только между разметчиками | Нет | Нет |
| Размещение у себя | Да (полностью) | Только тариф Enterprise | Да (открытый код) | Да (открытый код) | Да (открытый код) | VPC (enterprise) |
| Бесплатно | Да (полностью открытый код) | Нет (бесплатный тариф ограничен) | Частично (открытое ядро) | Частично (открытое ядро) | Да (открытый код) | Нет |
| Привязка к фреймворку | Нет | Экосистема LangChain | Нет | Нет | Нет | Нет |
¹ «Agent Graphs» у Langfuse (бета) рисует запуск мультиагентной системы графом, но как отладочный вид только для чтения — задокументированного способа отметить на нём критический путь или пометить рёбра у разметчика нет. ² Scale AI размечает траектории работы с GUI и компьютером как управляемый проект по сбору данных (например, работа над CUA-Suite в CVAT), а не как самостоятельно настраиваемую возможность. ³ «Voice Showdown» у Scale работает по репликам; полнодуплексная оценка перебиваний и наложений заявлена как запланированная, но пока недоступна (по состоянию на 2026-03-20).
Сравнение проведено 2026-06-24 по LangSmith (docs.langchain.com), Langfuse (открытое ядро под MIT, непрерывные релизы), Label Studio 1.23.0, Argilla 2.8.0 и страницам продуктов Scale AI. Эти инструменты выпускают версии быстро — если что-то здесь устарело, поправки приветствуются в репозитории на GitHub.
Среди этих инструментов Potato — единственный, кто отрисовывает трассы кодовых агентов с нормальным форматированием диффа:
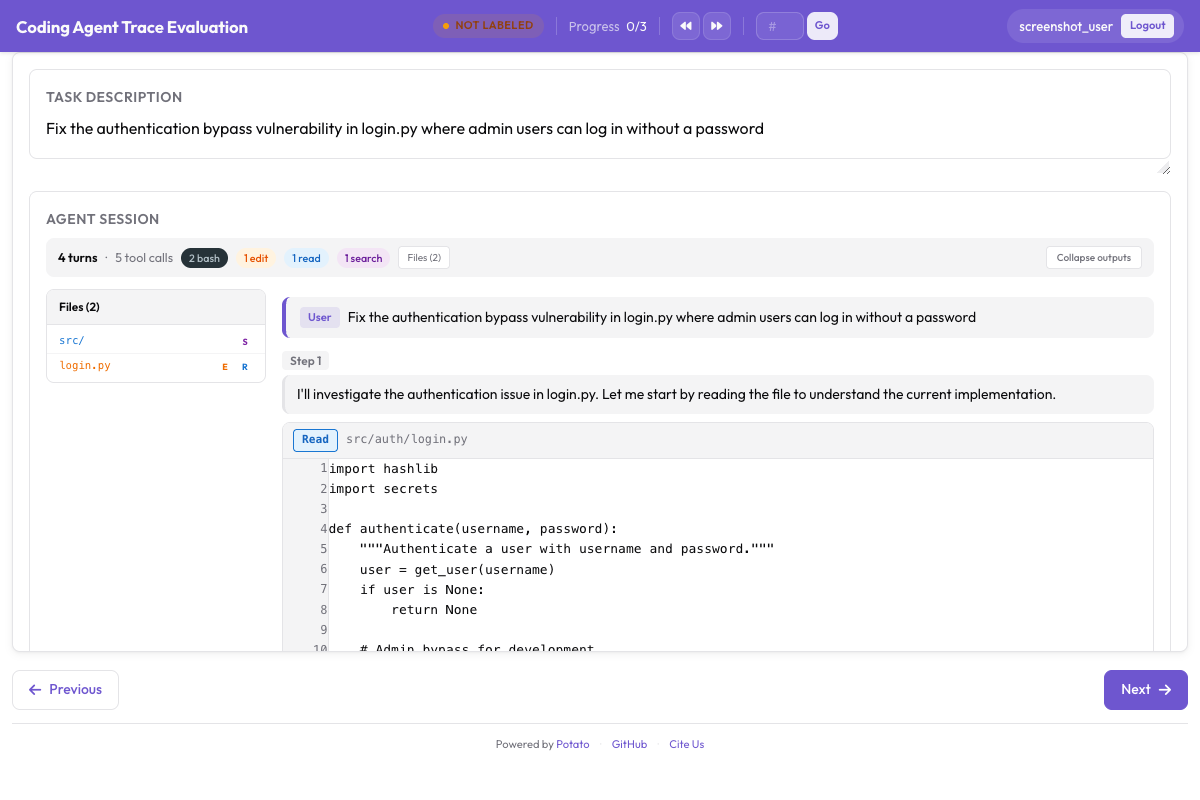 Potato's CodingTraceDisplay with unified diff rendering, syntax highlighting, and file tree
Trace Format Support in Detail
Одно из самых заметных на практике различий — сколько форматов трасс агентов каждый инструмент понимает изначально.
Potato включает конвертеры для 15 форматов:
# See all available converters
python -m potato.trace_converter --list-formats

# Available formats:
#   react                 - ReAct-style (Thought/Action/Observation)
#   openai                - OpenAI Chat Completions and Assistants API
#   anthropic             - Anthropic Messages API with tool_use
#   langchain             - LangChain / LangSmith run trace exports
#   langfuse              - Langfuse observation and trace exports
#   multi_agent           - CrewAI, AutoGen, and LangGraph multi-agent logs
#   swebench              - SWE-bench benchmark traces
#   swe_agent_trajectory  - SWE-Agent trajectory files
#   claude_code           - Claude Code and coding-agent session logs
#   aider                 - Aider chat histories with edit blocks
#   webarena              - WebArena / VisualWebArena episode traces
#   web_agent             - Mind2Web, Computer Use, and raw browser recordings
#   mcp                   - Model Context Protocol interaction logs
#   otel                  - OpenTelemetry / OTLP trace exports
#   atif                  - Agent Trace Interchange Format
Отдельного конвертера langsmith нет: выгрузки запусков LangSmith идут через langchain. AutoGen и CrewAI идут через multi_agent. Если вашего фреймворка в списке нет, --auto-detect попробует подобрать конвертер по сигнатурам полей, а свой можно написать, унаследовавшись от BaseTraceConverter.
LangSmith изначально работает с трассами LangChain. Если ваш агент собран на LangChain или LangGraph, трассы поступают автоматически. Если нет, придётся вручную инструментировать код через SDK LangSmith или конвертировать трассы в его формат.
Langfuse изначально работает с трассами, снятыми через SDK Langfuse. Он поддерживает Python и JavaScript и имеет интеграции с LangChain, LlamaIndex и OpenAI. Как и LangSmith, он требует инструментирования на уровне кода, а не конвертации трасс постфактум.
Импорт трасс LangSmith или Langfuse в Potato
Если трассы у вас уже есть в LangSmith или Langfuse и вы хотите воспользоваться разметкой Potato, конвертеры это закрывают:
# Export from LangSmith and convert (LangSmith runs use the langchain converter)
python -m potato.trace_converter \
  --input langsmith_export.jsonl \
  --output data/traces.jsonl \
  --input-format langchain

# Export from Langfuse and convert
python -m potato.trace_converter \
  --input langfuse_traces.json \
  --output data/traces.jsonl \
  --input-format langfuse
То есть LangSmith или Langfuse можно оставить для продакшен-мониторинга, а трассы переносить в Potato, когда нужна подробная человеческая оценка.
Разметка по шагам
Именно в разметке по шагам схемы различаются сильнее всего.
Potato даёт схему trajectory_eval со следующим:
- Пошаговые метки корректности (верно/неверно)
- Выбор из иерархической таксономии ошибок
- Уровни серьёзности с настраиваемыми весами
- Текущий счёт, обновляющийся на каждом шаге
- Обоснование свободным текстом на каждом шаге
- Всё это настраивается через YAML
# Potato: rich per-step annotation
annotation_schemes:
  - annotation_type: "trajectory_eval"
LangSmith позволяет прикрепить числовую оценку или категориальную метку к отдельным запускам внутри трассы. Это годится для базового отслеживания качества, но не поддерживает таксономии ошибок, взвешивание серьёзности и текущий счёт. Встроенного интерфейса пошагового разбора нет; запуски оцениваются из подробного вида трассы.
Langfuse поддерживает оценивание на уровне трассы и на уровне наблюдения (спана), а его категориальные конфигурации оценок позволяют задать фиксированный набор меток — по сути рабочую таксономию ошибок — и повесить несколько именованных оценок на один спан. Чего он не даёт как полноценную схему, так это иерархической таксономии и текущего счёта со взвешиванием по серьёзности, накапливающегося по шагам; это приходится собирать самому из плоских конфигураций оценок.
Разрыв уже не тот, что раньше: и Langfuse, и Label Studio (который теперь импортирует трассы LangGraph/CrewAI/AutoGen для пошагового разбора) умеют структурное пошаговое оценивание. Где Potato по-прежнему сделан специально — это сочетание: иерархическая таксономия ошибок плюс веса серьёзности плюс текущий счёт в одной схеме trajectory_eval, а именно это и нужно, чтобы собирать обучающие данные для PRM или находить, где агент впервые свернул не туда.
Поддержка кодовых агентов
Оценивать кодовых агентов (Claude Code, Aider, SWE-Agent, Devin, OpenHands) — значит отрисовывать диффы кода и вывод терминала так, чтобы разбор шёл быстро. Здесь Potato уходит вперёд.
Potato отрисовывает:
- Единые диффы с красно-зелёной подсветкой и подсветкой синтаксиса
- Вывод терминала с поддержкой цветовых кодов ANSI
- Комментарии прямо в диффе, привязанные к конкретным строкам
- Оценки качества на уровне файлов
- Вердикты «принять / вернуть на доработку» в стиле пул-реквеста
LangSmith показывает входы и выходы вызовов инструментов отформатированным JSON. Диффы кода выглядят как сырые строки внутри выводов инструментов. Ни отрисовки диффа, ни подсветки синтаксиса, ни комментариев в строках нет.
Langfuse так же показывает данные трассы структурным JSON. Код выглядит обычным текстом. Специальной отрисовки для диффов и вывода терминала нет.
Для кодовых агентов это меняет рабочий день ревьюера. Разобрать дифф на 50 строк в едином виде с подсветкой синтаксиса и комментариями в строках занимает долю того времени, которое уходит на чтение того же диффа в виде строки JSON.
Трассы веб-агентов включают скриншоты с SVG-оверлеями и навигацию по ленте кадров:
 Web agent trace viewer showing screenshots with SVG action overlays and filmstrip navigation
Наблюдение за живым агентом
Potato умеет наблюдать за работающим агентом в реальном времени, чего в сценариях разметки не делают ни LangSmith, ни Langfuse.
В режиме наблюдения вживую разметчик может смотреть, как агент работает шаг за шагом, ставить его на паузу, чтобы разобраться в текущем состоянии, продолжать после этого и перехватывать сессию, чтобы выправить курс или доделать задачу вручную.
Это помогает в нескольких ситуациях: остановить агента до того, как он сделает что-то разрушительное (безопасность), записать человеческие исправления как демонстрационные данные (обучение) и посмотреть, как агент реагирует на вмешательство посреди работы (интерактивная оценка).
# Enable live observation in Potato config
live_observation:
  enabled: true
  agent_endpoint: "http://localhost:5000/agent"
  allow_pause: true
  allow_takeover: true
  auto_pause_on:
    - action_type: "delete"
    - action_type: "execute"
    - confidence_below: 0.3
LangSmith и Langfuse рассчитаны на разбор завершённых трасс постфактум, а не на взаимодействие с работающими агентами в реальном времени.
Попарное сравнение
Сравнение двух выводов агента бок о бок — распространённый приём оценки, особенно для A/B-тестов версий модели или сравнения архитектур агентов.
Potato предлагает три режима сравнения:
- Бок о бок: обе трассы видны одновременно, прокрутка синхронизирована
- Последовательный: сначала смотрите трассу A, потом B, потом судите
- Вслепую: трассы случайным образом помечены «A» и «B» без указания модели
annotation_schemes:
  - annotation_type: "pairwise"
LangSmith поддерживает базовое попарное сравнение через «вид сравнения» в экспериментах оценки. Запуски разных версий модели сравнить можно, но интерфейс рассчитан на разглядывание запусков бок о бок, а не на структурную разметку предпочтений.
Langfuse встроенного попарного сравнения для разметки не имеет.
Когда какой инструмент брать
Берите Potato, когда:
- Разметка — ваша основная цель: вам нужны структурные человеческие суждения, а не только мониторинг
- Нужна поддержка кодовых агентов: отрисовка диффов, комментарии в строках, вывод терминала
- Вы собираете обучающие данные для PRM: пошаговые метки корректности с текущим счётом
- Нужно размещение у себя: данные остаются в вашей инфраструктуре, без зависимости от облака
- Вы работаете с несколькими агентными фреймворками: 15 конвертеров форматов трасс против привязки к одному
- Нужны богатые схемы оценки: оценка траектории, оценка по рубрике, ревью кода, попарное сравнение
- Бюджет ограничен: полностью бесплатно и с открытым кодом
Берите LangSmith, когда:
- Вы уже используете LangChain/LangGraph: трассы поступают автоматически без всякой настройки
- Главное для вас — продакшен-мониторинг: трассировка в реальном времени, отслеживание задержек и затрат
- Разметка вторична: вам нужны базовые оценки и обратная связь, а не глубокие схемы оценивания
- Вам нужна управляемая услуга: инфраструктуру поддерживать не надо
- Команда небольшая: бесплатного тарифа может хватить для лёгкой оценки
Берите Langfuse, когда:
- Нужна наблюдаемость с открытым кодом: мониторинг и трассировка у себя
- Вы используете несколько провайдеров LLM: хорошие интеграции с OpenAI, Anthropic, LangChain, LlamaIndex
- Разметка — не ваш основной сценарий: оценивание есть, но не в фокусе
- Нужно управление промптами рядом с трассировкой: Langfuse совмещает версионирование промптов с наблюдаемостью
- Нужна бесплатная альтернатива LangSmith для мониторинга: открытое ядро Langfuse закрывает большую часть потребностей в мониторинге
Взаимодополняющий подход: наблюдаемость плюс разметка
У многих команд практичная схема такая: инструмент наблюдаемости (LangSmith или Langfuse) для продакшен-мониторинга и Potato для подробной человеческой оценки. Процесс выглядит так:
- Инструментируйте агента через LangSmith или Langfuse для продакшен-трассировки
- Отберите трассы, которым нужен человеческий разбор (сбои, крайние случаи, случайные выборки)
- Выгрузите эти трассы из инструмента наблюдаемости
- Сконвертируйте и импортируйте их в Potato встроенными конвертерами
- Проведите человеческую оценку богатыми схемами разметки Potato
- Верните результаты в цикл разработки
# Example: convert failed traces exported from Langfuse and import to Potato
python -m potato.trace_converter \
  --input langfuse_failed_traces.json \
  --output data/traces_to_review.jsonl \
  --input-format langfuse
Так вы получаете обзор в реальном времени от платформы наблюдаемости вместе с глубиной разметки инструмента, сделанного под разметку.
Сводка ключевых отличий
Из всех инструментов, которые мы изучили, коммерческих и открытых, Potato — единственный, кто даёт настраиваемые разметчиком поверхности для структуры мультиагентной команды и разбора мультимодальных агентов:
- Кликабельный мультиагентный граф взаимодействий, редактируемый разметчиком: отметить критический путь, пометить неудачную передачу управления. Ближайшее, что есть в других местах, — «Agent Graphs» у Langfuse — отладочный вид только для чтения.
- Атрибуция сбоев между агентами, разбор передач управления как полноценный объект, оценочные карточки по агенту и по команде, таймлайн конкуренции за инструменты и разметка эмерджентного поведения — ничего из этого другие инструменты не предлагают как встроенные конструкции разметки.
- Траектории работы с компьютером с привязкой кликов, полнодуплексные голосовые таймлайны с оценкой перебиваний и временная привязка в видео с живым IoU. Scale AI делает привязку в GUI и оценку голоса, но как управляемые проекты по сбору датасетов, а его голосовая арена всё ещё работает по репликам.
Сверх этого Potato остаётся единственным бесплатным инструментом с размещением у себя, который совмещает отрисовку диффов кодовых агентов с комментариями в строках, сбор данных для PRM, наблюдение вживую с паузой, продолжением и перехватом, приём трасс из любого фреймворка, иерархическую таксономию ошибок с текущим счётом по серьёзности, три режима попарного сравнения и ревью кода в стиле пул-реквеста.
Нам не известен другой инструмент, открытый или коммерческий, который собирал бы всё это вместе — проверено по LangSmith, Langfuse, Labelbox, Scale AI, Label Studio, Argilla и Braintrust по состоянию на 2026-06-24 (см. сноску с датой под таблицей сравнения). LangSmith и Langfuse — сильные инструменты наблюдаемости, чьи возможности разметки сводятся к оценкам на уровне спана, а не к поверхностям по структуре агентов. Label Studio и Argilla — универсальные инструменты разметки; Label Studio прикрутил импорт трасс, но ни тот ни другой не даёт описанных выше поверхностей для мультиагентных и мультимодальных агентов. Labelbox и Scale предлагают продукты данных для оценки агентов, но как платные облачные или управляемые услуги, а не инструмент с размещением у себя, который исследовательская группа может запустить и доработать.
Если ваша цель — понять, как и почему ваши агенты справляются или нет, и собрать данные, чтобы их улучшить, Potato закрывает пробел, который остальные оставляют открытым.
Пути миграции
С LangSmith на Potato (для разметки)
# 1. Export your dataset from LangSmith
langsmith export dataset my_eval_dataset -o langsmith_data.jsonl

# 2. Convert to Potato format
python -m potato.trace_converter \
  --input langsmith_data.jsonl \
  --output data/traces.jsonl \
  --input-format langchain

# 3. Create your Potato config and start annotating
potato start config.yaml -p 8000
С Langfuse на Potato (для разметки)
# 1. Export traces from Langfuse via API
import requests

response = requests.get(
    "https://cloud.langfuse.com/api/public/traces",
    headers={"Authorization": "Bearer your_api_key"},
    params={"limit": 500}
)

with open("langfuse_traces.json", "w") as f:
json.dump(response.json()["data"], f)# 2. Convert to Potato format
python -m potato.trace_converter \
--input langfuse_traces.json \
--output data/traces.jsonl \
--input-format langfuse
# 3. Start annotating
potato start config.yaml -p 8000С Label Studio или Argilla (для оценки агентов)
Если сейчас вы используете Label Studio или Argilla для обычной разметки и хотите добавить оценку агентов, Potato может работать рядом с вашим текущим инструментом. Оставьте Label Studio или Argilla на неагентных задачах разметки (NER, классификация и т. д.), а Potato возьмите на оценку агентов, где нужны отрисовка трасс, разметка по шагам и ревью кода.
Заключение
Выбор между Potato, LangSmith и Langfuse — не вопрос того, кто лучше вообще. Он зависит от того, что вам нужно в первую очередь:
- Следить за агентами в продакшене — LangSmith или Langfuse.
- Оценивать поведение агента структурной человеческой разметкой — Potato.
- Нужно и то и другое — запускайте их вместе. Они дополняют друг друга.
Более полное сопоставление — в документации по сравнению и в руководстве по оценке агентов.