LLM против людей в разметке: когда автоматизировать, а когда нет
Практическое руководство: когда LLM может размечать ваши данные, где модели-разметчики подводят и как совмещать автоматизацию с человеческой проверкой в Potato.
Этот вопрос теперь всплывает в каждом проекте по разметке: люди для этого ещё нужны или модель справится сама? Вопрос справедливый. LLM-разметчики быстры, не устают и стоят доли того, во что обходится краудсорсинг. Ответ зависит от задачи, причём предсказуемым образом, и проваливаются обычно те проекты, где это так и не проверили.
LLM хорош как разметчик, когда задача чётко определена, метки объективны и вы можете сверить его с человеческой эталонной выборкой. Он плох, когда метки субъективны, культурно нагружены или настолько новы, что эталона ещё не существует. Безопасная стратегия по умолчанию — автоматизировать то, что модель делает надёжно, проверять выборку из остального и оставлять сложные случаи людям.
Результаты расходятся по типам задач
Выводы расходятся по типам задач. Gilardi, Alizadeh и Kubli (2023) обнаружили, что ChatGPT обошёл краудворкеров на определении релевантности, позиции и фрейма — с более высокой согласованностью и почти нулевой стоимостью. Но Ziems с коллегами (2024), проверив 13 моделей на 25 бенчмарках вычислительных социальных наук, показали, что картина неровная: на задачах классификации LLM достигают лишь умеренной согласованности с людьми и редко превосходят дообученную модель, зато на свободных объяснениях часто выдают текст, который читается лучше эталонных ответов краудсорсинга.
Так что вопрос «сможет ли LLM это разметить?» на самом деле распадается на два. Относится ли задача к типу, на котором модели хороши? И согласуется ли модель с людьми на ваших конкретных данных? Про первое можно рассуждать, зная тип задачи. Второе приходится измерять.
Где LLM-разметчики подводят
Сбои группируются, а значит, их можно предвидеть.
- Субъективные и культурно нагруженные метки. Токсичность, оскорбительность, юмор, вежливость и моральные суждения зависят от того, кто читает. Одна модель даёт один усреднённый ответ там, где разнородный пул разметчиков разошёлся бы во мнениях содержательно, — а именно это расхождение часто и было нужным сигналом.
- Систематическое смещение в сравнениях. Когда LLM судит два ответа, он не нейтральный арбитр. Zheng с коллегами (2023) задокументировали позиционное смещение (модель предпочитает показанный первым вариант), смещение в пользу многословности (награждает ответы подлиннее) и самовозвышение (предпочитает текст в собственном стиле). Они постоянны, поэтому сдвигают весь ваш датасет в одну сторону, а не просто добавляют шума.
- Эталона ещё нет. Если вы строите совершенно новую схему кодирования, сверять модель не с чем, а уверенная неверная метка хуже честного пробела. Новым схемам сначала нужны люди-кодировщики — хотя бы чтобы создать эталонный набор.
- Незаметный дрейф. Поведение модели меняется и вдоль длинного корпуса, и от версии к версии. Без фиксированной эталонной выборки, с которой вы регулярно сверяетесь, вы не заметите, как распределение меток уползает у вас под ногами.
Каждый из этих пунктов говорит о том, что вывод модели стоит считать хорошим черновиком, а не готовой меткой.
Схема, которая работает
Работающая схема — это триаж: отправляйте каждый объект по той дорожке, которая соответствует его сложности.
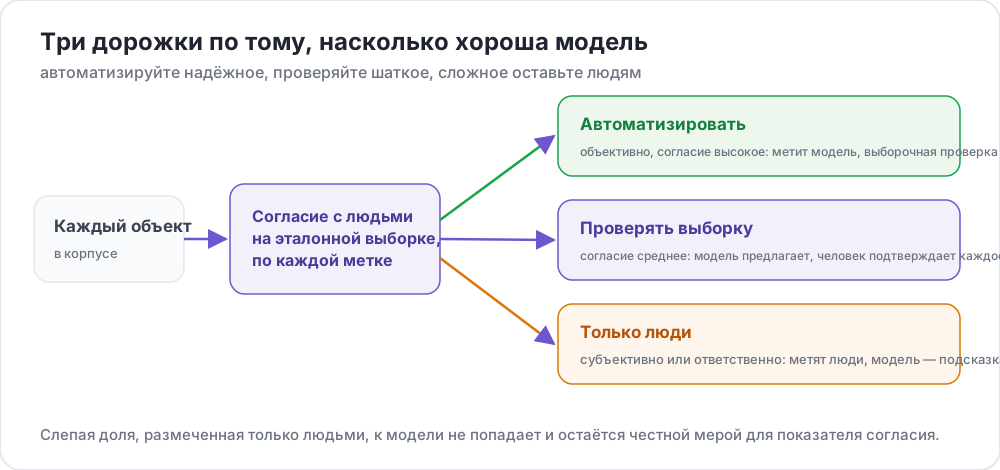 Automate what the model does well, verify a sample, keep the hard cases with people
Сначала прогоните модель по размеченной эталонной выборке и посмотрите согласованность по каждой метке, а не только общую. Там, где она сходится с людьми, отдайте ей эти объекты и выборочно перепроверяйте часть. Там, где согласованность средняя, оставьте подсказку модели, но пусть человек подтверждает каждую. Там, где метка субъективна или цена решения высока, оставьте объекты людям, а модель используйте в лучшем случае как подсказку. Пропорции по ходу проекта смещаются, по мере того как вы понимаете, где модели можно доверять, но форма остаётся той же.
Одно ограждение важно на всех этапах: держите слепую долю, размеченную только людьми, к которой модель не прикасается. Это ваш эталон измерения. Без него включается автоматизационное смещение: проверяющие не глядя подтверждают правдоподобные подсказки, и измеряемая согласованность ползёт вверх, тогда как реальное качество — нет.
Стоимость и качество
Легко представить это как «дешёвая модель против дорогих людей», но такая рамка прячет настоящий обмен. Метка от модели почти ничего не стоит в производстве и вполне ощутимо стоит в доверии: эталонный набор, который вы собрали для проверки, проход человеческой верификации, выборочные перепроверки. Человеческая метка дороже на входе и дешевле в доверии. На большой объективной задаче модель выигрывает по итоговой стоимости, как только затраты на валидацию размазываются по объёму. На маленькой или субъективной задаче накладные расходы на валидацию могут выйти дороже, чем просто разметить всё людьми. Посчитайте арифметику для своей задачи вместо того, чтобы предполагать, что модель дешевле.
Как это делается в Potato
Potato рассчитан на смешанный процесс и не заставляет выбирать «всё или ничего». Включите поддержку ИИ, чтобы модель предразмечала, а люди проверяли:
ai_support:
  enabled: true
  endpoint_type: openai       # or anthropic, gemini, ollama, ...
  ai_config:
    model: gpt-4
    api_key: ${OPENAI_API_KEY}
    temperature: 0.2
Модель предлагает метку; разметчик подтверждает её или исправляет, и сохраняется именно проверенная метка. Для самой маршрутизации схема триажа позволяет человеку быстро проходить подсказки модели, оставляя очевидные и отправляя остальные на более внимательную разметку.
Чтобы измерить модель относительно людей, не заполняйте заранее те объекты, которые вы отложили под замер согласованности. Оставьте слепую долю, дайте людям её разметить и сравните через каппу Коэна или Фляйса. Именно это число, по каждой метке, и решает, на какую дорожку попадает та или иная часть вашей задачи. Ограждения против автоматизационного смещения подробнее разобраны в руководстве по предразметке.
Что почитать дальше
- Кодбуки для ИИ-разметчиков — как превратить схему кодирования в нечто, что LLM сможет исполнить.
- Предразметка через LLM и модели зрения — механика подсказок модели и их проверки.
- Можно ли доверять вашему LLM-судье? — о калибровке LLM-судьи по человеческим оценкам.
- Активное обучение для разметки — как тратить человеческие силы на объекты, которые учат модель сильнее всего.