Можно ли доверять вашему LLM-судье? Калибровка LLM-как-судьи по людям
Оценивать выводы моделей с помощью LLM легко. Сложное — понять, верить ли ей. Разбор слепой человеческой калибровки в Potato 2.6: голосование по k выборкам, каппа Коэна и Фляйса и ожидаемая ошибка калибровки.
Оценивать выводы одних моделей с помощью большой языковой модели стало ходом по умолчанию. Вы пишете рубрику, просите GPT-4o или Claude оценить тысячу ответов и считываете число точности. Это быстро, дёшево и масштабируется дальше, чем способна разметить вручную любая команда людей.
Заодно это принимает на веру ровно то, что нужнее всего проверить: что судья согласен с людьми. LLM-как-судья, уверенно ошибающийся, выдаёт опрятную таблицу лидеров, за которой ничего не стоит. Прежде чем верить вердиктам судьи, надо измерить, насколько они следуют человеческому суждению. Этот шаг измерения и есть калибровка, и Potato 2.6 добавляет для неё рабочий процесс.
Полный список параметров — в справочной документации.
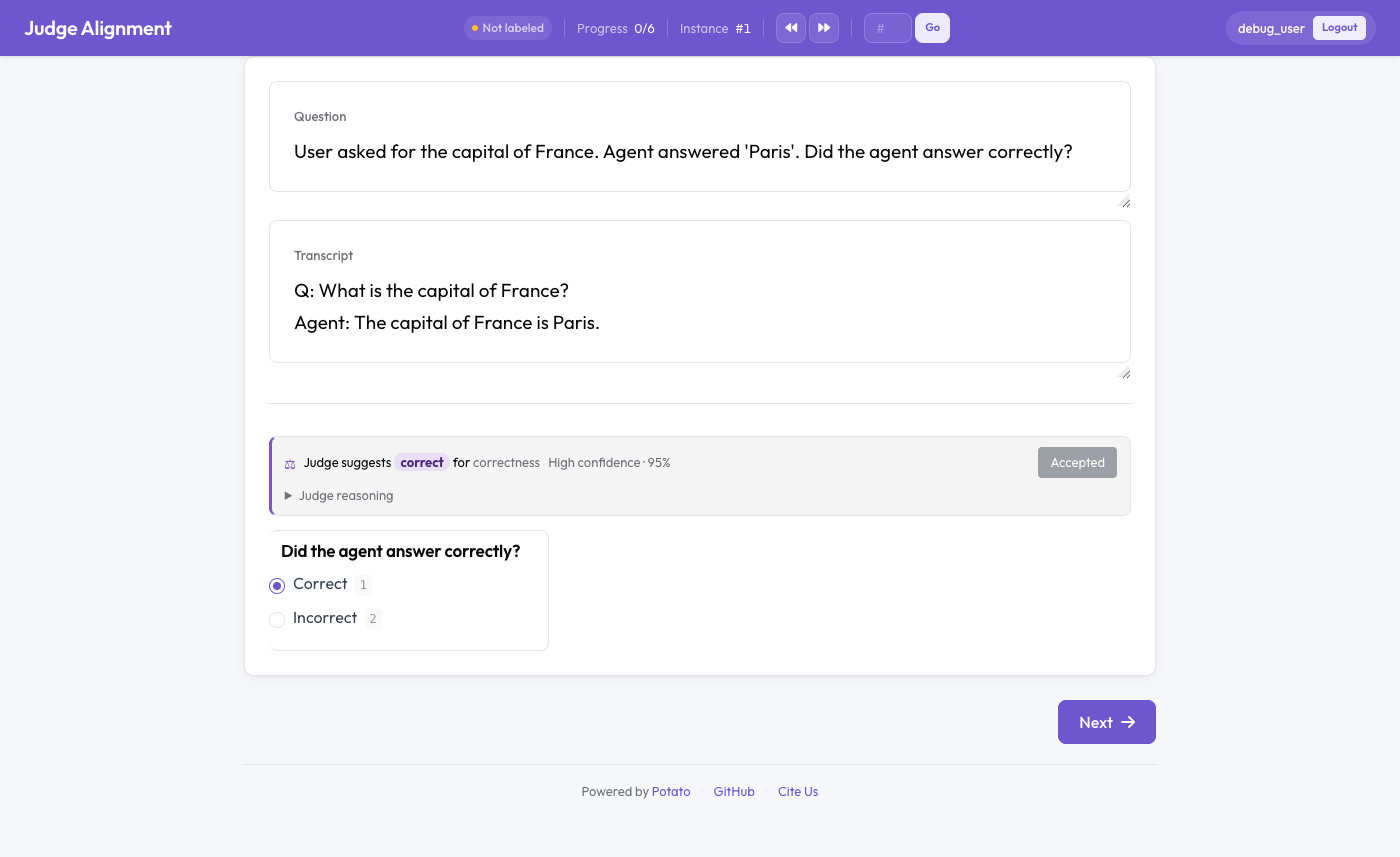 Inline judge calibration in Potato
Два способа, которыми судья подводит
Судья может подвести двумя разными способами, и поймать надо оба.
Первый — расхождение: судья называет «верным» то, что внимательный человек назвал бы «неверным». Это измеряют точность и метрики согласованности.
Второй — неправильная уверенность: судья говорит, что уверен на 95%, а прав в 60% случаев. Судья может иметь приличную точность и при этом быть плохо откалиброванным, а это становится важным ровно в тот момент, когда вы начинаете использовать его уверенность для маршрутизации работы или установки порогов. Это измеряет ошибка калибровки.
Проход калибровки в Potato устроен так, чтобы вскрывать оба сразу.
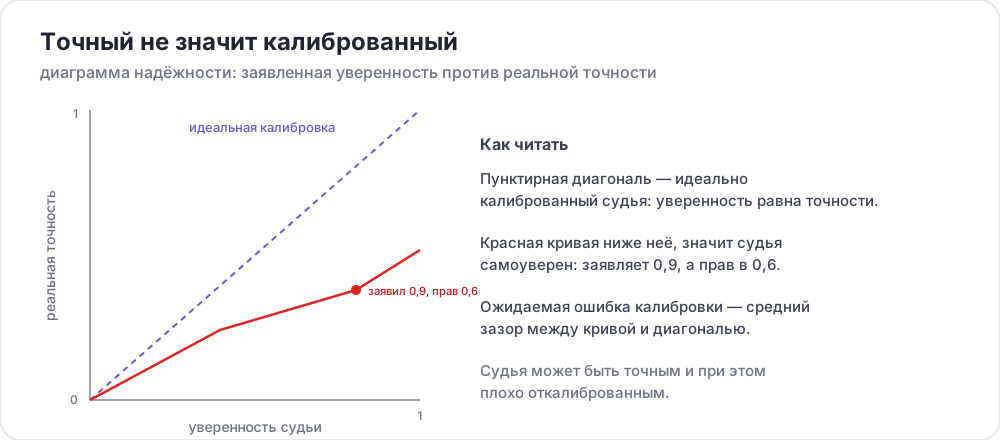 Accurate is not the same as calibrated
Прогон калибровки
Процесс идёт как короткий автомат состояний, от настройки судьи до готового отчёта:
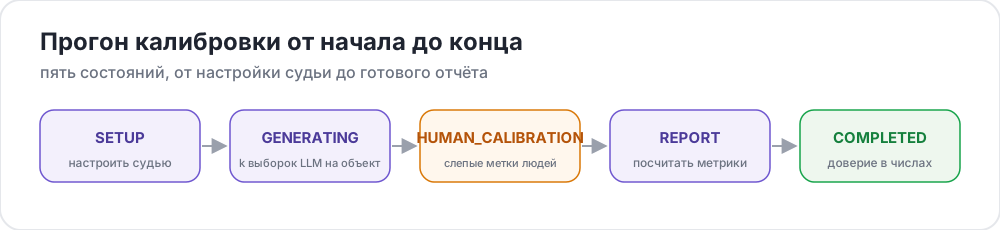 The five states of a calibration run
Генерация. Каждую модель опрашивают k раз на объект. Модальная метка по этим k выборкам — предсказание модели, а доля выборок, совпавших с ней, — её уверенность. Именно выборка k раз вместо одного даёт эмпирический сигнал уверенности, а не число, которое модель придумала про саму себя. Эти результаты уходят в отдельное хранилище и никогда не попадают в данные разметки.
Человеческая калибровка. Potato берёт случайную или стратифицированную выборку объектов и направляет их одному или нескольким людям, которые размечают их в обычном интерфейсе разметки, ни разу не увидев ответов модели.
Отчёт. Метрики считаются по пересечению того, что разметили модели, и того, что разметили люди, и записываются на диск.
Слепота здесь обеспечена структурно, а не просьбой к разметчикам не подглядывать. Поскольку метки модели живут в отдельном хранилище и в интерфейс не подставляются, человек не может опереться на них даже случайно.
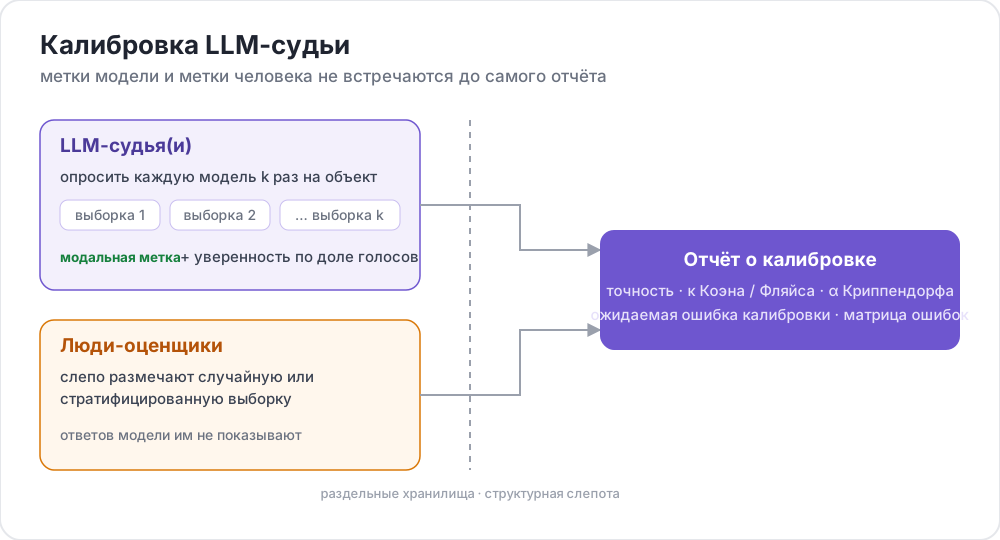 How Potato calibrates a judge against blind human labels
Конфигурация
Калибровка судьи — это один блок конфигурации. Вы пишете промпт судьи, перечисляете модели и задаёте, сколько раз опрашивать каждую:
judge_calibration:
  enabled: true
  prompt: |                       # supports {text}, {labels}, {description}
    You are an impartial expert annotator. Classify the sentiment as exactly
    one of: positive, negative, neutral.
  models:
    - endpoint_type: openai        # openai | anthropic | ollama | vllm | gemini | ...
      model: gpt-4o-mini
      api_key: ${OPENAI_API_KEY}
      temperature: 0.7             # must be > 0 so the k samples vary
    - endpoint_type: ollama
      model: llama3.1:8b
      base_url: http://localhost:11434
      temperature: 0.7
  k_samples: 5                     # samples per model per item
  max_items: 1000                  # cap on items the LLMs label (null = all)
  sampling:
    strategy: stratified           # random | stratified | all
    sample_size: 200               # how many items humans blind-label
    seed: 42
  human:
    num_raters: 1                  # 1 = solo researcher; N adds human-human IAA
    gold: single                   # single | majority
  schemas: [sentiment]
  output:
    dir: judge_calibration_output
Внимание: задайте
temperature > 0. Приk_samples > 1и нулевой температуре выборки одинаковы, уверенность намертво равна 1.0, а отчёт о калибровке бессмыслен. Увидев такое сочетание, Potato выдаёт предупреждение при запуске.
Можно перечислить несколько моделей и откалибровать их бок о бок — это естественный способ выбрать между дешёвым локальным судьёй и дорогим хостинговым.
Попробовать без ключа API
Прилагаемый пример использует локальную модель Ollama, так что весь цикл можно прогнать офлайн. Запустите Ollama, скачайте модель и стартуйте:
ollama pull llama3.2:3b
python potato/flask_server.py start examples/ai-assisted/judge-calibration/config.yaml -p 8000 --debug
Откройте http://localhost:8000/judge_calibration/admin, чтобы настроить и запустить прогон, разметьте выборку вслепую на /annotate, затем соберите отчёт и прочитайте его на /judge_calibration/report.
Что говорит отчёт
Отчёт построен так, чтобы ответить на вопрос «стоит ли доверять этому судье?» числами, которые можно вписать в раздел о методике:
- Точность, precision, recall, F1 для каждой модели относительно человеческой эталонной метки.
- κ Коэна с разбивкой на пары человек↔модель, модель↔модель и человек↔человек, чтобы видеть, согласуется ли судья с людьми не хуже, чем люди между собой.
- κ Фляйса и α Криппендорфа по всем оценщикам.
- Ожидаемая ошибка калибровки (ECE), бины надёжности и оценка Брайера — ответ на сбой с неправильной уверенностью.
- Матрица ошибок по каждой модели, обычно самая содержательная панель: судья, который в порядке на лёгких классах и разваливается на одном трудном различении.
Всё считается по пересечению: объектам, размеченным и моделями, и людьми, в пределах калибровочной выборки. Результат попадает в output.dir файлами llm_labels.jsonl, report.json и удобочитаемым report.html.
Какие схемы поддерживаются
Калибровка полностью поддержана на категориальных схемах, которыми пользуется большинство судей, и дотягивается до более сложных типов:
| Тип | Статус | Метрики |
|---|---|---|
radio / select | Поддерживается | точность, P/R/F1, κ Коэна и Фляйса, α Криппендорфа, ECE, матрица ошибок |
likert | Поддерживается | всё вышеперечисленное плюс MAE и порядковая α Криппендорфа |
multiselect | Поддерживается | P/R/F1 по каждой метке, средний Жаккар, точность точного совпадения, калибровка |
span | Экспериментально | P/R/F1 по совпадению IoU, средний IoU, span-F1, калибровка на уровне спанов |
Калибровка спанов кластеризует символьные смещения судьи по k выборкам и сопоставляет их с эталоном по пересечению над объединением; относитесь к этим числам как к ориентирующим, а не точным.
Калибровка против сверки
В Potato есть второй, родственный процесс, который легко перепутать с этим. Сверка судьи калибрует одного судью по существующему человеческому эталону, показывает его вердикт прямо во время разметки и построена вокруг доработки рубрики до тех пор, пока согласованность не вырастет.
Правило простое: берите калибровку, когда отбираете кандидатов в судьи и хотите слепое эмпирическое число уверенности; берите сверку, когда судья уже выбран и вы дорабатываете его рубрику по фиксированному эталону. Оба процесса вместе разобраны в Замыкая цикл.
LLM-судьи никуда не денутся: оценивать надо слишком много, а людей слишком мало. Калибровка даёт число, показывающее, насколько далеко судье можно доверять, прежде чем понадобится человек.
Документация по калибровке судьи покрывает все параметры, а руководство по согласованности разметчиков подробно объясняет метрики каппа и альфа.