Potato 2.7.1: a transcrição já existe
O Potato 2.7.1 lê 21 formatos de transcrição e legendas diretamente, carrega-os de arquivos adjacentes à sua mídia e traz um conversor que transforma uma pasta de saída de ASR em um arquivo de dados pronto para anotação.
Quase ninguém chega a uma ferramenta de anotação com áudio bruto e mais nada. As pessoas chegam com uma transcrição. Alguém rodou o Whisper numa pasta de entrevistas. Alguém baixou as legendas de cem palestras de conferência. Alguém herdou um corpus de TextGrids de um projeto de campo que acabou em 2019.
E aí a ferramenta pede que essa pessoa escreva um script de conversão.
O Potato 2.7.1 é sobre eliminar esse passo. Ele lê 21 formatos de transcrição e legendas diretamente, carrega-os de arquivos que ficam ao lado da sua mídia em vez de exigir que tudo seja colado num arquivo de dados, e inclui um conversor para o caso em que você de fato quer um arquivo de dados no fim.
 Potato 2.7.1
21 formatos na entrada, um modelo na saída
Eram 6. A lista completa está na página Formatos de transcrição, mas em linhas gerais: nove tipos de saída de ASR (Whisper JSON, WhisperX e outros JSON diarizados, whisper.cpp, Whisper TSV, AWS Transcribe, Deepgram, AssemblyAI, Rev.ai, SPoRC), seis formatos de legenda (SubRip, WebVTT, SubStation Alpha, TTML e DFXP, YouTube json3, YouTube srv1/srv2/srv3), três do mundo do alinhamento forçado (NIST CTM, Praat TextGrid, ELAN EAF) e três formatos genéricos para dados que vieram de algum outro lugar.
Os formatos de alinhamento são a adição que mais nos alegra. A exportação para EAF e TextGrid já existia, então anotações em camadas agora fazem o caminho de ida e volta: traga um alinhamento pronto, corrija no Potato, devolva ao ELAN ou ao Praat.
A detecção funciona pelo formato dos dados e não pela extensão do arquivo, o que significa que um arquivo WebVTT chamado captions.txt continua sendo interpretado como WebVTT, e significa que a mesma transcrição funciona incorporada ou lida do disco sem mudar a configuração.
Marcações de tempo em nível de palavra e confiança por segmento são preservadas quando a fonte as traz. Formatos que são nativamente por palavra, como CTM, Deepgram e AssemblyAI, são agrupados em turnos na troca de falante mais um limiar de pausa.
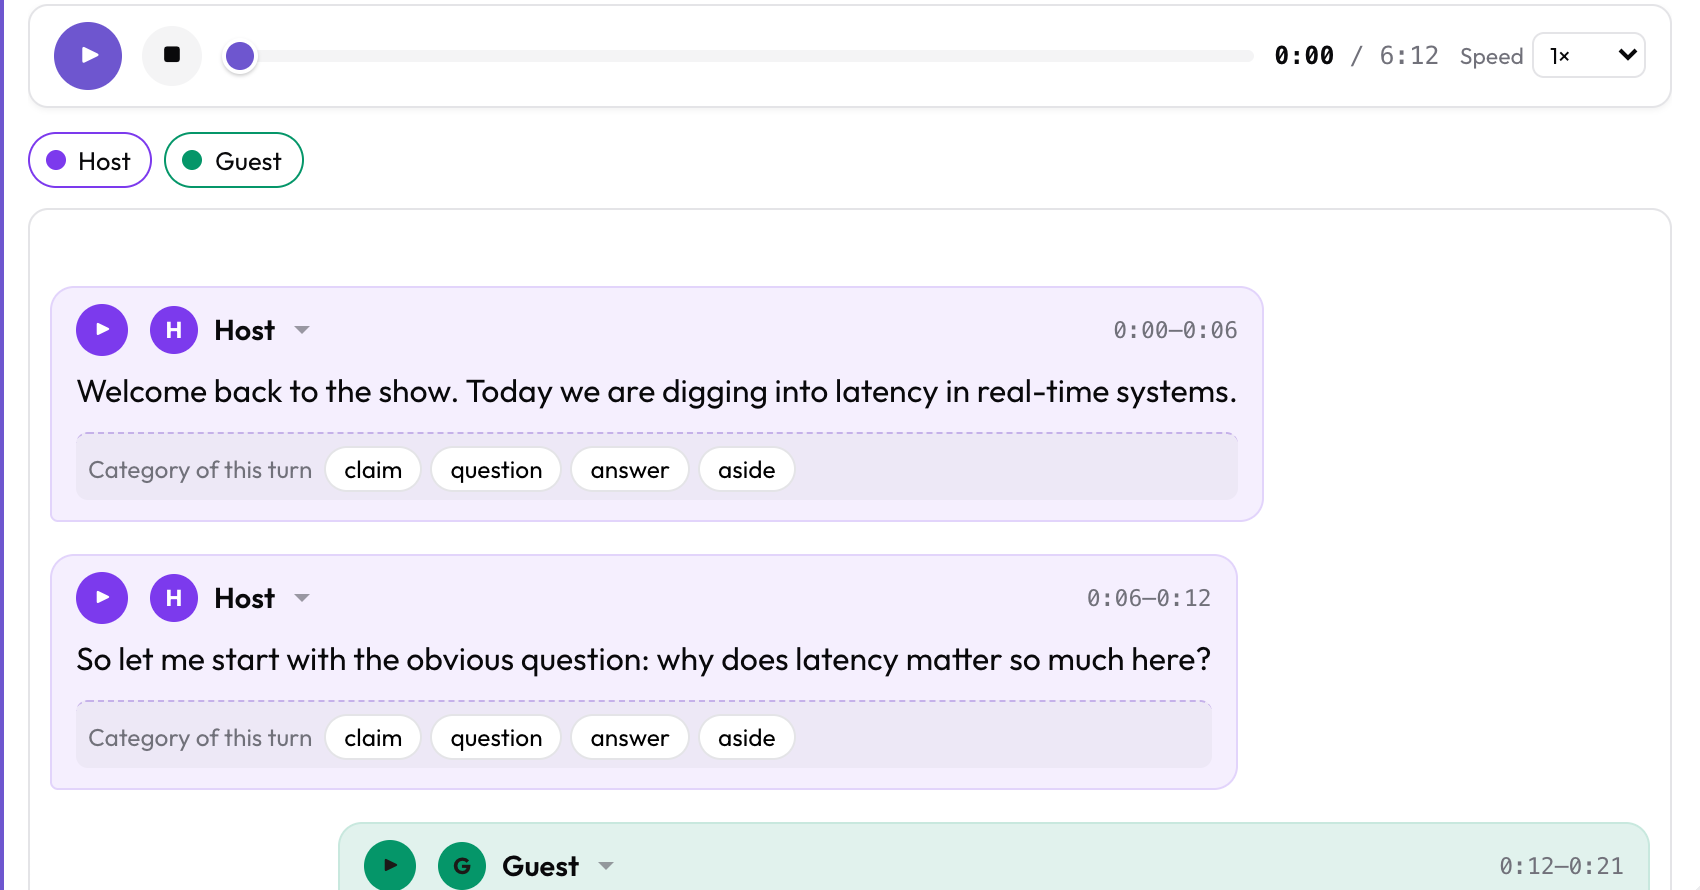 Seja qual for o formato que entrou, é isto que sai
Arquivos adjacentes
Sua ferramenta de ASR já escreveu os arquivos num arranjo sensato: a mídia aqui, a transcrição do lado. Não havia razão boa para obrigar você a achatar isso num blob de dados, então agora dá para simplesmente apontar:
{"id": "int_001", "conversation": {"audio": "media/int_001.mp3",
                                   "transcript": "media/int_001.srt"}}
Os caminhos se resolvem em relação a task_dir e passam pela mesma validação contra travessia de diretórios que todo outro caminho configurado. Se os seus dados realmente contêm transcrições embutidas de uma linha que por acaso parecem nomes de arquivo, transcript_is_path: false desliga a heurística.
O benefício prático é que suas transcrições continuam sendo arquivos. Dá para versionar, regerar e entregar a outra pessoa, em vez de ter uma cópia fossilizada dentro de um array JSON.
Um conversor para o outro caso
Às vezes você quer mesmo um único arquivo de dados. O potato transcripts varre uma pasta, pareia cada transcrição com sua mídia pelo nome-base, deriva os ids dos itens a partir dos nomes de arquivo e escreve o resultado:
potato transcripts ./whisper_out --media-dir ./audio -o data/interviews.jsonO --dry-run não escreve nada e te diz o que encontrou, o que também é a primeira coisa a rodar quando uma transcrição aparece como um bloco único indiferenciado:
Scanned 3 file(s):
  interview_01.json      Whisper JSON      42 turns    891.4s  undiarized
  interview_02.json      WhisperX JSON     51 turns   1120.8s  2 speaker(s): SPEAKER_00, SPEAKER_01
  interview_03.json      Whisper JSON      38 turns    754.2s  undiarized

3 item(s), 131 turn(s).
Um arquivo reportado como plain text é quase sempre um .txt do Whisper que se misturou com a saída .json. O .txt não tem marcação de tempo nenhuma, e não dá para recuperá-la sem rodar o modelo de novo. Esse fato sozinho explica a maior parte dos relatos de "por que minha transcrição está estranha" que a gente vê.
O --emit-config imprime um config.yaml correspondente junto com o arquivo de dados.
Um vocabulário só para quatro esquemas
audio_dialogue, speech_transcript, voice_interaction e tiered_annotation interpretavam dados de transcrição cada um do seu jeito e aceitavam subconjuntos diferentes de formatos, por nenhum motivo que alguém soubesse explicar. Agora eles compartilham um normalizador só, então o que um aceita, os quatro aceitam.
Configurações existentes não são afetadas. Cada esquema mantém a interpretação antiga como recuo, e todo formato de transcrição que funcionava antes continua funcionando byte a byte.
O tiered_annotation também ganha a semeadura opcional a partir da transcrição. Aponte transcript_field para a sua transcrição e uma camada chega pré-preenchida, de modo que os anotadores corrijam um alinhamento existente em vez de resegmentar a fala do zero:
  - annotation_type: tiered_annotation
    name: tiers
    source_field: audio_url
    media_type: audio
    tiers:
      - name: utterance
        labels:
          - name: speech
            color: "#7c3aed"
Os intervalos semeados só são salvos quando um anotador de fato os edita, então uma semente intocada nunca é atribuída por engano a trabalho humano.
O que o Potato continua não fazendo
Ele não transcreve, e não diariza. O ASR roda a montante. O Potato lê o que a sua cadeia de processamento produziu.
Isso aparece porque o Potato de fato roda um modelo Whisper local, para o Modo Think-Aloud, que grava os anotadores falando enquanto trabalham. Aquilo é um recurso de captura voltado aos seus anotadores, não ao seu corpus. Coisa diferente, mesma palavra.
A confiança em nível de palavra é interpretada e guardada no modelo de dados quando a fonte a traz, mas ainda não há interface para visualizá-la.
E alguns formatos não têm interpretador nenhum: SAMI, MicroDVD, SubViewer, Transcriber .trs, EXMARaLDA, CHAT/CHILDES, RTTM isolado e a saída nativa do Montreal Forced Aligner ou do Gentle. Converta esses antes. Publicamos essa lista porque uma lista de formatos suportados sem nada excluído dela não vale muito.
Documentação
- Formatos de transcrição — cada formato com sua regra de detecção, o modelo de turnos normalizado, as regras de arquivos adjacentes, as chaves de configuração e a solução de problemas atrelada a sintomas reais
- Como anotar transcrições do Whisper — qual arquivo de saída guardar, e por que a diarização é uma decisão à parte
- Como anotar legendas do YouTube — o
yt-dlp, e o que as legendas automáticas vão e não vão suportar - Transcript Format Ingestion — um projeto executável com seis formatos lado a lado
Atualizando
pip install --upgrade potato-annotation==2.7.1Você não precisa mudar nenhuma configuração. Todo formato de transcrição que o Potato aceitava antes, ele continua aceitando.