Desenhando caixas delimitadoras para detecção de objetos
Monte uma tarefa de detecção de objetos no Potato, de uma configuração inicial com três rótulos até uma configuração de produção para imagens de direção, e exporte para COCO ou YOLO.
Este tutorial monta uma tarefa de anotação para detecção de objetos no Potato, começando por uma configuração com três rótulos e terminando na exportação COCO ou YOLO com que um detector é treinado. Para a lista completa de ferramentas de imagem e suas opções, consulte a documentação de anotação de imagens.
O arquivo de dados
Cada linha do arquivo de dados é uma imagem. O Potato precisa de um identificador e de um campo com a URL ou o caminho da imagem, e item_properties indica qual campo é qual:
{"id": "img_001", "image_url": "https://example.com/street_001.jpg"}
{"id": "img_002", "image_url": "/static/images/street_002.jpg"}
Um caminho relativo é resolvido a partir de media_directory, então imagens locais não precisam de um servidor de arquivos em execução.
Uma configuração mínima
O esquema image_annotation controla a área de desenho. Ele precisa de um nome, de uma descrição que os anotadores leem como instrução, das ferramentas a habilitar e do conjunto de rótulos:
annotation_task_name: "Object Detection Annotation"
task_dir: "."
output_annotation_dir: "annotation_output/"

data_files:
  - "data/images.json"

item_properties:
  id_key: id
  text_key: image_url

annotation_schemes:
  - annotation_type: image_annotation
    name: objects
    description: "Draw a box around every car, person, and bicycle"
    tools:
      - bbox
    labels:
      - name: car
        color: "#FF6B6B"
      - name: person
        color: "#4ECDC4"
      - name: bicycle
        color: "#45B7D1"
Três rótulos é um ponto de partida proposital. Cada rótulo que você adiciona é uma decisão que o anotador precisa tomar em cada objeto, e um caso limite que precisa ser explicado a ele, então comece pelas classes de que o modelo realmente precisa e adicione as demais quando as diretrizes estiverem se sustentando.
Inicie o servidor e abra a tarefa:
potato start config.yaml -p 8000O que o anotador faz
O anotador escolhe um rótulo e depois arrasta um retângulo em volta de cada objeto, ajustando os cantos até a caixa ficar justa:
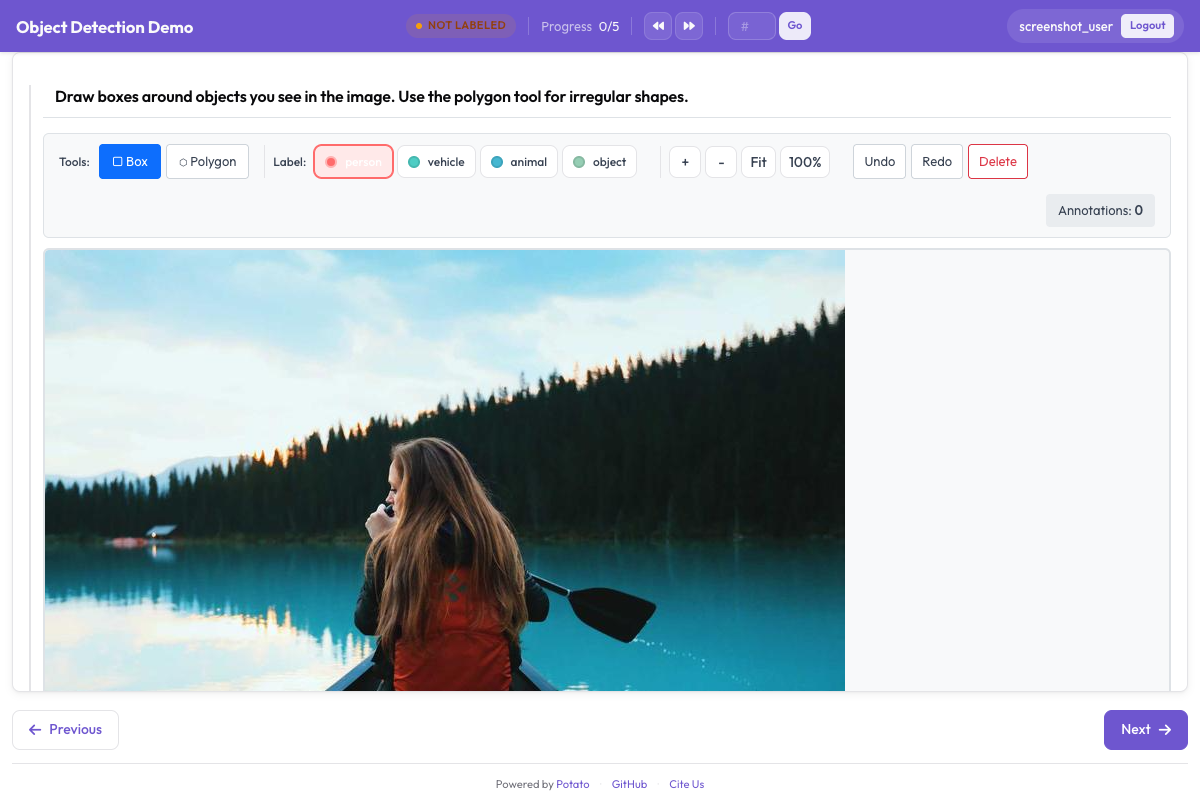 A ferramenta de caixa delimitadora permite que os anotadores desenhem e rotulem regiões retangulares nas imagens
Zoom e deslocamento vêm ativados por padrão, o que importa para objetos pequenos ou distantes. Os dois podem ser desativados com zoom_enabled: false e pan_enabled: false quando as imagens são uniformes e os controles extras só atrapalham.
Atalhos de rótulos
No perfil de atalhos padrão v7, as ferramentas usam teclas de letras: r seleciona a ferramenta de caixa, p o polígono e b o pincel. Os atalhos de rótulo são definidos por rótulo com key_value, e dígitos são a escolha segura, porque um rótulo cujo key_value coincide com a tecla de uma ferramenta dispara as duas ações ao mesmo tempo:
annotation_schemes:
  - annotation_type: image_annotation
    name: objects
    description: "Annotate all visible objects"
    tools:
      - bbox
    labels:
      - name: person
        color: "#FF6B6B"
        key_value: "1"

      - name: car
        color: "#4ECDC4"
        key_value: "2"

      - name: motorcycle
        color: "#45B7D1"
        key_value: "3"

      - name: bicycle
        color: "#96CEB4"
        key_value: "4"

      - name: traffic_light
        color: "#FFEAA7"
        key_value: "5"

      - name: stop_sign
        color: "#DDA0DD"
        key_value: "6"
Vale a pena escolher as cores em vez de aceitar as que vierem. Em cenas de trânsito densas, o anotador está procurando o que deixou passar, e duas cores parecidas em classes vizinhas tornam essa busca mais lenta. Defina keybinding_profile: legacy se seus anotadores aprenderam os atalhos do Potato anteriores à 2.8 e você prefere não treiná-los de novo.
Adicionando atributos aos objetos
O Potato não tem um bloco de atributos por caixa. De um rótulo de image_annotation são lidos name, color e key_value, e todo o resto do dicionário do rótulo é descartado, então uma lista aninhada attributes: não faz nada e nenhuma pergunta aparece depois que uma caixa é desenhada.
Há duas maneiras de capturar a mesma informação. Incorpore a distinção ao conjunto de rótulos, de modo que o atributo faça parte do que o anotador escolhe:
annotation_schemes:
  - annotation_type: image_annotation
    name: objects
    description: "Draw a box around each object"
    tools:
      - bbox
    labels:
      - name: person
        color: "#FF6B6B"
      - name: person_occluded
        color: "#C44536"
Ou pergunte sobre a imagem como um todo com um segundo esquema. Isso se aplica ao item e não a uma caixa individual, e esse é o custo: você fica sabendo que algo na imagem estava ocluído, mas não qual caixa era:
  - annotation_type: multiselect
    name: image_conditions
    description: "Conditions affecting this image"
    labels:
      - Heavy occlusion
      - Truncated objects
      - Low light
A importação a partir do VIA é o único lugar em que atributos sobrevivem: via_importer lê os region_attributes de cada região e os incorpora ao rótulo. Esse é um conceito do momento da importação, não da configuração.
Exigindo pelo menos uma caixa
Uma imagem sem caixas é ambígua, já que pode significar que o anotador não encontrou nada ou que pulou o item. min_annotations força a distinção ao recusar um envio com menos formas do que o mínimo, então uma imagem realmente vazia precisa de um rótulo negativo explícito:
annotation_schemes:
  - annotation_type: image_annotation
    name: objects
    description: "Draw a box around every traffic participant"
    tools:
      - bbox
    labels: [...]
    min_annotations: 1
Controlando o tamanho em que a imagem é exibida
A área de desenho acompanha a imagem renderizada, então uma imagem exibida pequena dá ao anotador uma tela pequena. instance_display define o tamanho, e o zoom continua disponível para trabalhos de detalhe:
instance_display:
  fields:
    - key: image_url
      type: image
      label: "Frame"
      display_options:
        max_width: 1200
        max_height: 800
        zoomable: true
Uma configuração de produção
A configuração de direção abaixo traz as cinco classes de que um conjunto de dados de detecção precisa. Os rótulos mantêm atalhos numéricos para que a mão esquerda do anotador fique na fileira de números, e min_annotations: 1 se justifica porque todo quadro deste corpus contém pelo menos um participante do trânsito:
annotation_task_name: "Autonomous Driving - Object Detection"
task_dir: "."
output_annotation_dir: "annotation_output/"

data_files:
  - "data/driving_frames.json"

item_properties:
  id_key: id
  text_key: frame_path

annotation_schemes:
  - annotation_type: image_annotation
    name: objects
    description: "Annotate all traffic participants and objects"
    tools:
      - bbox
    min_annotations: 1
    labels:
      - name: vehicle
        color: "#FF6B6B"
        key_value: "1"

      - name: pedestrian
        color: "#4ECDC4"
        key_value: "2"

      - name: cyclist
        color: "#45B7D1"
        key_value: "3"

      - name: traffic_sign
        color: "#FFEAA7"
        key_value: "4"

      - name: traffic_light
        color: "#DDA0DD"
        key_value: "5"
Cinco classes já está no limite do que os atalhos numéricos cobrem com conforto. Acima de dez, o anotador passa a procurar teclas em vez de ler o quadro, e a partir desse ponto dividir a tarefa em duas é melhor do que adicionar mais um rótulo.
Como ficam as anotações
O Potato armazena todas as formas de uma imagem em um array JSON plano, seja qual for a ferramenta que as desenhou. As coordenadas são normalizadas no intervalo de 0 a 1 em relação à imagem, então as anotações continuam corretas quando a imagem é servida depois em outro tamanho:
[
  {
    "type": "bbox",
    "label": "vehicle",
    "color": "#FF6B6B",
    "coordinates": {"x": 0.234, "y": 0.352, "width": 0.120, "height": 0.130}
  },
  {
    "type": "bbox",
    "label": "pedestrian",
    "color": "#4ECDC4",
    "coordinates": {"x": 0.427, "y": 0.370, "width": 0.026, "height": 0.139}
  }
]
Uma bbox guarda sua geometria em coordinates como {x, y, width, height}. Polígonos guardam uma lista de pontos na mesma chave, e máscaras guardam codificação por comprimento de sequência (run-length encoding) em rle.
Exportando para treinamento
O código de treinamento de detectores lê COCO ou YOLO, e o Potato escreve os dois:
python -m potato.export --config config.yaml --format coco --output ./export/
python -m potato.export --config config.yaml --format yolo --output ./export/
As duas exportações diferem em mais do que a sintaxe. O COCO escreve um único annotations.json com caixas em pixels no formato [x, y, width, height] e não copia as imagens, então os valores de file_name apontam para onde as imagens já estão. O YOLO escreve um arquivo de texto por imagem com coordenadas de centro normalizadas, separa imagens e rótulos em diretórios train/ e val/, e adiciona data.yaml e classes.txt para que uma execução de treinamento consiga ler a lista de classes sem que ela precise ser informada à parte.
Mantendo as caixas consistentes
Desenhe as caixas justas ao objeto, já que cada pixel de fundo dentro da caixa é um pixel que o modelo aprende a chamar de primeiro plano. Registre por escrito como tratar os casos difíceis (oclusão, objetos cortados na borda do quadro, reflexos) e revise juntos um lote de exemplos na primeira semana, enquanto mudar a diretriz ainda custa pouco. Acompanhe a contagem de caixas e a distribuição de tamanhos por anotador ao longo do estudo, porque uma mudança repentina geralmente significa que uma pessoa passou a interpretar uma regra de outra forma, e não que as imagens mudaram.
Próximos passos
- Adicione anotação de polígonos quando as caixas forem grosseiras demais para a tarefa
- Use conjuntos de pontos-chave para estimativa de pose
- Configure o controle de qualidade antes que o estudo passe de um punhado de anotadores
Para as demais opções de imagem, consulte Anotação de imagens.