Annotation d'agents de coding : évaluer les traces de Claude Code, Aider et SWE-Agent
Potato affiche les traces d'agents de coding sous forme de diffs et de blocs de terminal, avec des schémas de récompense de processus et de revue de code, et des convertisseurs pour Claude Code, Aider et SWE-Agent.
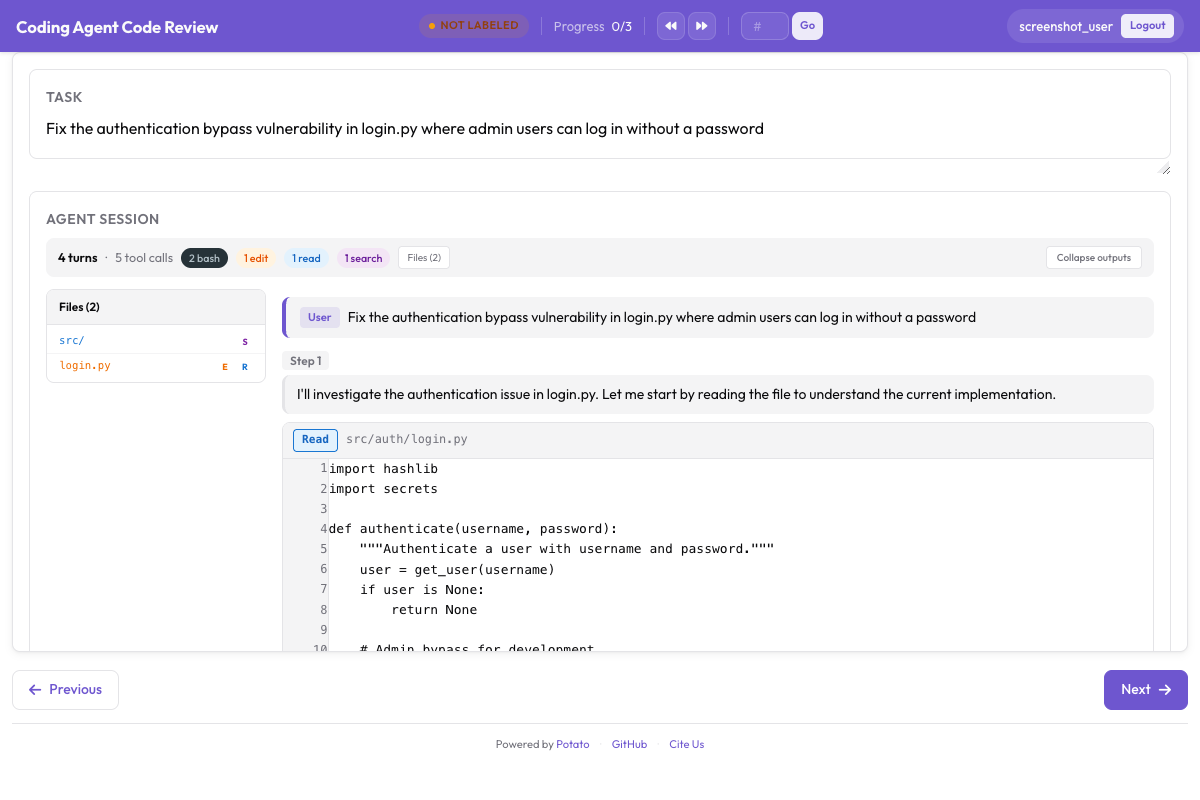
Potato annote désormais directement les sessions d'agents de coding. Une trace s'affiche sous forme de diffs unifiés, de blocs de terminal sombres, de lectures de fichiers avec numéros de ligne et d'une arborescence de tous les fichiers touchés par l'agent. Trois convertisseurs pour les formats d'agents de coding (claude_code, aider et swe_agent_trajectory) s'ajoutent aux douze autres formats de traces que Potato lit déjà, ainsi que deux schémas d'annotation conçus pour ces données, process_reward pour la justesse au niveau des étapes et code_review pour une revue des diffs à la manière de GitHub.
Une exécution d'agent de coding est une longue trajectoire de lectures de fichiers, de modifications, de commandes de terminal et de raisonnement. Une interface d'annotation en texte brut aplatit tout cela en un mur de caractères, et c'est pourquoi les équipes qui évaluent des agents ont eu tendance à écrire leur propre interface de revue et à produire des jeux de données que personne d'autre ne peut utiliser. Pour la référence complète, voir la documentation sur l'annotation d'agents de coding et le guide d'évaluation d'agents.
Deux points à vérifier avant de planifier une étude
Les transcriptions de Claude Code ne contiennent pas le texte de réflexion du modèle. Les fichiers conservent le bloc thinking et sa signature mais en suppriment le contenu, ce qu'on a mesuré sur 6 393 blocs répartis dans 40 sessions locales, sans aucun texte dans aucun d'eux. La trace convertie indique le nombre de ces blocs, de sorte que le manque est visible et non silencieux. Si les annotateurs ont besoin du raisonnement pour juger les étapes, capturez-le en direct avec claude -p --output-format stream-json ou avec l'Agent SDK au lieu de le relire depuis le disque.
Les transcriptions contiennent aussi des chemins absolus, des noms de branches, des détails d'environnement et tout le code source que la session a lu. Caviardez-les avant de partager un jeu de données, et obtenez le consentement des personnes à qui appartiennent ces sessions.
L'affichage des traces
Les traces de code s'affichent via le type d'affichage coding_trace, déclaré dans instance_display à côté de tout ce que l'annotateur doit voir par ailleurs. Potato sépare ce qui est affiché de ce qui est demandé, si bien que le même affichage de traces fonctionne avec n'importe quel schéma d'annotation :
instance_display:
  layout:
    direction: vertical
    gap: 16px
  fields:
    - key: task_description
      type: text
      label: "Task"
    - key: structured_turns
      type: coding_trace
      label: "Agent Session"
      display_options:
        show_file_tree: true
        diff_view: unified
        collapse_long_outputs: true
        max_output_lines: 50
        terminal_theme: dark
        show_step_numbers: true
        show_reasoning: true
Chaque appel d'outil est rendu selon ce que l'outil a fait, si bien que l'annotateur lit un diff comme un diff et non comme du texte échappé :
| Outil | Rendu |
|---|---|
Read | Bloc de code avec numéros de ligne |
Edit, Replace | Diff unifié avec lignes rouges et vertes |
Write, Create | Bloc de code de nouveau fichier, entièrement en vert |
Bash, Terminal, Shell | Bloc de terminal sombre avec une invite $ |
Grep, Glob, Search, Find | Bloc de code des résultats de recherche |
| Tout autre outil | Entrée et sortie au format JSON |
 Une trace de code avec diffs unifiés, sortie de terminal et barre latérale d'arborescence de fichiers
collapse_long_outputs avec max_output_lines: 50 est le réglage qui décide si une trace est lisible. Une seule exécution de pytest peut afficher plusieurs centaines de lignes, et un annotateur qui doit les faire défiler à chaque étape cesse de lire les étapes.
Le format des données
Le format structured_turns conserve la structure des appels d'outils dont l'affichage a besoin. Chaque tour porte un rôle, le contenu textuel et une liste d'appels d'outils :
{
  "id": "session_001",
  "task_description": "Fix the authentication bypass in login.py",
  "model": "claude-sonnet-4-20250514",
  "structured_turns": [
    {
      "role": "assistant",
      "content": "I'll investigate the auth issue.",
      "tool_calls": [
        {
          "tool": "Read",
          "input": {"file_path": "src/auth/login.py"},
          "output": "def login(user, password):\n    if user.role == 'admin':\n        return True",
          "output_type": "code",
          "language": "python"
        },
        {
          "tool": "Bash",
          "input": {"command": "pytest tests/test_auth.py -v"},
          "output": "4 passed",
          "output_type": "terminal"
        }
      ]
    }
  ]
}
output_type accepte code, diff, terminal ou generic, et Potato le déduit de l'outil et de l'extension du fichier quand vous l'omettez. Définissez-le explicitement quand la sortie d'un outil ne correspond pas à ce que son nom laisse attendre.
Convertir les traces que vous avez déjà
Le convertisseur lit un format et écrit le JSONL que Potato charge. Trois de ses formats sont des agents de coding :
# Claude Code, or any Anthropic Messages API transcript
python -m potato.trace_converter -i traces.json -f claude_code -o data/traces.jsonl

# Aider chat history with SEARCH/REPLACE blocks
python -m potato.trace_converter -i chat.md -f aider -o data/traces.jsonl

# SWE-Agent trajectories
python -m potato.trace_converter -i trajectory.json -f swe_agent_trajectory -o data/traces.jsonl

# Mixed directory, format detected per file
python -m potato.trace_converter -i traces.json --auto-detect -o data/traces.jsonl
Le convertisseur claude_code lit les transcriptions de session propres à Claude Code aussi bien que la forme brute de l'API Messages. Claude Code écrit un fichier JSONL par session sous ~/.claude/projects/<slugified-working-directory>/<session-id>.jsonl, et le convertisseur transforme une session en une seule trace plutôt qu'en une trace par ligne :
python -m potato.trace_converter \
  -i ~/.claude/projects/-home-me-myrepo/3c853f0f-....jsonl \
  --auto-detect -o data/session.jsonl
Il suit la chaîne parentUuid et ne garde que le chemin qui a survécu, de sorte que les tentatives rembobinées sont écartées et comptées au lieu d'être annotées comme si elles avaient eu lieu. Les messages de chaîne latérale vont dans sidechain_runs, hors des tours principaux. Les commandes slash sont écartées, puisque c'est la CLI qui se parle à elle-même. La forme sur disque appartient à la CLI et non à une API publiée, donc considérez ce lecteur comme fonctionnant au mieux d'une mise à jour à l'autre. Il ignore les types d'enregistrement qu'il ne connaît pas, et lève une erreur au lieu de renvoyer une trace vide quand un fichier cesse d'être analysable.
Annotation de récompense de processus
Un modèle de récompense de processus attribue le crédit étape par étape au lieu de ne noter que le résultat final, et process_reward recueille les étiquettes sur lesquelles il s'entraîne. Deux modes arbitrent entre vitesse et détail.
En mode first_error, le mode par défaut, l'annotateur clique sur la première étape où l'agent s'est trompé. Toutes les étapes qui la précèdent sont marquées correctes, et cette étape ainsi que toutes les suivantes sont marquées incorrectes. Un seul clic étiquette toute la trajectoire, et c'est pourquoi c'est le mode à utiliser quand il vous faut du volume.
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent makes a mistake."
    steps_key: structured_turns
    mode: first_error
En mode per_step, chaque étape est jugée pour elle-même. Cela coûte davantage de temps d'annotation et produit le signal que first_error ne peut pas donner, car une cascade suppose qu'une erreur est irrécupérable alors que les vrais agents se rattrapent. Activez allow_neutral avec ce mode et les étiquettes suivent la convention de PRM800K, +1, 0 et -1, où une étape réellement sans effet est enregistrée comme neutre au lieu d'être forcée vers un pôle :
  - annotation_type: process_reward
    name: step_rewards
    description: "Label each step as correct, neutral, or incorrect."
    steps_key: structured_turns
    step_text_key: content
    mode: per_step
    allow_neutral: true
Ajoutez l'un ou l'autre schéma à la configuration ci-dessus. Avec allow_neutral activé, une étape non marquée reste null, de sorte que l'export distingue un jugement neutre délibéré d'une étape que l'annotateur n'a jamais atteinte. allow_neutral ne s'applique qu'à per_step, et il est toujours désactivé en mode first_error, qui n'a pas de place pour un jugement neutre.
Annotation de revue de code
Le schéma code_review applique la revue de pull request aux productions d'agents. Les annotateurs cliquent sur une ligne du diff pour y attacher un commentaire catégorisé, notent chaque fichier et rendent un verdict :
  - annotation_type: code_review
    name: review
    description: "Review the agent's code changes."
    comment_categories: [bug, style, suggestion, security]
    verdict_options: [approve, request_changes, comment_only]
    file_rating_dimensions: [correctness, quality]
Ajoutez ce schéma à la configuration ci-dessus. Les dimensions de notation des fichiers sont chacune notées de 1 à 5. Les valeurs par défaut conviennent à un travail de revue général, donc remplacez-les quand votre taxonomie est l'objet même de l'étude, par exemple une revue de sécurité où bug et security doivent être des catégories distinctes avec des définitions distinctes dans les consignes.
 Commentaires en ligne sur le diff, notes par fichier et verdict global
Le tutoriel de revue de code détaille une étude de revue complète, y compris la façon dont les catégories de commentaires orientent ce que remarquent les annotateurs. Menez cette étude sur une poignée de traces avant de passer à l'échelle, car une liste de catégories qui semblait complète dans la configuration gagne généralement une entrée de plus après les vingt premières revues.
Une configuration complète
Cette configuration affiche les traces et recueille un verdict au niveau de la tâche, des récompenses de processus en mode première erreur et une revue de code, avec trois annotateurs par trace pour pouvoir mesurer l'accord :
annotation_task_name: "Coding Agent Trace Evaluation"
task_description: "Judge whether the agent completed the task and review its changes."

data_files:
  - data/traces.jsonl

item_properties:
  id_key: id
  text_key: task_description

port: 8000
output_annotation_dir: annotation_output/coding-agent-eval/
export_annotation_format: jsonl

instance_display:
  layout:
    direction: vertical
    gap: 16px
  fields:
    - key: task_description
      type: text
      label: "Task"
    - key: structured_turns
      type: coding_trace
      label: "Agent Session"
      display_options:
        show_file_tree: true
        diff_view: unified
        collapse_long_outputs: true
        max_output_lines: 50
        terminal_theme: dark
        show_step_numbers: true

annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: success
        tooltip: "Completed correctly with no issues"
      - name: partial
        tooltip: "Completed with minor issues"
      - name: failure
        tooltip: "Not completed, or completed incorrectly"
    sequential_key_binding: true

  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent makes a mistake."
    steps_key: structured_turns
    mode: first_error

  - annotation_type: code_review
    name: review
    description: "Review the agent's code changes."
    comment_categories: [bug, style, suggestion, security]
    verdict_options: [approve, request_changes, comment_only]
    file_rating_dimensions: [correctness, quality]

  - annotation_type: text
    name: notes
    description: "Anything else worth recording about this trace"
    placeholder: "Optional"

num_annotators_per_item: 3

user_config:
  allow_all_users: false
  users:
    - annotator1
    - annotator2
Installez Potato, convertissez vos traces et démarrez le serveur :
pip install potato-annotation
python -m potato.trace_converter -i ./my_traces.json --auto-detect -o data/traces.jsonl
potato start config.yaml -p 8000
Le dépôt fournit une version fonctionnelle de ce projet dans examples/agent-traces/coding-agent-evaluation/, ce qui est le moyen le plus rapide de voir l'affichage avant de convertir quoi que ce soit de votre côté. Lancez cette configuration, lisez une trace comme le ferait un annotateur, et vous saurez en quelques minutes si la granularité des étapes que vous comptez étiqueter est bien celle que montre l'affichage.
Exporter pour l'entraînement
Les annotations sortent par l'exportateur d'évaluation de code, qui écrit un fichier par type de sortie :
python -m potato.export -c config.yaml -f coding_eval -o exports/ \
--option types=prm,preference,swebench,code_review| Type | Fichier | Ce qu'il alimente |
|---|---|---|
prm | prm_training_data.jsonl | Entraînement de modèles de récompense de processus |
preference | preference_pairs.jsonl | DPO ou RLHF, à partir d'annotations par paires |
swebench | swebench_results.jsonl | Évaluation compatible SWE-bench |
code_review | code_reviews.jsonl | Données de revue structurées |
Le type preference a besoin d'annotations par paires pour se construire, donc une étude qui ne recueille que des récompenses de processus produit les trois autres. Décidez lesquels des quatre vous voulez avant de concevoir les schémas, car ajouter une comparaison par paires après coup oblige à annoter chaque trace une seconde fois face à une autre.
Regarder un agent travailler
Les traces enregistrées ne sont qu'une moitié du tableau. live_coding_agent exécute un agent à l'intérieur de la page d'annotation, où les annotateurs le regardent travailler, interviennent, reviennent en arrière et rejouent avec d'autres instructions, avec un backend Ollama, Anthropic ou Claude SDK dans un répertoire de travail isolé. La documentation de l'agent de coding en direct présente les backends et les modes de sandbox.
Si votre équipe évalue des agents de coding et tombe sur un cas que cette configuration ne couvre pas, ouvrez une issue sur le dépôt GitHub. Un nouveau convertisseur tient à peu près en un fichier dans potato/trace_converter/converters/, donc un format que Potato ne lit pas encore est une contribution à apporter et non un obstacle.