Potato مقابل LangSmith وLangfuse لتقييم الوكلاء: مقارنة عملية
ما الذي بُنيت له كل من LangSmith وLangfuse وPotato في تقييم الوكلاء، وكيف تُنقل التتبعات بينها، وأين يُقاس الحكم البشري.
بُنيت LangSmith وLangfuse لتتبع تطبيقات النماذج اللغوية الكبيرة ومراقبتها في بيئة الإنتاج. أما Potato فقد بُني لجمع أحكام بشرية منظَّمة حول ما تُظهره تلك التتبعات، ولقياس مدى اتفاق من يُصدرون هذه الأحكام. والفرق التي تحتاج إلى الأمرين معاً تلتقط التتبعات عادةً في أداة رصد، ثم تُجري الدراسة البشرية في Potato.
تتقاطع الأدوات الثلاث بما يكفي لأن تتكرر المقارنة بينها، لكنها تتقاطع في نقطة واحدة فقط. فالثلاث قادرة على إرفاق حكم بشري بتشغيل مسجَّل لوكيل. غير أن ما تنتظم حوله كل أداة مختلف، وهذا الاختلاف هو ما يحدد أيها يناسب السؤال الذي تطرحه.
ما الذي بُنيت له كل أداة
تقوم LangSmith بتجهيز تطبيقات النماذج اللغوية الكبيرة وتتبعها وتنقيحها، مع أعمق تكامل مع LangChain وLangGraph. فالتتبعات القادمة من تطبيق مبني على هذين الإطارين تصل دون تجهيز إضافي، والمنصة منتظمة حول فحص التشغيلات، وتتبع زمن الاستجابة والتكلفة، وإجراء تجارب تقييم على مجموعات البيانات. وتدعم طوابير التعليق فيها مفاتيح ملاحظات مبنية على معايير تقييم، وعدداً قابلاً للتهيئة من المراجعين لكل تشغيل، وطوابير للمقارنة الزوجية، ومراجعين لا يرى أحدهم ملاحظات الآخرين.
وتغطي Langfuse المجال نفسه بوصفها أداة مفتوحة المصدر، لأي تطبيق يعتمد على النماذج اللغوية الكبيرة لا لإطار عمل واحد، وتجمع إدارة التوجيهات مع التتبع. والتقييم بالدرجات متاح على مستوى التتبع وعلى مستوى الملاحظة (span)، وتتيح إعدادات الدرجات الفئوية فيها (score configs) تعريف مجموعة ثابتة من الوسوم وإرفاق عدة درجات مسمّاة بالـ span نفسه.
أما Potato فهو منصة تعليق توضيحي جرى توسيعها لتشمل تتبعات الوكلاء. وهو منتظم حول الدراسة لا حول التطبيق، ولذلك فإن لبناته الأساسية هي من يعلّق على ماذا، وكم شخصاً يرى كل عنصر، وما الذي يحدث حين يختلفون، وما الذي تقوله إحصاءات الاتفاق عن كون الوسوم تعني شيئاً أصلاً. وتتبعات الوكلاء نوع واحد من العناصر ضمن 61 نوعاً من أنواع التعليق التي يسجّلها الإصدار الحالي، ولهذا ترث الاتفاق بين المعلّقين ومراحل التدريب والتحكيم والتعهيد الجماعي دون أن يُعاد بناء أي من ذلك من أجل الوكلاء.
لا توجد بين الثلاث أداة أفضل من غيرها بصورة مجردة. والسؤال المفيد هو ما إذا كان عنق الزجاجة لديك هو رؤية ما فعله الوكيل، أم الثقة بالوسوم البشرية التي تجمعها عنه.
نقل التتبعات بينها
يقرأ Potato التتبعات بعد وقوعها بدلاً من تجهيز شيفرتك، ولذلك يسجّل محوّلات لـ 15 صيغة من صيغ التتبع:
python -m potato.trace_converter --list-formatsتشمل القائمة react وopenai وanthropic وlangchain وlangfuse وmulti_agent وmcp وotel وatif وwebarena وweb_agent وswebench وswe_agent_trajectory وclaude_code وaider. وتمر صادرات تشغيلات LangSmith عبر المحوّل langchain، إذ لا يوجد محوّل langsmith مستقل. وتمر سجلات CrewAI وAutoGen وLangGraph عبر multi_agent.
وتحويل ملف مُصدَّر أمر واحد في كل اتجاه من اتجاهات سير العمل:
# LangSmith runs, exported from LangSmith, converted for annotation
python -m potato.trace_converter \
  --input langsmith_export.jsonl \
  --output data/traces.jsonl \
  --input-format langchain

# Langfuse traces, exported from Langfuse
python -m potato.trace_converter \
  --input langfuse_traces.json \
  --output data/traces.jsonl \
  --input-format langfuse
إذا لم يكن إطار العمل الذي تستخدمه في القائمة، فإن --auto-detect يختار محوّلاً بناءً على بصمات الحقول، والمحوّل الجديد هو صنف فرعي من BaseTraceConverter. ويأخذ الاكتشاف أول محوّل يطابق، لذا سمِّ الصيغة صراحةً حين تعرف أيها يناسب ملفاتك.
ويمكن أن تصل التتبعات أيضاً دون خطوة تصدير. إذ تقبل خاصية استيعاب التتبعات في Potato التشغيلات المرسلة إلى /api/traces/* بصيغة حمولة تشغيلات LangSmith، فيستطيع رد نداء (callback) في LangChain أو SDK التتبع دفع التشغيلات إلى طابور التعليق أثناء حدوثها:
trace_ingestion:
  enabled: true
  api_key: "your-api-key"
  notify_annotators: true
ما يضيفه Potato بعد دخول التتبع
المخططات هي الموضع الذي تثبت فيه منصة التعليق جدارتها. فالمخطط trajectory_eval يحمل وسم الصحة، وتصنيفاً هرمياً للأخطاء بأنواع فرعية، ومستويات خطورة بأوزان قابلة للتهيئة، ودرجة جودة تراكمية، وكل ذلك في مخطط واحد مرفق بتتبع واحد:
annotation_schemes:
  - annotation_type: trajectory_eval
    name: step_evaluation
    description: "Mark each step and classify anything that went wrong"
    steps_key: conversation
    step_text_key: text
    error_types:
      - name: execution
        subtypes: [wrong_tool, wrong_args, api_error]
    severities:
      - name: minor
        weight: -1
      - name: critical
        weight: -10
    show_score: true
أوزان الخطورة هي الجزء المهم عند المقارنة بين التتبعات. فالعدّ البسيط للخطوات المعلَّمة يقول إن وكيلاً ارتكب أربعة أخطاء وإن آخر ارتكب خطأين، أما الدرجة الموزونة فتقول ما إذا كانت الأربعة شكلية والاثنان خطيرين.
ويجري التقييم المقارن عبر المخطط pairwise، وله ثلاثة أوضاع. يعرض الوضع الثنائي بلاطتين قابلتين للنقر مع زر اختياري للتعادل، ويستبدل وضع المقياس الاختيار بمنزلق بين العنصرين، أما وضع multi_dimension فيطلب حكماً مستقلاً بين A وB لكل بُعد مسمّى، مثل الفائدة والدقة والأمان.
ولوكلاء البرمجة عرض خاص بهم، لأن الـ diff الموحّد حين يُقرأ كسلسلة JSON لا يمكن مراجعته:
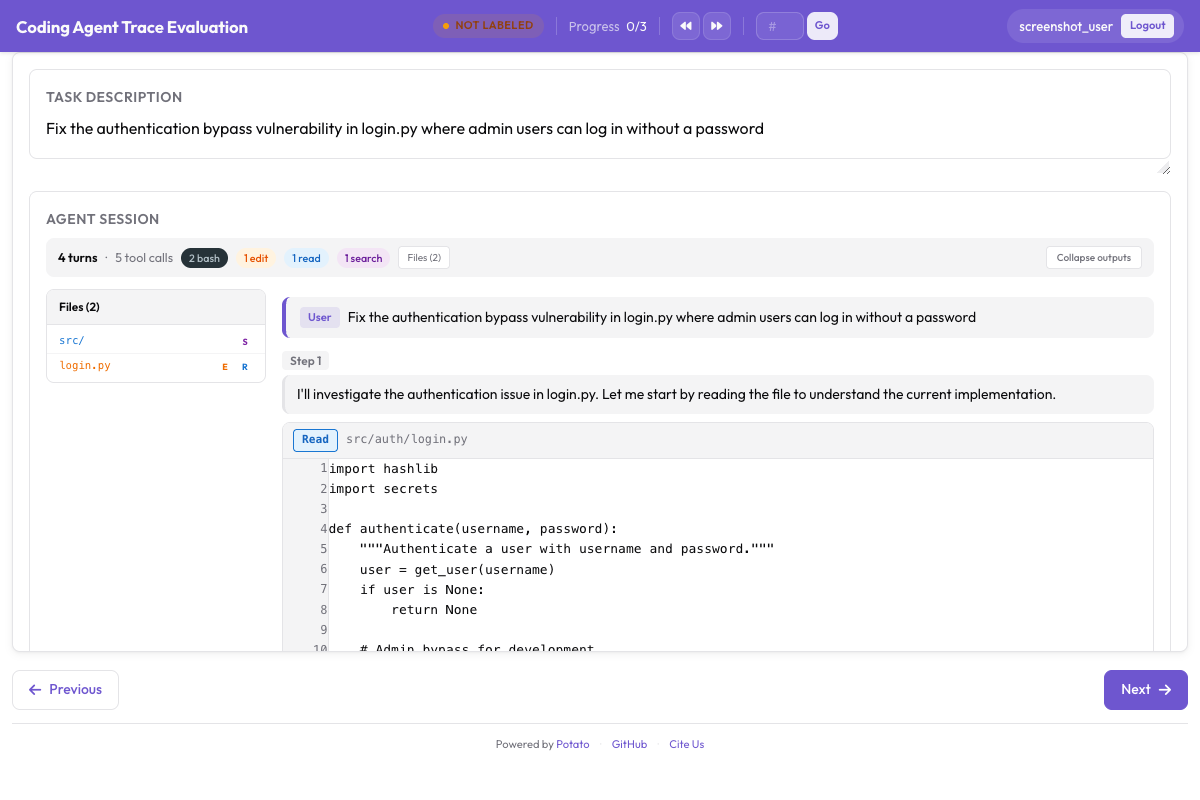 عرض تتبعات البرمجة في Potato مع تصيير diff موحّد وإبراز صياغي وشجرة ملفات
يصيّر العرض coding_trace الفروقات مع شجرة ملفات، ويطوي مخرجات الطرفية الطويلة، ويجمع المخطط code_review تعليقات مثبتة على الأسطر ضمن فئات قابلة للتهيئة، وأبعاد تقييم لكل ملف، وحكماً على طريقة طلب السحب (pull request). ثم يكتب المُصدِّر coding_eval وسوماً لنماذج مكافأة العملية، وتعليقات مراجعة الشيفرة، وأزواج تفضيل لـ DPO، ودرجات متوافقة مع SWE-bench، وهذا هو الشكل الذي تحتاجه بيانات التدريب لا الشكل الذي تحتاجه لوحة معلومات.
وتُعرض تتبعات وكلاء الويب على هيئة لقطات شاشة مع طبقات SVG للإجراءات وشريط صور:
 عارض تتبعات وكلاء الويب يعرض لقطات شاشة مع طبقات SVG للإجراءات وتصفحاً بشريط الصور
ولتشغيلات الوكلاء المتعددين واجهات تعليق خاصة بها بدلاً من تسطيحها في تيار واحد من الخطوات. إذ يضم السجل مخططات لرسم بياني للتفاعل يستطيع المعلّق تعديله، ولإسناد الإخفاق عبر الوكلاء، ولمراجعة تسليم المهام، ولبطاقات أداء لكل وكيل ولكل فريق، وللتنازع على الأدوات عبر خط زمني مشترك، ولوسم السلوك الناشئ. والأمر نفسه ينطبق على الوكلاء المتجسدين والوكلاء متعددي الوسائط، إذ تُعد مسارات استخدام الحاسوب، والتفاعل الصوتي ثنائي الاتجاه الكامل، والتأريض الزمني في الفيديو مخططات قائمة بذاتها.
قياس الأحكام لا جمعها فحسب
الفرق الذي يظهر متأخراً في أي مشروع هو ما يحدث بعد أن يختلف معلّقان. يعامل Potato الخلاف بوصفه قياساً لا نزاعاً يجب حسمه، ولذلك فإن إحصاءات الاتفاق وطابور التحكيم ومراحل التدريب وعناصر المرجع الذهبي نفسها التي تستخدمها دراسة تعليق نصي تنطبق على تتبعات الوكلاء دون تهيئة إضافية. وتسجّل مقارنة الأدوات الخاصة بـ Potato، وفق مراجعة 2026-06-24، أن منصات التتبع مبنية لجمع الأحكام البشرية على هيئة درجات، وأن أياً منها لا يوثّق إحصاءً للموثوقية على تلك الأحكام، وأن Langfuse يستبدل أي تعليق سابق على التتبع نفسه، فيحتاج التعليق المزدوج المستقل هناك إلى حل التفافي.
وهذا مهم حين يكون التقييم هو الدليل. فمعدل النجاح المبني على أحكام مفردة غير مراجَعة ليس له هامش خطأ، والمراجع الذي انحرف يبدو تماماً مثل وكيل تحسّن.
مراقبة الوكيل أثناء تشغيله
يستطيع Potato أيضاً تشغيل وكيل داخل صفحة التعليق بدلاً من إعادة عرض تسجيل. إذ تربط الكتلة live_agent نموذج رؤية بمتصفح دون واجهة (headless) وتبث الجلسة إلى المعلّق، الذي يستطيع إيقافها مؤقتاً أو إرسال تعليمات أو تولي التحكم اليدوي:
live_agent:
  endpoint_type: anthropic_vision
  ai_config:
    model: claude-sonnet-4-20250514
    api_key: ${ANTHROPIC_API_KEY}
  max_steps: 30
  allow_takeover: true
  allow_instructions: true

instance_display:
  fields:
    - key: agent_trace
      type: live_agent
      label: "Live Agent Session"
      display_options:
        show_overlays: true
        show_filmstrip: true
ثلاث حالات تجعل هذا يستحق عناء الإعداد مقارنةً بالمراجعة اللاحقة. فإيقاف التشغيل قبل إجراء مدمّر إجراء أمان لا تستطيع التتبعات المسجلة توفيره. وتولّي الإنسان للتحكم في منتصف التشغيل يصبح، حين يُسجَّل، بيانات إيضاحية. ومراقبة كيف يتعافى وكيل من تدخل ما تجيب عن سؤال لا يحتويه أي تتبع مكتمل.
تشغيلها معاً
الإعداد الشائع في بيئة الإنتاج يستخدم الاثنين، والتقسيم واضح لأن الأدوات تريد أشياء مختلفة. جهّز الوكيل باستخدام LangSmith أو Langfuse ودع كل تشغيل يُتتبَّع. خذ عينة من التشغيلات التي تستحق رأياً بشرياً، وهي عادةً الإخفاقات والحالات الحدّية وعينة ضابطة عشوائية. حوّلها إلى Potato، وأجرِ دراسة التعليق بعدة معلّقين لكل تتبع، واقرأ تقرير الاتفاق إلى جانب الدرجات. ثم أعِد أعداد تصنيف الأخطاء إلى فريق التطوير، حيث يكشف توزيع الأنواع الفرعية ما إذا كان لديك إخفاق منهجي واحد أم ذيل طويل.
python -m potato.trace_converter \
  --input langfuse_failed_traces.json \
  --output data/traces_to_review.jsonl \
  --input-format langfuse

potato start config.yaml -p 8000
الاختيار
اختر LangSmith حين يكون التطبيق مبنياً على LangChain أو LangGraph وتكون الحاجة هي الرؤية في بيئة الإنتاج، لأن التتبعات تصل دون أي عمل تجهيز، والخدمة المُدارة تحسم مسألة البنية التحتية. واختر Langfuse حين تريد الرؤية نفسها في أداة مفتوحة المصدر عبر عدة مزودين، مع إدارة إصدارات التوجيهات في الأداة نفسها. واختر Potato حين يكون الناتج الذي تحتاجه مجموعة من الوسوم البشرية يمكن الدفاع عنها، أو حين تحتاج الدراسة إلى عدة معلّقين لكل عنصر وإلى رقم للاتفاق، أو حين يكون الوكلاء وكلاء برمجة أو وكلاء متعددين أو متجسدين إلى حد يحتاج معه التتبع إلى عرض مصمم له خصيصاً، أو حين يجب أن تبقى البيانات على بنيتك التحتية الخاصة. ويُرخَّص Potato بموجب GPL-3.0-or-later ويُستضاف ذاتياً، دون تكلفة لكل مقعد أو لكل تتبع.
تعكس العبارات الواردة هنا عن LangSmith وLangfuse توثيقهما كما رُوجع في 2026-06-24، وكلتاهما تطرح تحديثات بسرعة. والتصحيحات مرحّب بها في مستودع GitHub. وللإعداد نفسه، راجع دليل تقييم الوكلاء، ولمثال كامل يبدأ من التتبعات الخام وينتهي بالأحكام المُصدَّرة، راجع تقييم وكلاء الذكاء الاصطناعي.