Ревью кода ИИ-агентов в стиле пул-реквестов GitHub
Настройка разметки ревью кода в стиле пул-реквестов GitHub в Potato: комментарии прямо в диффе, оценки качества по файлам и вердикты о принятии или отклонении вывода кодового агента.
Доля прошедших тестов и качество кода
Большинство бенчмарков для кодовых агентов сводит оценку к двоичному вопросу: прошли тесты или нет? SWE-bench показывает процент решённых задач. HumanEval показывает pass@k. Для таблиц лидеров эти метрики полезны, а для понимания качества кода бесполезны.
Агент может пройти все тесты и всё равно написать код, который никто не захочет поддерживать: с дырой в безопасности, с медленным путём или в стиле, воюющем с остальной кодовой базой. Живой ревьюер вернул бы такой пул-реквест на доработку, даже если тесты зелёные. Если вам нужны агенты, чей код люди действительно вливают, надо разбирать код, а не только гонять тесты.
Схема разметки code_review в Potato приносит опыт разбора пул-реквестов GitHub в инструмент разметки. Разметчик видит единые диффы с подсветкой синтаксиса, кликает по строкам диффа, добавляя комментарии, оценивает файлы по паре измерений качества и выносит вердикт «принять», «вернуть на доработку» или «только комментарий» — ровно как при разборе настоящего пул-реквеста. Полный справочник по схеме — в документации по разметке кодовых агентов и в руководстве по оценке агентов.
Вот интерфейс ревью кода в Potato с комментариями в диффе и оценками файлов:
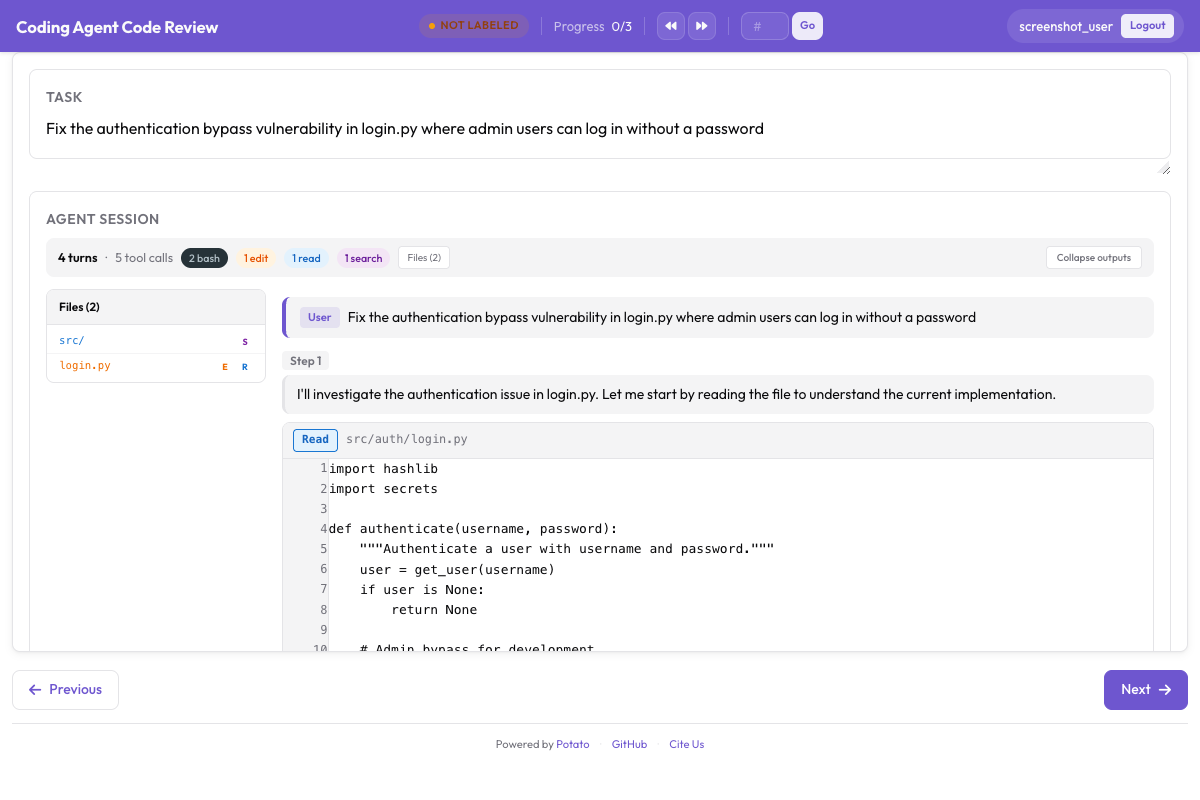 Potato's code review interface with inline diff comments and file-level quality ratings
Обзор схемы ревью кода
У схемы code_review три слоя:
- Комментарии в диффе: разметчик кликает по любой строке диффа и прикрепляет комментарий с категорией (ошибка, стиль, производительность, безопасность, логика, предложение, вопрос)
- Оценки по файлам: каждый изменённый файл получает независимые оценки корректности (1–5) и качества кода (1–5)
- Итоговый вердикт: разметчик выносит финальное решение — принять, вернуть на доработку или только прокомментировать
Процесс повторяет настоящий разбор кода, а структурный вывод ложится на обучение моделей ревью кода.
CodingTraceDisplay: как рисуются диффы
Компонент CodingTraceDisplay рисует трассы кодовых агентов как последовательность вызовов инструментов и их выводов, с особой обработкой правок файлов. Когда агент правит файл, выводится единый дифф, где есть:
- Красные строки: удалённые строки (с префиксом
-) - Зелёные строки: добавленные строки (с префиксом
+) - Серые строки: строки контекста (без изменений)
- Номера строк: и старые, и новые номера на полях
- Подсветка синтаксиса: с учётом языка, определяемого по расширению файла
- Клик для комментария: клик по любой строке открывает форму комментария, привязанную к ней
Дифф вычисляется автоматически из операций правки агента. Если агент использовал инструмент поиска и замены, Potato восстанавливает состояния «до» и «после» и формирует единый дифф.
Для агентов, которые за одну трассу правят несколько файлов (обычное дело для настоящих исправлений ошибок), у каждого файла своя сворачиваемая секция диффа, как на вкладке «Files changed» пул-реквеста GitHub.
CodingTraceDisplay рисует изменения кода с нормальной подсветкой синтаксиса:
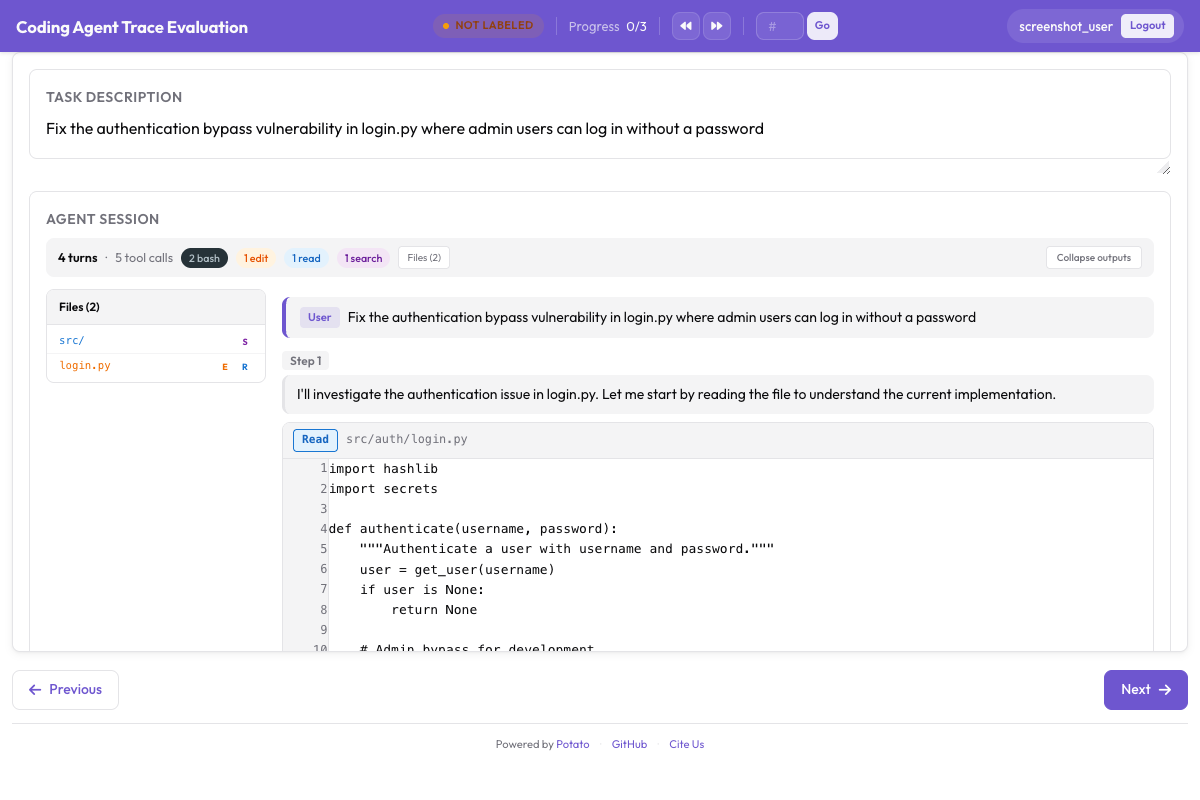 CodingTraceDisplay rendering unified diffs with syntax highlighting and a file tree sidebar
Категории комментариев
Кликнув по строке диффа, чтобы добавить комментарий, разметчик выбирает категорию:
| Категория | Цвет | Описание | Пример |
|---|---|---|---|
bug | Красный | В коде функциональная ошибка | «This will throw a NullPointerException if user is None» |
style | Синий | Проблема стиля или соглашений | «Project uses snake_case for functions, not camelCase» |
performance | Оранжевый | Неэффективный код | «This queries the database inside a loop; use a batch query» |
security | Фиолетовый | Уязвимость | «User input is passed directly to SQL query without sanitization» |
logic | Жёлтый | Проблема логики, которая может не приводить к немедленному сбою | «This condition should be >= not >, off-by-one on boundary» |
suggestion | Зелёный | Предложение по улучшению, не ошибка | «Consider using a context manager here for cleaner resource handling» |
question | Серый | Нужно уточнение | «Why was this import added? It does not appear to be used» |
У каждого комментария есть и свободное текстовое поле, где разметчик подробно объясняет проблему, — как при написании настоящего комментария к пул-реквесту.
Оценки по файлам
Разобрав дифф каждого файла, разметчик оценивает его по двум измерениям:
Корректность (1–5):
- 1: не работает, добавляет новые ошибки
- 2: работает частично, есть существенные проблемы
- 3: работает на основном сценарии, но упускает краевые случаи
- 4: работает верно, есть мелкие замечания
- 5: полностью верно, краевые случаи обработаны как надо
Качество кода (1–5):
- 1: неподдерживаемо, структуры нет
- 2:низкое качество, серьёзные проблемы стиля и устройства
- 3: приемлемо, базовые соглашения соблюдены
- 4: хорошее качество, чисто и читаемо
- 5: отлично, идиоматично, документировано
Варианты вердикта
Разобрав все файлы, разметчик выбирает один из трёх вердиктов:
- Принять: код готов к вливанию как есть или с косметическими правками
- Вернуть на доработку: перед вливанием коду нужны существенные изменения
- Только комментарий: даётся обратная связь без решения о вливании
Это напрямую соответствует трём состояниям разбора пул-реквеста на GitHub.
Пошаговая настройка
Шаг 1: сконвертируйте трассы кодового агента
Трассы кодовых агентов приходят в разных форматах. Вот примеры для трёх популярных агентов.
Из Claude Code (выгрузка JSON):
python -m potato.trace_converter \
  --input claude_code_sessions/ \
  --output data/code_traces.jsonl \
  --input-format claude_code
Из Aider (история чата):
python -m potato.trace_converter \
  --input aider_logs/ \
  --output data/code_traces.jsonl \
  --input-format aider
Из SWE-Agent (каталог траекторий):
python -m potato.trace_converter \
  --input swe_agent_trajectories/ \
  --output data/code_traces.jsonl \
  --input-format swe_agent_trajectory
Конвертер выдаёт стандартизованный формат JSONL. Каждая строка содержит трассу с задачей, шагами агента и диффами файлов:
{
  "trace_id": "swe_bench_123",
  "task": "Fix the TypeError in django/db/models/query.py when calling .values() on an empty QuerySet",
  "repo": "django/django",
  "base_commit": "a1b2c3d",
  "steps": [
    {
      "type": "thought",
      "content": "Let me look at the QuerySet.values() method to understand the TypeError."
    },
    {
      "type": "action",
      "tool": "search",
      "input": "def values",
      "file": "django/db/models/query.py"
    },
    {
      "type": "observation",
      "content": "Found at line 234: def values(self, *fields):\n    ..."
    },
    {
      "type": "action",
      "tool": "edit",
      "file": "django/db/models/query.py",
      "old_content": "    def values(self, *fields):\n        clone = self._clone()\n        clone.query.set_values(fields)",
      "new_content": "    def values(self, *fields):\n        clone = self._clone()\n        if not fields and not self.query.values_select:\n            return clone\n        clone.query.set_values(fields)"
    },
    {
      "type": "action",
      "tool": "edit",
      "file": "tests/queries/test_values.py",
      "old_content": "class ValuesTests(TestCase):",
      "new_content": "class ValuesTests(TestCase):\n    def test_empty_queryset_values(self):\n        \"\"\"Calling .values() on empty QuerySet should not raise TypeError.\"\"\"\n        qs = Author.objects.none()\n        result = list(qs.values())\n        self.assertEqual(result, [])"
    }
  ],
  "files_changed": [
    {
      "path": "django/db/models/query.py",
      "diff": "--- a/django/db/models/query.py\n+++ b/django/db/models/query.py\n@@ -234,6 +234,8 @@\n     def values(self, *fields):\n         clone = self._clone()\n+        if not fields and not self.query.values_select:\n+            return clone\n         clone.query.set_values(fields)"
    },
    {
      "path": "tests/queries/test_values.py",
      "diff": "--- a/tests/queries/test_values.py\n+++ b/tests/queries/test_values.py\n@@ -1,4 +1,10 @@\n class ValuesTests(TestCase):\n+    def test_empty_queryset_values(self):\n+        \"\"\"Calling .values() on empty QuerySet should not raise TypeError.\"\"\"\n+        qs = Author.objects.none()\n+        result = list(qs.values())\n+        self.assertEqual(result, [])"
    }
  ]
}
Шаг 2: настройте схему ревью кода
Создайте свой config.yaml:
annotation_task_name: "Coding Agent Code Review"

data_files:
  - "data/code_traces.jsonl"

item_properties:
  id_key: "trace_id"
  text_key: "task"

# Display coding agent traces with diff rendering
display:
  type: "coding_trace"
  trace_key: "steps"
  diff_key: "files_changed"
  syntax_highlighting: true
  show_line_numbers: true
  collapse_large_diffs: true
  max_uncollapsed_lines: 200

annotation_schemes:
  - annotation_type: "code_review"

    # Inline comment categories

    # File-level ratings

    # Overall verdict

# Annotator settings
annotator_config:
  allow_back_navigation: true

# Output settings
output:
  path: "output/"
  format: "jsonl"
Шаг 3: запустите сервер разметки
potato start config.yaml -p 8000Перейдите на http://localhost:8000. Вы увидите первую трассу кодового агента с описанием задачи, шагами рассуждений агента и диффами файлов с подсветкой синтаксиса.
Шаг 4: порядок работы разметчика
Вот типичный ход разбора:
- Прочитайте задачу: поймите, что агента просили сделать (например, «Fix the TypeError in django/db/models/query.py»)
- Просмотрите трассу: пролистайте шаги рассуждений агента, чтобы понять его подход
- Разберите дифф каждого файла:
- Прочитайте дифф с подсветкой синтаксиса
- Кликните по любой строке, чтобы добавить комментарий
- Выберите категорию комментария (ошибка, стиль, производительность и т. д.)
- Напишите текст комментария с объяснением проблемы
- Оцените файл по корректности (1–5) и качеству кода (1–5)
- Вынесите вердикт: выберите «принять», «вернуть на доработку» или «только комментарий»
- Отправьте: нажмите «Submit» или Ctrl+Enter
Горячие клавиши ускоряют работу:
| Сочетание | Действие |
|---|---|
j / k | Переход между файлами |
c | Открыть комментарий к выбранной строке |
1-5 | Выставить оценку по текущему измерению |
a | Вердикт «принять» |
r | Вердикт «вернуть на доработку» |
Ctrl+Enter | Отправить разбор |
Формат экспорта
Каждый отправленный разбор даёт структурный объект JSON:
{
  "trace_id": "swe_bench_123",
  "annotator": "reviewer_01",
  "timestamp": "2026-03-22T14:32:11Z",
  "review": {
    "inline_comments": [
      {
        "file": "django/db/models/query.py",
        "line": 236,
        "side": "right",
        "category": "logic",
        "body": "This early return skips set_values entirely, but if fields are provided later via .values('name'), the previous empty .values() call will have returned a clone that never went through set_values. Consider checking if this clone is still valid downstream."
      },
      {
        "file": "tests/queries/test_values.py",
        "line": 5,
        "side": "right",
        "category": "suggestion",
        "body": "Consider adding a test case for .values() followed by .values('name') to verify the chaining behavior after your fix."
      }
    ],
    "file_ratings": [
      {
        "file": "django/db/models/query.py",
        "correctness": 3,
        "code_quality": 4
      },
      {
        "file": "tests/queries/test_values.py",
        "correctness": 4,
        "code_quality": 4
      }
    ],
    "verdict": "request_changes"
  }
}
Этот структурный формат напрямую годится и для обучения моделей ревью кода, и для сводного разбора.
Разбор: как работать с данными ревью
Загрузка разборов
import json
import pandas as pd
from pathlib import Path

reviews = []
for f in Path("output/").glob("*.jsonl"):
    with open(f) as fh:
        for line in fh:
            reviews.append(json.loads(line))

print(f"Loaded {len(reviews)} code reviews")
Распределение категорий комментариев
from collections import Counter

all_comments = []
for rev in reviews:
    for comment in rev["review"]["inline_comments"]:
        all_comments.append(comment)

category_counts = Counter(c["category"] for c in all_comments)
print("Comment categories:")
for cat, count in category_counts.most_common():
    print(f"  {cat}: {count}")
Средние оценки файлов
ratings = []
for rev in reviews:
    for fr in rev["review"]["file_ratings"]:
        ratings.append(fr)

ratings_df = pd.DataFrame(ratings)
print("Average ratings by file:")
print(
    ratings_df.groupby("file")[["correctness", "code_quality"]]
    .mean()
    .round(2)
    .to_string()
)
Распределение вердиктов
verdict_counts = Counter(rev["review"]["verdict"] for rev in reviews)
total = sum(verdict_counts.values())
print("Verdict distribution:")
for verdict, count in verdict_counts.most_common():
    print(f"  {verdict}: {count} ({count/total*100:.1f}%)")
Доля ошибок по агентам
Если в ваших трассах есть поле agent, можно сравнить долю ошибок между агентами:
agent_bugs = {}
for rev in reviews:
    agent = rev.get("agent", "unknown")
    bug_count = sum(
        1 for c in rev["review"]["inline_comments"]
        if c["category"] == "bug"
    )
    if agent not in agent_bugs:
        agent_bugs[agent] = []
    agent_bugs[agent].append(bug_count)

print("Average bugs per review by agent:")
for agent, bugs in sorted(agent_bugs.items()):
    print(f"  {agent}: {sum(bugs)/len(bugs):.2f} (n={len(bugs)})")
Сценарии применения
Обучение моделей ревью кода
Структурные комментарии в строках, оценки файлов и вердикты из разметки ревью кода в Potato — отличные обучающие данные для автоматических моделей разбора кода. Каждый разбор даёт:
- Локализованную обратную связь, привязанную к конкретным строкам диффа
- Проблемы с категориями (ошибка против стиля против производительности)
- Сигналы качества на нескольких уровнях (строка, файл, целиком)
Это те же по форме данные, с которыми работает автоматический ревьюер вроде CodeRabbit или Graphite, только написанные экспертами-людьми, а не выжатые из LLM.
Оценка кодовых агентов на SWE-bench
SWE-bench говорит, решил ли агент задачу (тесты прошли), но не говорит, можно ли влить этот код. Прогнав разметку ревью кода по решениям SWE-bench, вы отделите агентов, которые решают задачи чистым кодом, от агентов, которые решают их костылями. Итоговое ранжирование отражает, вливаем ли код, а не только позеленели ли тесты.
Сбор датасетов о качестве кода
Собирайте данные разбора кода по многим трассам, чтобы построить датасеты типичных проблем качества в коде, написанном ИИ. Такие датасеты годятся для:
- Дообучения моделей генерации кода, чтобы избегать частых ошибок
- Построения линтеров под специфические шаблоны кода от ИИ
- Обучения классификаторов, помечающих вероятные проблемы в выводе агента до человеческого разбора
Итог
Схема code_review в Potato помещает процесс разбора пул-реквестов GitHub внутрь оценки агентов. Комментарии в строках, оценки файлов и вердикты дают структурные данные о качестве кода: чтобы обучить на них модель ревью кода, чтобы отделить чистые решения SWE-bench от костыльных или чтобы задать своему агенту базовый уровень качества.