Разметка кодовых агентов: оценка трасс Claude Code, Aider и SWE-Agent
Potato отрисовывает трассы кодовых агентов как диффы и терминальные блоки, со схемами процессного вознаграждения и ревью кода и конвертерами для Claude Code, Aider и SWE-Agent.
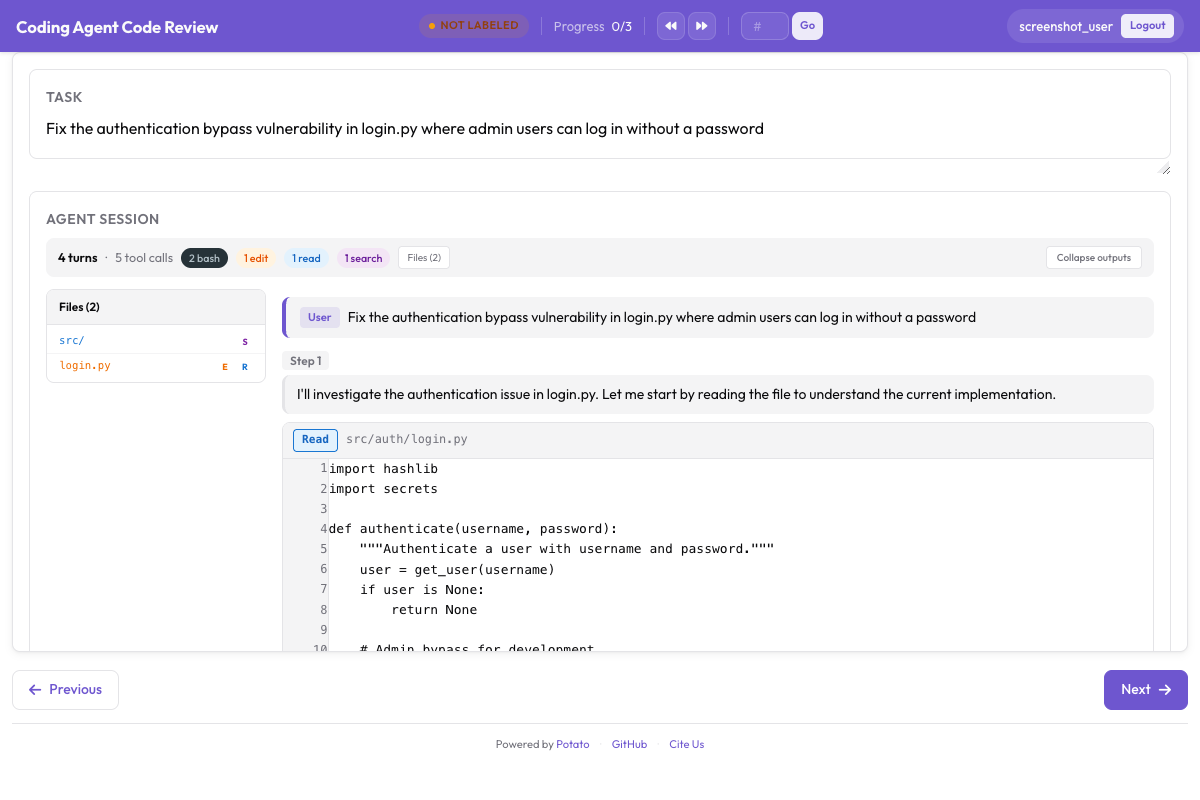
Теперь Potato размечает сессии кодовых агентов напрямую. Трасса отрисовывается как единые диффы, тёмные терминальные блоки, чтение файлов с номерами строк и дерево всех файлов, которые затронул агент. К этому добавляются три конвертера для форматов кодовых агентов (claude_code, aider и swe_agent_trajectory) в дополнение к двенадцати другим форматам трасс, которые Potato уже читает, и две схемы разметки, сделанные под эти данные: process_reward для правильности на уровне шагов и code_review для ревью диффов в стиле GitHub.
Запуск кодового агента представляет собой длинную траекторию из чтения файлов, правок, команд в терминале и рассуждений. Обычный текстовый интерфейс разметки сплющивает всё это в стену символов, поэтому команды, оценивающие агентов, как правило, писали собственный интерфейс ревью и в итоге получали датасеты, которыми больше никто не может пользоваться. Полный справочник есть в документации по разметке кодовых агентов и в руководстве по оценке агентов.
Две вещи, которые стоит проверить до планирования исследования
Транскрипты Claude Code не содержат текста размышлений модели. Файлы сохраняют блок thinking и его подпись, а содержимое отбрасывают. Мы проверили 6393 блока в 40 локальных сессиях, и ни в одном из них не было текста. Сконвертированная трасса сообщает их число, чтобы пробел был виден, а не оставался незамеченным. Если разметчикам нужны рассуждения, чтобы оценивать шаги, записывайте их вживую через claude -p --output-format stream-json или Agent SDK, а не считывайте потом с диска.
В транскриптах также есть абсолютные пути, имена веток, сведения об окружении и весь исходный код, который прочитала сессия. Перед тем как делиться датасетом, удалите или замаскируйте эти данные и получите согласие тех, чьи это сессии.
Отображение трассы
Кодовые трассы отрисовываются через тип отображения coding_trace, который объявляется в instance_display рядом со всем остальным, что должен видеть разметчик. Potato отделяет то, что показывается, от того, что спрашивается, поэтому одно и то же отображение трассы работает с любой схемой разметки:
instance_display:
  layout:
    direction: vertical
    gap: 16px
  fields:
    - key: task_description
      type: text
      label: "Task"
    - key: structured_turns
      type: coding_trace
      label: "Agent Session"
      display_options:
        show_file_tree: true
        diff_view: unified
        collapse_long_outputs: true
        max_output_lines: 50
        terminal_theme: dark
        show_step_numbers: true
        show_reasoning: true
Каждый вызов инструмента отрисовывается в зависимости от того, что сделал инструмент, поэтому разметчик читает дифф как дифф, а не как экранированный текст:
| Инструмент | Отрисовка |
|---|---|
Read | Блок кода с номерами строк |
Edit, Replace | Единый дифф с красными и зелёными строками |
Write, Create | Блок кода нового файла, целиком зелёный |
Bash, Terminal, Shell | Тёмный терминальный блок с приглашением $ |
Grep, Glob, Search, Find | Блок кода с результатами поиска |
| Всё остальное | Вход и выход в формате JSON |
 Кодовая трасса с едиными диффами, выводом терминала и боковой панелью с деревом файлов
collapse_long_outputs вместе с max_output_lines: 50 и есть та настройка, от которой зависит, читается ли трасса. Один запуск pytest может напечатать несколько сотен строк, и разметчик, которому приходится пролистывать их на каждом шаге, перестаёт читать шаги.
Формат данных
Формат structured_turns сохраняет структуру вызовов инструментов, которая нужна отображению. Каждый ход содержит роль, текстовое содержимое и список вызовов инструментов:
{
  "id": "session_001",
  "task_description": "Fix the authentication bypass in login.py",
  "model": "claude-sonnet-4-20250514",
  "structured_turns": [
    {
      "role": "assistant",
      "content": "I'll investigate the auth issue.",
      "tool_calls": [
        {
          "tool": "Read",
          "input": {"file_path": "src/auth/login.py"},
          "output": "def login(user, password):\n    if user.role == 'admin':\n        return True",
          "output_type": "code",
          "language": "python"
        },
        {
          "tool": "Bash",
          "input": {"command": "pytest tests/test_auth.py -v"},
          "output": "4 passed",
          "output_type": "terminal"
        }
      ]
    }
  ]
}
output_type принимает значения code, diff, terminal или generic, и если его не указать, Potato выводит его из инструмента и расширения файла. Задавайте его явно, когда вывод инструмента не соответствует тому, что подсказывает его имя.
Конвертация уже имеющихся трасс
Конвертер читает один формат и записывает JSONL, который загружает Potato. Три его формата относятся к кодовым агентам:
# Claude Code, or any Anthropic Messages API transcript
python -m potato.trace_converter -i traces.json -f claude_code -o data/traces.jsonl

# Aider chat history with SEARCH/REPLACE blocks
python -m potato.trace_converter -i chat.md -f aider -o data/traces.jsonl

# SWE-Agent trajectories
python -m potato.trace_converter -i trajectory.json -f swe_agent_trajectory -o data/traces.jsonl

# Mixed directory, format detected per file
python -m potato.trace_converter -i traces.json --auto-detect -o data/traces.jsonl
Конвертер claude_code читает как собственные транскрипты сессий Claude Code, так и сырую форму Messages API. Claude Code пишет по одному файлу JSONL на сессию в ~/.claude/projects/<slugified-working-directory>/<session-id>.jsonl, и конвертер превращает одну сессию в одну трассу, а не в трассу на каждую строку:
python -m potato.trace_converter \
  -i ~/.claude/projects/-home-me-myrepo/3c853f0f-....jsonl \
  --auto-detect -o data/session.jsonl
Он идёт по цепочке parentUuid и сохраняет только уцелевший путь, так что отмотанные попытки отбрасываются и подсчитываются, а не размечаются так, будто они произошли. Сообщения из побочных цепочек (sidechain) попадают в sidechain_runs, вне основных ходов. Слеш-команды отбрасываются, поскольку в них CLI разговаривает сам с собой. Формат на диске принадлежит CLI, а не опубликованному API, поэтому считайте, что чтение между обновлениями работает по принципу best effort. Незнакомые типы записей он игнорирует, а когда файл перестаёт разбираться, выбрасывает ошибку вместо того, чтобы вернуть пустую трассу.
Разметка процессного вознаграждения
Модель процессного вознаграждения распределяет заслуги по шагам, а не оценивает только итоговый результат, и process_reward собирает метки, на которых она обучается. Два режима по-разному балансируют скорость и детальность.
В режиме first_error, который используется по умолчанию, разметчик кликает по первому шагу, где агент ошибся. Каждый шаг до него помечается верным, а этот шаг и всё после него помечаются неверными. Один клик размечает всю траекторию, поэтому этот режим подходит, когда нужен объём.
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent makes a mistake."
    steps_key: structured_turns
    mode: first_error
В режиме per_step каждый шаг оценивается отдельно. Это требует больше времени разметчиков и даёт сигнал, которого first_error дать не может, потому что каскад предполагает, что ошибка непоправима, а настоящие агенты исправляются. Включите вместе с ним allow_neutral, и метки будут следовать соглашению PRM800K с +1, 0 и -1, где действительно безвредный шаг записывается как нейтральный, а не притягивается к одному из полюсов:
  - annotation_type: process_reward
    name: step_rewards
    description: "Label each step as correct, neutral, or incorrect."
    steps_key: structured_turns
    step_text_key: content
    mode: per_step
    allow_neutral: true
Добавьте любую из схем в конфиг выше. Когда allow_neutral включён, неотмеченный шаг остаётся null, так что экспорт отличает осознанное нейтральное суждение от шага, до которого разметчик так и не дошёл. allow_neutral действует только в per_step и принудительно выключается в first_error, где для нейтрального суждения нет места.
Разметка ревью кода
Схема code_review переносит ревью пул-реквестов на вывод агентов. Разметчики кликают по строке диффа, чтобы прикрепить комментарий с категорией, оценивают каждый файл и выносят вердикт:
  - annotation_type: code_review
    name: review
    description: "Review the agent's code changes."
    comment_categories: [bug, style, suggestion, security]
    verdict_options: [approve, request_changes, comment_only]
    file_rating_dimensions: [correctness, quality]
Добавьте эту схему в конфиг выше. Каждое измерение оценки файла ставится по шкале от 1 до 5. Значения по умолчанию разумны для обычного ревью, поэтому переопределяйте их, когда ваша таксономия и есть предмет исследования, например при ревью безопасности, где bug и security должны быть отдельными категориями с отдельными определениями в инструкциях.
 Встроенные комментарии к диффу, оценки по файлам и общий вердикт
Руководство по ревью кода проводит через полное исследование с ревью, в том числе показывает, как категории комментариев влияют на то, что замечают разметчики. Прогоните это исследование на горстке трасс, прежде чем масштабировать его, потому что список категорий, выглядевший полным в конфиге, обычно пополняется ещё одним пунктом после первых двадцати ревью.
Полная конфигурация
Этот конфиг отрисовывает трассы и собирает вердикт на уровне задачи, процессные вознаграждения в режиме первой ошибки и ревью кода, с тремя разметчиками на каждую трассу, чтобы можно было измерить согласованность:
annotation_task_name: "Coding Agent Trace Evaluation"
task_description: "Judge whether the agent completed the task and review its changes."

data_files:
  - data/traces.jsonl

item_properties:
  id_key: id
  text_key: task_description

port: 8000
output_annotation_dir: annotation_output/coding-agent-eval/
export_annotation_format: jsonl

instance_display:
  layout:
    direction: vertical
    gap: 16px
  fields:
    - key: task_description
      type: text
      label: "Task"
    - key: structured_turns
      type: coding_trace
      label: "Agent Session"
      display_options:
        show_file_tree: true
        diff_view: unified
        collapse_long_outputs: true
        max_output_lines: 50
        terminal_theme: dark
        show_step_numbers: true

annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: success
        tooltip: "Completed correctly with no issues"
      - name: partial
        tooltip: "Completed with minor issues"
      - name: failure
        tooltip: "Not completed, or completed incorrectly"
    sequential_key_binding: true

  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent makes a mistake."
    steps_key: structured_turns
    mode: first_error

  - annotation_type: code_review
    name: review
    description: "Review the agent's code changes."
    comment_categories: [bug, style, suggestion, security]
    verdict_options: [approve, request_changes, comment_only]
    file_rating_dimensions: [correctness, quality]

  - annotation_type: text
    name: notes
    description: "Anything else worth recording about this trace"
    placeholder: "Optional"

num_annotators_per_item: 3

user_config:
  allow_all_users: false
  users:
    - annotator1
    - annotator2
Установите Potato, сконвертируйте трассы и запустите сервер:
pip install potato-annotation
python -m potato.trace_converter -i ./my_traces.json --auto-detect -o data/traces.jsonl
potato start config.yaml -p 8000
В репозитории есть рабочая версия этого проекта в examples/agent-traces/coding-agent-evaluation/, и это самый быстрый способ увидеть отображение, прежде чем конвертировать что-то своё. Запустите этот конфиг, прочитайте одну трассу так, как это сделал бы разметчик, и через несколько минут вы будете знать, совпадает ли гранулярность шагов, которую вы собираетесь размечать, с гранулярностью, которую показывает отображение.
Экспорт для обучения
Аннотации выводятся через экспортер для оценки кода, который пишет по одному файлу на каждый тип вывода:
python -m potato.export -c config.yaml -f coding_eval -o exports/ \
--option types=prm,preference,swebench,code_review| Тип | Файл | Для чего нужен |
|---|---|---|
prm | prm_training_data.jsonl | Обучение модели процессного вознаграждения |
preference | preference_pairs.jsonl | DPO или RLHF, из попарной разметки |
swebench | swebench_results.jsonl | Оценка, совместимая с SWE-bench |
code_review | code_reviews.jsonl | Структурированные данные ревью |
Типу preference для построения нужна попарная разметка, поэтому исследование, которое собирает только процессные вознаграждения, даёт остальные три. Решите, какие из четырёх вам нужны, до того как проектировать схемы, потому что добавить попарное сравнение задним числом значит разметить каждую трассу второй раз в паре с другой.
Наблюдение за работой агента
Записанные трассы составляют половину картины. live_coding_agent запускает агента прямо на странице разметки, где разметчики наблюдают за его работой, вмешиваются, откатывают изменения и перезапускают его с другими инструкциями, с бэкендом Ollama, Anthropic или Claude SDK в изолированном рабочем каталоге. Бэкенды и режимы песочницы описаны в документации по live coding agent.
Если ваша команда оценивает кодовых агентов и сталкивается с тем, что эта настройка не покрывает, откройте issue в репозитории на GitHub. Новый конвертер занимает примерно один файл в potato/trace_converter/converters/, так что формат, который Potato пока не читает, становится поводом для вклада, а не препятствием.