Edição de trajetórias para dados de treinamento SFT e DPO
Os anotadores reescrevem um passo errado do agente em vez de avaliá-lo, e o Potato exporta cada correção como alvos de SFT e pares de preferência de DPO.
A avaliação de agentes costuma terminar em um número. Um anotador lê uma trajetória, conclui que o passo três estava errado e registra uma nota baixa ou marca um tipo de erro. Esse número é útil para medir com que frequência o agente falha. É bem menos útil para corrigir o agente, porque "o passo três estava errado" não diz ao modelo o que o passo três deveria ter sido.
A próxima versão, o Potato 2.6, adiciona um esquema que pede a resposta em vez da nota. Com o trajectory_edit, os anotadores reescrevem os passos de um rastro de agente (consertando um passo de raciocínio malfeito, reparando uma chamada de ferramenta com erro de digitação ou reforçando uma resposta final fraca), e o Potato guarda a trajetória corrigida ao lado da original. Em seguida, o exportador trajectory_correction transforma cada par (original, corrected) em dados de treinamento: alvos de ajuste fino supervisionado e pares de preferência de otimização direta de preferências.
Isso transforma uma ferramenta de avaliação em uma ferramenta de produção de dados de treinamento: o tempo do anotador produz um sinal de aprendizado, e não um rótulo.
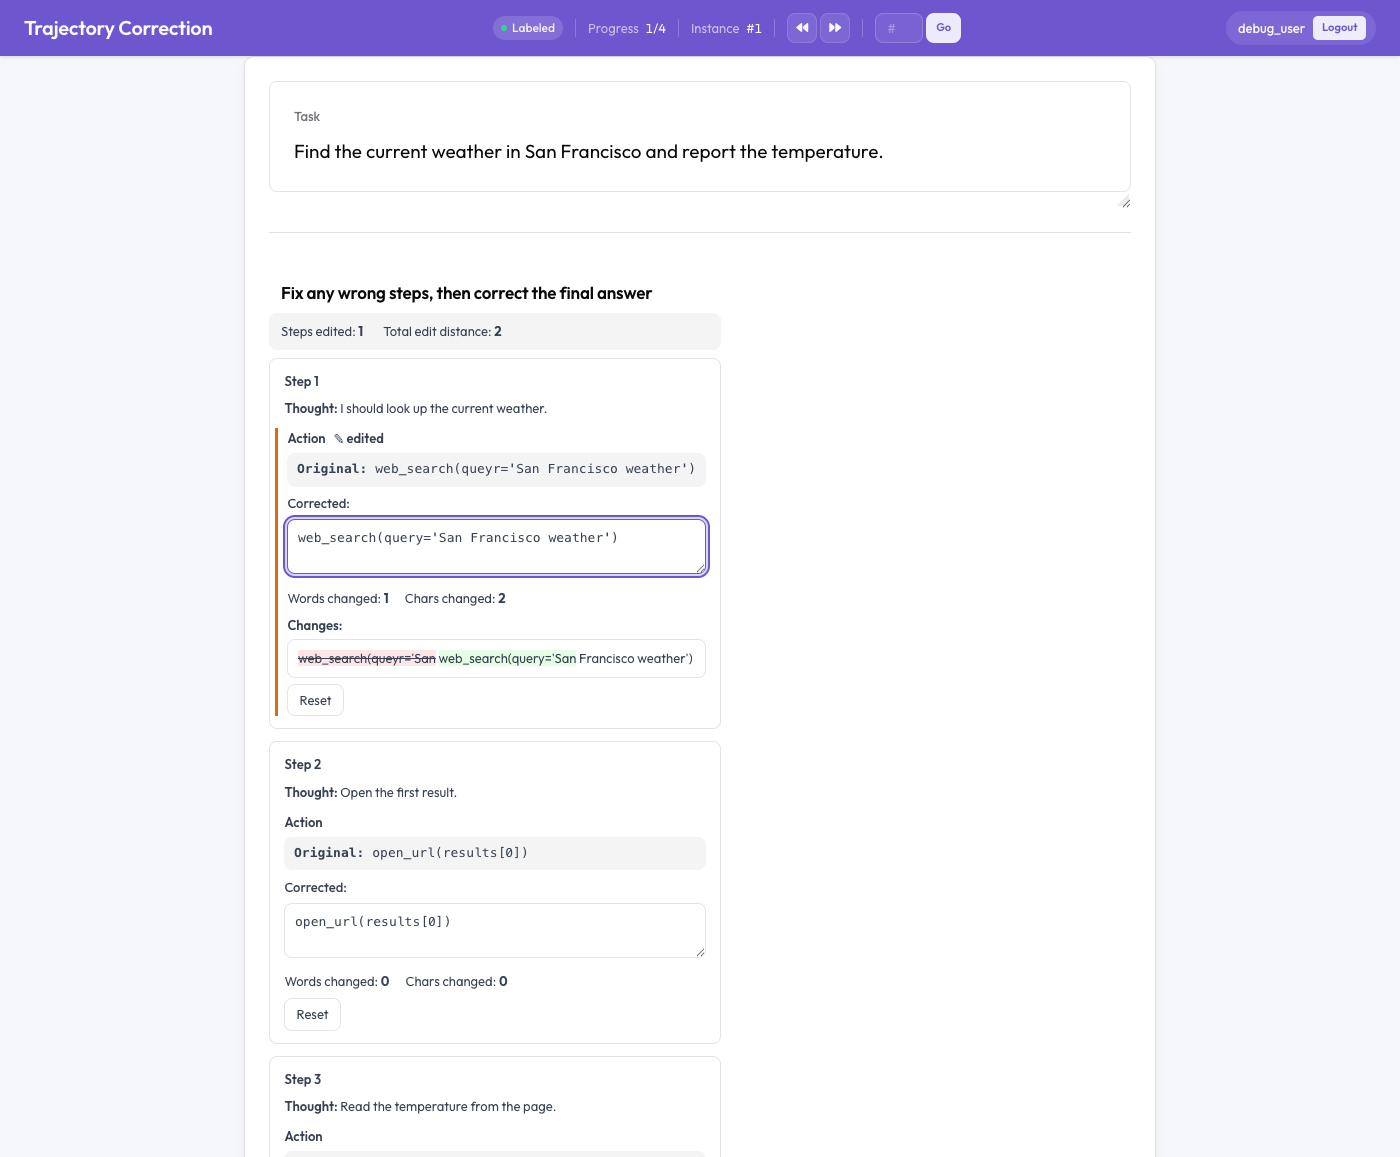 O editor de correção de trajetórias
Editar em vez de pontuar
Cada passo do agente aparece como um cartão com duas metades: o texto original, somente leitura, e uma caixa corrigida editável, pré-preenchida com o original. O anotador edita a caixa corrigida diretamente. Enquanto ele digita, três coisas acontecem:
- um diff ao vivo em nível de palavra destaca as inserções em verde e as exclusões em vermelho tachado,
- as palavras e os caracteres alterados são contados, e
- uma marca de "editado" aparece em todo campo que mudou.
Um botão "Redefinir" restaura o original de um campo se o anotador mudar de ideia. Nada é obrigatório. Um anotador que lê um rastro e o considera correto simplesmente o deixa como está, e um rastro não editado não produz nenhum par de treinamento. O sinal vem só de correções reais.
Configuração
O esquema aponta para a lista de passos nos seus dados e indica quais campos são editáveis:
annotation_schemes:
  - annotation_type: trajectory_edit
    name: corrected_trajectory
    description: "Fix any wrong steps, then correct the final answer"
    steps_key: steps          # instance field holding the step list
    step_text_key: action     # the default per-step editable field
    editable_fields:          # which fields get an editor
      - action
      # - thought             # add to also edit reasoning
    show_diff: true
    show_edit_distance: true
    allow_reset: true
    require_reason_on_edit: false   # add a per-field "reason" input
    edit_final_answer: true
    final_answer_key: final_answer
Por padrão, só a ação de cada passo é editável. Adicione thought a editable_fields quando quiser que os anotadores reparem o raciocínio do agente além das ações dele, e defina require_reason_on_edit: true quando quiser uma justificativa escrita associada a cada mudança, o que ajuda quando as próprias correções vão ser revisadas.
O formato dos dados é o que os seus rastros já têm. O esquema lê os passos do campo indicado por steps_key; cada passo é um objeto cujos campos podem ser editados:
{
  "id": "traj_001",
  "task_description": "Find the weather in San Francisco.",
  "steps": [
    {"thought": "Look it up.", "action": "web_search(queyr='SF weather')"},
    {"thought": "Open it.",    "action": "open_url(results[0])"}
  ],
  "final_answer": "It is sunny."
}
O erro de digitação em queyr é o tipo de coisa que um anotador conserta na caixa corrigida, produzindo uma correção de um único token com a qual o modelo pode aprender.
Rode o exemplo incluído a partir da raiz do repositório:
python potato/flask_server.py start examples/agent-traces/trajectory-correction/config.yaml -p 8000Das correções aos arquivos de treinamento
O exportador trajectory_correction grava três arquivos, cada um para um uso posterior diferente:
trajectory_corrections.jsoncontém o registro completo: ooriginal_trace, ocorrected_tracereconstruído e aseditspor campo, com distâncias de edição e justificativas. Esta é a sua trilha de auditoria.trajectory_sft.jsonltem uma linha por rastro editado,{"prompt": <task>, "completion": <corrected_trace>}. A trajetória corrigida vira o alvo que um modelo é ajustado para reproduzir.trajectory_dpo.jsonltem uma linha por rastro editado,{"prompt": <task>, "chosen": <corrected_trace>, "rejected": <original_trace>}. A edição humana define a preferência: a corrigida em vez da original.
 Como as edições viram dados de treinamento SFT e DPO
O arquivo DPO sai de graça. Em um pipeline comum de dados de preferência, você precisa gerar ou coletar uma resposta pior para parear com a melhor. Aqui a resposta pior já existe (é a trajetória original que o agente produziu), e a edição humana é a prova de que a versão corrigida é a preferida. Uma única anotação rende tanto um alvo de SFT quanto um par de DPO.
 Uma edição produz um par de preferência
O que fica de fora
Os rastros não editados são contados, mas excluídos dos arquivos SFT e DPO. Treinar com uma trajetória inalterada não ensina nada ao modelo e, pior, encheria um conjunto de dados de preferência com pares chosen == rejected que só acrescentam ruído. A contagem dos ignorados continua aparecendo nas estatísticas de exportação, então você pode ver quanto do lote já estava correto, o que por si só é um sinal útil sobre a qualidade do agente. Com vários anotadores, cada anotador que editou um determinado rastro gera um registro SFT/DPO, então todas as correções independentes contribuem.
Duas ressalvas
- O diff é em nível de palavra. Em chamadas de ferramenta com cara de código e sem espaços, um único token pode aparecer como totalmente alterado mesmo quando a correção é de um caractere. Nesses casos, o contador de distância em caracteres é o sinal preciso; confie nele, e não no diff visual, para chamadas de ferramenta densas.
- A edição combina naturalmente com a pontuação. Se você também quer rótulos de correção por passo ou uma taxonomia de erros no mesmo rastro, rode um esquema de pontuação em nível de passo junto com o editor, para que uma única passagem produza tanto o diagnóstico quanto a correção.
Onde isso entra no ciclo de ajuste
O ciclo de ajuste de agentes tem um gargalo na etapa do "o que ele deveria ter feito". As pontuações dizem onde um modelo falha, mas não produzem o comportamento corrigido para treinar, então as equipes acabam escrevendo correções sintéticas ou pagando por uma segunda rodada de rotulagem. A edição de trajetórias embute isso na própria avaliação: a mesma pessoa que teria pontuado o rastro o repara, e o reparo é o que é exportado.
A edição de trajetórias chega no Potato 2.6. Veja a documentação de edição de trajetórias para a lista completa de opções, a exibição eval_trace para ler rastros rapidamente antes de editar e a referência de formatos de exportação para os detalhes do exportador.