Potato vs. LangSmith e Langfuse para avaliação de agentes: uma comparação prática
Para que LangSmith, Langfuse e Potato foram feitos na avaliação de agentes, como mover traces entre eles e onde o julgamento humano é medido.
LangSmith e Langfuse foram feitos para rastrear e monitorar aplicações de LLM em produção. O Potato foi feito para coletar julgamentos humanos estruturados sobre o que esses traces mostram e para medir o quanto os avaliadores concordam. Equipes que precisam das duas coisas costumam capturar em uma ferramenta de observabilidade e conduzir o estudo humano no Potato.
As três ferramentas se sobrepõem o bastante para que a comparação apareça com frequência, e se sobrepõem em um único ponto. As três conseguem anexar um julgamento humano a uma execução registrada de um agente. Aquilo em torno de que cada uma se organiza é diferente, e essa diferença decide qual se encaixa na pergunta que você está fazendo.
Para que cada ferramenta foi feita
O LangSmith instrumenta, rastreia e depura aplicações de LLM, com a integração mais profunda com LangChain e LangGraph. Traces de uma aplicação construída sobre esses frameworks chegam sem instrumentação extra, e a plataforma se organiza em torno de inspecionar execuções, acompanhar latência e custo e rodar experimentos de avaliação sobre datasets. Suas filas de anotação suportam chaves de feedback com rubrica, um número configurável de revisores por execução, filas pareadas e revisores que não veem o feedback uns dos outros.
O Langfuse cobre o mesmo terreno como código aberto, para qualquer aplicação de LLM em vez de um único framework, e reúne o gerenciamento de prompts com o rastreamento. A pontuação está disponível no nível do trace e no nível da observação (span), e suas score configs categóricas permitem definir um conjunto fixo de rótulos e anexar várias pontuações nomeadas a um mesmo span.
O Potato é uma plataforma de anotação que foi estendida para traces de agentes. Ele se organiza em torno do estudo e não da aplicação, então suas primitivas são quem anota o quê, quantas pessoas veem cada item, o que acontece quando elas discordam e o que as estatísticas de concordância dizem sobre se os rótulos significam alguma coisa. Traces de agentes são um tipo de item entre os 61 tipos de anotação que a versão atual registra, e é por isso que herdam concordância entre anotadores, fases de treinamento, adjudicação e crowdsourcing sem que nada disso tenha sido reconstruído para agentes.
Nenhuma das três é melhor em abstrato. A pergunta útil é se o seu gargalo está em ver o que o agente fez ou em confiar nos rótulos humanos que você está coletando sobre isso.
Movendo traces entre elas
O Potato lê traces depois do fato em vez de instrumentar o seu código, por isso registra conversores para 15 formatos de trace:
python -m potato.trace_converter --list-formatsA lista inclui react, openai, anthropic, langchain, langfuse, multi_agent, mcp, otel, atif, webarena, web_agent, swebench, swe_agent_trajectory, claude_code e aider. Exportações de execuções do LangSmith passam pelo conversor langchain, já que não existe um langsmith separado. Logs do CrewAI, AutoGen e LangGraph passam por multi_agent.
Converter uma exportação é um único comando em cada direção do fluxo de trabalho:
# LangSmith runs, exported from LangSmith, converted for annotation
python -m potato.trace_converter \
  --input langsmith_export.jsonl \
  --output data/traces.jsonl \
  --input-format langchain

# Langfuse traces, exported from Langfuse
python -m potato.trace_converter \
  --input langfuse_traces.json \
  --output data/traces.jsonl \
  --input-format langfuse
Se o seu framework não está na lista, --auto-detect escolhe um conversor a partir das assinaturas dos campos, e um conversor novo é uma subclasse de BaseTraceConverter. A detecção pega o primeiro conversor que casa, então informe o formato explicitamente quando souber qual se encaixa nos seus arquivos.
Traces também podem chegar sem etapa de exportação. A ingestão de traces do Potato aceita execuções enviadas para /api/traces/* no formato de payload de execuções do LangSmith, então um callback do LangChain ou o SDK de rastreamento podem empurrar execuções para a fila de anotação à medida que acontecem:
trace_ingestion:
  enabled: true
  api_key: "your-api-key"
  notify_annotators: true
O que o Potato acrescenta depois que o trace entra
Os esquemas são onde uma plataforma de anotação justifica o seu lugar. trajectory_eval traz o rótulo de correção, uma taxonomia hierárquica de erros com subtipos, níveis de gravidade com pesos configuráveis e uma pontuação de qualidade acumulada, em um único esquema anexado a um único trace:
annotation_schemes:
  - annotation_type: trajectory_eval
    name: step_evaluation
    description: "Mark each step and classify anything that went wrong"
    steps_key: conversation
    step_text_key: text
    error_types:
      - name: execution
        subtypes: [wrong_tool, wrong_args, api_error]
    severities:
      - name: minor
        weight: -1
      - name: critical
        weight: -10
    show_score: true
Os pesos de gravidade são a parte que importa para comparar traces. Uma contagem simples de passos marcados diz que um agente cometeu quatro erros e outro cometeu dois, e a pontuação ponderada diz se esses quatro eram cosméticos e os dois, perigosos.
A avaliação comparativa passa pelo esquema pairwise, que tem três modos. O modo binário mostra dois blocos clicáveis com um botão de empate opcional, o modo de escala troca a escolha por um slider entre os dois itens, e o modo multi_dimension pede um veredito A/B independente para cada dimensão nomeada, como utilidade, precisão e segurança.
Agentes de programação têm sua própria exibição, porque um diff unificado lido como string JSON não dá para revisar:
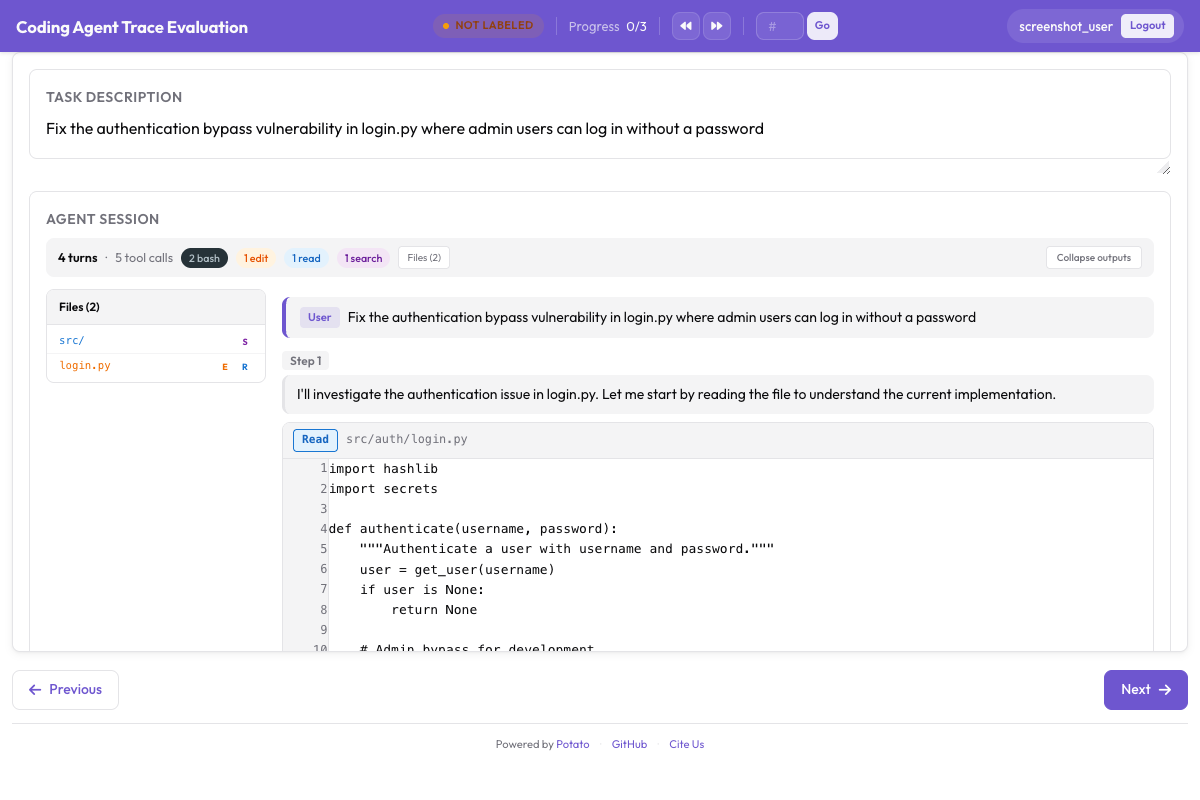 Exibição de traces de programação do Potato com renderização de diff unificado, realce de sintaxe e árvore de arquivos
A exibição coding_trace renderiza diffs com uma árvore de arquivos e recolhe saídas longas de terminal, e o esquema code_review coleta comentários ancorados em linhas em categorias configuráveis, dimensões de avaliação por arquivo e um veredito no estilo de pull request. O exportador coding_eval então grava rótulos para process reward models, anotações de revisão de código, pares de preferência para DPO e pontuações compatíveis com o SWE-bench, que é o formato de que os dados de treinamento precisam, e não o formato de que um dashboard precisa.
Traces de agentes web são renderizados como capturas de tela com sobreposições SVG das ações e uma filmstrip:
 Visualizador de traces de agentes web mostrando capturas de tela com sobreposições SVG das ações e navegação por filmstrip
Execuções multiagente têm suas próprias superfícies de anotação em vez de serem achatadas em um único fluxo de passos. O registro traz esquemas para um grafo de interação editável pelo anotador, atribuição de falhas entre agentes, revisão de passagens de tarefa, scorecards por agente e por equipe, disputa por ferramentas em uma linha do tempo compartilhada e marcação de comportamento emergente. O mesmo vale para agentes corporificados e multimodais, com trajetórias de uso de computador, interação por voz full-duplex e ancoragem temporal em vídeo como esquemas de primeira classe.
Medir os julgamentos, não só coletá-los
A diferença que aparece mais tarde em um projeto é o que acontece depois que dois anotadores discordam. O Potato trata uma discordância como uma medição e não como um conflito a ser resolvido, então as mesmas estatísticas de concordância, fila de adjudicação, fases de treinamento e itens de referência que um estudo de anotação de texto usa se aplicam a traces de agentes sem configuração extra. A própria comparação de ferramentas do Potato registra, na verificação de 2026-06-24, que as plataformas de rastreamento foram feitas para coletar julgamentos humanos como pontuações e que nenhuma delas documenta uma estatística de confiabilidade sobre esses julgamentos, e que o Langfuse substitui uma anotação anterior no mesmo trace, de modo que a anotação dupla independente ali exige um contorno.
Isso importa quando a avaliação é a evidência. Uma taxa de sucesso construída a partir de julgamentos únicos e não revisados não tem barra de erro, e um revisor que se desviou fica exatamente igual a um agente que melhorou.
Observando um agente enquanto ele roda
O Potato também pode rodar um agente dentro da página de anotação em vez de reproduzir uma gravação. O bloco live_agent conecta um modelo de visão a um navegador headless e transmite a sessão para o anotador, que pode pausá-la, enviar instruções ou assumir o controle manual:
live_agent:
  endpoint_type: anthropic_vision
  ai_config:
    model: claude-sonnet-4-20250514
    api_key: ${ANTHROPIC_API_KEY}
  max_steps: 30
  allow_takeover: true
  allow_instructions: true

instance_display:
  fields:
    - key: agent_trace
      type: live_agent
      label: "Live Agent Session"
      display_options:
        show_overlays: true
        show_filmstrip: true
Três situações fazem isso valer a configuração em comparação com a revisão posterior. Parar uma execução antes de uma ação destrutiva é uma medida de segurança que traces gravados não podem oferecer. Uma tomada de controle humana registrada no meio da execução vira dado de demonstração. E observar como um agente se recupera de uma intervenção responde a uma pergunta que nenhum trace concluído contém.
Usando as duas juntas
A configuração de produção comum usa as duas, e a divisão é limpa porque as ferramentas querem coisas diferentes. Instrumente o agente com LangSmith ou Langfuse e deixe cada execução ser rastreada. Amostre as execuções que merecem uma opinião humana, que costumam ser as falhas, os casos de borda e uma amostra de controle aleatória. Converta-as para o Potato, rode o estudo de anotação com vários anotadores por trace e leia o relatório de concordância junto com as pontuações. Leve as contagens da taxonomia de erros de volta para o desenvolvimento, onde a distribuição de subtipos diz se você tem uma falha sistemática ou uma cauda longa.
python -m potato.trace_converter \
  --input langfuse_failed_traces.json \
  --output data/traces_to_review.jsonl \
  --input-format langfuse

potato start config.yaml -p 8000
Como escolher
Use o LangSmith quando a aplicação é construída sobre LangChain ou LangGraph e a necessidade é visibilidade em produção, já que os traces chegam sem trabalho de instrumentação e o serviço gerenciado elimina a questão da infraestrutura. Use o Langfuse quando você quer essa mesma visibilidade em código aberto com vários provedores, com versionamento de prompts na mesma ferramenta. Use o Potato quando o resultado de que você precisa é um conjunto defensável de rótulos humanos, quando o estudo precisa de vários anotadores por item e de um número de concordância, quando os agentes são de programação, multiagente ou corporificados a ponto de o trace precisar de uma exibição feita sob medida, ou quando os dados precisam ficar na sua própria infraestrutura. O Potato é GPL-3.0-or-later e auto-hospedado, sem custo por assento ou por trace.
As afirmações sobre LangSmith e Langfuse aqui refletem a documentação deles como observada em 2026-06-24, e os dois lançam mudanças rápido. Correções são bem-vindas no repositório do GitHub. Para a configuração em si, veja o guia de avaliação de agentes, e para um exemplo completo que vai dos traces brutos aos julgamentos exportados, veja Avaliando agentes de IA.