Tarefas de comparação e preferência de imagens
Monte no Potato uma tarefa de comparação de imagens com duas imagens lado a lado, um esquema de preferência, ordem de apresentação aleatória e um ranqueamento para conjuntos maiores.
Este tutorial monta no Potato uma tarefa de comparação de imagens com duas imagens geradas lado a lado, uma escala de preferência de cinco pontos, perguntas complementares por critério e as variantes de ranqueamento e Best-Worst Scaling para conjuntos com mais de duas imagens. A mesma construção serve para dados de preferência de RLHF, comparações de compressão e de melhoria de imagem e testes A/B de design.
Uma comparação pede ao anotador que escolha entre duas imagens em vez de posicionar uma imagem numa escala, o que dispensa que todos os anotadores compartilhem uma calibração do que significa um 4 de 5. O custo é que um conjunto de n imagens exige muito mais julgamentos para chegar a uma ordenação completa, e é disso que tratam as seções finais sobre ranqueamento e Best-Worst Scaling.
O arquivo de dados
Cada linha traz um identificador, os caminhos das duas imagens e o contexto de que o anotador precisa para julgá-las. O Potato lê os nomes dos campos em item_properties, então os nomes em si ficam a seu critério:
{"id": "pair_001", "prompt": "A sunset over mountains", "image_a": "/media/model_a_001.png", "image_b": "/media/model_b_001.png"}
{"id": "pair_002", "prompt": "A cat on a windowsill", "image_a": "/media/model_a_002.png", "image_b": "/media/model_b_002.png"}
Mostrando duas imagens lado a lado
No Potato, o conteúdo e as perguntas são configurados separadamente. O bloco instance_display define o que o anotador vê, e annotation_schemes define o que ele deve responder. Dois campos image com layout horizontal colocam as imagens uma ao lado da outra, e zoomable permite que o anotador examine artefatos invisíveis no tamanho de exibição:
instance_display:
  layout:
    direction: horizontal
    gap: 24px
  fields:
    - key: image_a
      type: image
      label: "Image A"
      display_options:
        max_height: 512
        zoomable: true
        alt_text: "First generated image"
    - key: image_b
      type: image
      label: "Image B"
      display_options:
        max_height: 512
        zoomable: true
        alt_text: "Second generated image"
Veja o que o anotador enxerga depois que a exibição e o esquema estão configurados:
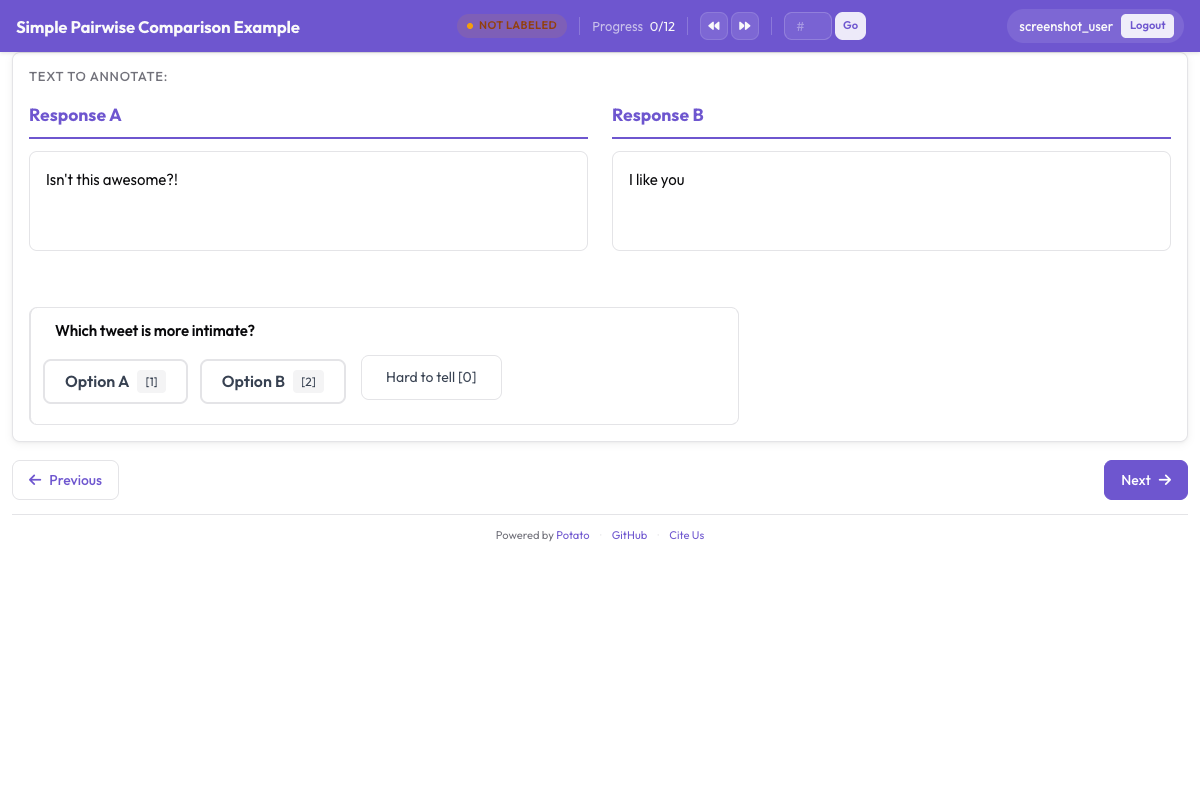 Uma tarefa de comparação mostrando os dois candidatos com a pergunta de preferência abaixo deles
A pergunta de preferência
Uma escala de cinco pontos separa uma preferência forte de uma fraca, o que importa quando você treina com o resultado, porque um par em que os anotadores se dividiram igualmente carrega um sinal de treino diferente de um que todos julgaram com clareza. sequential_key_binding atribui às cinco opções as teclas de 1 a 5, e essa é a diferença entre uma comparação que leva quatro segundos e uma que leva doze.
annotation_schemes:
  - annotation_type: radio
    name: preference
    description: "Which image better matches the prompt?"
    labels:
      - name: "A is clearly better"
      - name: "A is slightly better"
      - name: "About equal"
      - name: "B is slightly better"
      - name: "B is clearly better"
    sequential_key_binding: true
    label_requirement:
      required: true
Adicione este bloco à configuração acima. Faça a opção do meio dizer "About equal" e não "No preference", porque as duas descrevem julgamentos diferentes e os anotadores usam uma opção "no preference" como botão de pular.
Viés de posição
Os anotadores escolhem a opção da esquerda com mais frequência do que deveriam, então o lado em que cada imagem aparece precisa variar. Faça essa aleatorização ao montar o arquivo de dados, trocando image_a e image_b numa metade aleatória das linhas e registrando a orientação de cada linha, e depois desfaça a troca nos julgamentos registrados antes de analisá-los. Os campos de exibição do Potato são renderizados na ordem em que você os lista, então a configuração não consegue fazer isso por você.
Comparações de texto são diferentes. O esquema pairwise tira seus dois candidatos de um único campo dos dados do item, então randomize_order pode permutá-los, e o Potato registra a ordem que cada anotador de fato viu. A semente é derivada do anotador, do item e do esquema em conjunto, e é isso que faz a preferência de uma pessoa pela primeira posição recair sobre candidatos diferentes de um item para outro, em vez de se correlacionar com um único lado durante todo o estudo. Consulte a documentação de comparação par a par quando o que está sendo comparado é texto.
Perguntando sobre critérios específicos
Uma preferência geral diz qual imagem venceu e nada sobre o porquê. Acrescentar duas ou três perguntas específicas abaixo dela torna as divergências interpretáveis, já que anotadores que discordam no julgamento geral muitas vezes concordam sobre a aderência ao prompt e discordam sobre a estética.
  - annotation_type: radio
    name: prompt_adherence
    description: "Which image better matches the prompt?"
    labels:
      - name: A
      - name: Tie
      - name: B

  - annotation_type: multiselect
    name: issues_a
    description: "Problems in Image A (select all that apply)"
    labels:
      - name: "Distorted faces or hands"
      - name: "Text rendering errors"
      - name: "Unnatural lighting"
      - name: "Missing elements from the prompt"
      - name: "Blurry or low quality"
      - name: "None"
Adicione esses esquemas ao bloco acima. Mantenha curta a lista de critérios. Cada pergunta extra se multiplica pelo estudo inteiro, e um formulário com cinco critérios em 2000 pares dá 10000 julgamentos, cada um precisando de sua própria definição nas instruções.
Comparação antes e depois
Tarefas de melhoria, restauração e edição usam a mesma construção com duas imagens, com os lados nomeados em vez de aleatorizados, porque saber qual lado é o original faz parte da pergunta:
instance_display:
  layout:
    direction: horizontal
    gap: 24px
  fields:
    - key: original
      type: image
      label: "Original"
      display_options:
        max_height: 512
        zoomable: true
    - key: enhanced
      type: image
      label: "Enhanced"
      display_options:
        max_height: 512
        zoomable: true

annotation_schemes:
  - annotation_type: radio
    name: enhancement_quality
    description: "How did the edit change the image?"
    labels:
      - name: "Clearly improved"
      - name: "Slightly improved"
      - name: "No noticeable change"
      - name: "Made worse"
    label_requirement:
      required: true

  - annotation_type: multiselect
    name: problems_introduced
    description: "Problems the edit introduced (select all that apply)"
    labels:
      - name: "Over-sharpening or halos"
      - name: "Color shift"
      - name: "Loss of detail"
      - name: "New artifacts"
      - name: "None"
Pergunte sobre os problemas introduzidos separadamente da qualidade geral. Uma edição que deixa o objeto principal mais nítido e acrescenta halos em volta dele aparece como melhoria numa escala única, e os halos são justamente o que você precisa saber.
Mais de duas imagens
Para três a oito candidatos por item, mostre-os num campo gallery e colete uma ordenação completa com o esquema ranking. A galeria recebe uma lista de caminhos de imagem de um único campo, então o arquivo de dados guarda um array em vez de duas chaves separadas:
item_properties:
  id_key: id
  text_key: prompt

instance_display:
  fields:
    - key: prompt
      type: text
      label: "Prompt"
    - key: images
      type: gallery
      display_options:
        layout: grid
        columns: 2
        thumbnail_size: 320
        zoomable: true

annotation_schemes:
  - annotation_type: ranking
    name: preference_rank
    description: "Drag the image numbers to rank them from best at the top to worst at the bottom."
    labels:
      - "Image 1"
      - "Image 2"
      - "Image 3"
      - "Image 4"
    allow_ties: false
    label_requirement:
      required: true
As labels nomeiam as posições na galeria, então a lista precisa ter uma entrada por imagem e todos os itens precisam ter o mesmo número de candidatos. O ranqueamento funciona bem para conjuntos pequenos, já que o anotador compara cada candidato com todos os outros ao mesmo tempo. Acima de uns oito candidatos, o esforço por item cresce mais rápido do que a informação que você recebe de volta.
Conjuntos maiores
Best-Worst Scaling é a opção quando o conjunto é grande demais para ser ranqueado numa só tela. Os anotadores veem uma tupla de itens, geralmente quatro, e escolhem apenas o melhor e o pior, e as pontuações são calculadas ao longo de muitas tuplas sobrepostas:
  - annotation_type: bws
    name: quality
    description: "Select the BEST and the WORST image in this set."
    tuple_size: 4
    best_description: "Best"
    worst_description: "Worst"
Adicione este esquema à configuração acima. A pontuação é calculada depois da coleta, pela aba BWS do painel de administração ou pela linha de comando, e grava bws_scores.tsv no diretório de saída:
python -m potato.bws_scoring --config config.yaml --method bradley_terryO método counting não exige dependências adicionais e é a linha de base transparente. bradley_terry ajusta um modelo sobre as comparações par a par implícitas e exige pip install choix. plackett_luce modela diretamente cada escolha de melhor e de pior e não precisa de nada além do próprio Potato. A documentação de Best-Worst Scaling cobre a geração de tuplas, que precisa acontecer antes de tudo isso.
Instruções e verificações de atenção
Diga nas instruções o que "melhor" significa nesta tarefa, porque do contrário os anotadores usam a própria definição e você só descobre isso na etapa de concordância. annotation_instructions coloca o texto em todas as páginas de anotação:
annotation_instructions: |
  Judge each pair on how well it matches the prompt first, then on visual
  quality, then on how appealing it looks. Zoom in before deciding: hands,
  text, and fine texture are where generation failures show up. Mark "About
  equal" only when you have looked at both and cannot separate them.
Numa tarefa de comparação, as verificações de atenção são pares com um vencedor óbvio, misturados à fila a partir de um arquivo próprio para ficarem fora do seu conjunto de dados:
attention_checks:
  enabled: true
  items_file: "data/attention_checks.json"
  frequency: 20
  min_response_time: 3.0
  failure_handling:
    warn_threshold: 2
    block_threshold: 5
Adicione os dois blocos à configuração acima. min_response_time detecta a falha à qual uma tarefa de comparação está mais exposta, que é um anotador clicando num ritmo que não deixa tempo para olhar a segunda imagem.
A configuração completa
Esta configuração executa uma coleta de preferências para RLHF com duas saídas de modelo por item, uma preferência de cinco pontos, uma pergunta de critério e uma avaliação de confiança. Três anotadores veem cada par, o que basta para relatar a concordância e tirar um rótulo por maioria.
annotation_task_name: "Generative Model Comparison"
task_description: "Compare two generated images against the prompt that produced them."

data_files:
  - data/model_outputs.json

item_properties:
  id_key: id
  text_key: prompt

instance_display:
  layout:
    direction: horizontal
    gap: 24px
  fields:
    - key: image_a
      type: image
      label: "Image A"
      display_options:
        max_height: 512
        zoomable: true
        alt_text: "First generated image"
    - key: image_b
      type: image
      label: "Image B"
      display_options:
        max_height: 512
        zoomable: true
        alt_text: "Second generated image"

annotation_instructions: |
  Judge each pair on prompt match first, then visual quality, then appeal.
  Zoom in before deciding. Mark "About equal" only when you cannot separate them.

annotation_schemes:
  - annotation_type: radio
    name: preference
    description: "Which image better represents the prompt?"
    labels:
      - name: "A is clearly better"
      - name: "A is slightly better"
      - name: "About equal"
      - name: "B is slightly better"
      - name: "B is clearly better"
    sequential_key_binding: true
    label_requirement:
      required: true

  - annotation_type: radio
    name: prompt_adherence
    description: "Which image matches the prompt more closely?"
    labels:
      - name: A
      - name: Tie
      - name: B

  - annotation_type: likert
    name: confidence
    description: "How confident are you in this judgment?"
    size: 5
    min_label: "Guessing"
    max_label: "Certain"

attention_checks:
  enabled: true
  items_file: "data/attention_checks.json"
  frequency: 20
  min_response_time: 3.0
  failure_handling:
    warn_threshold: 2
    block_threshold: 5

num_annotators_per_item: 3
output_annotation_dir: annotation_output/image-comparison/
export_annotation_format: jsonl
Inicie com potato start config.yaml -p 8000, abra a porta num navegador e faça login para conferir se o par é renderizado como você espera antes de mandar o link para alguém. Anote também alguns itens você mesmo, porque um esquema que parece claro na configuração muitas vezes se revela ambíguo no terceiro par real.
O que a saída contém
O Potato grava arquivos por anotador em output_annotation_dir, e export_annotation_format acrescenta uma exportação periódica em <output_annotation_dir>/exports/<format>/. Cada registro exportado identifica a instância, o anotador e o rótulo escolhido para cada esquema:
{"instance_id": "pair_001", "user_id": "rater_01", "labels": {"preference": {"A is slightly better": "A is slightly better"}, "confidence": {"4": "4"}}, "spans": {}, "links": {}}Junte isso de volta ao seu arquivo de dados por instance_id para recuperar qual modelo produziu cada lado, e desfaça a troca esquerda-direita aplicada ao montar o arquivo antes de agregar qualquer coisa. Deixar esse passo para o fim, em vez de fazê-lo na configuração de anotação, é o que preserva o registro bruto do que cada anotador de fato viu.
Próximos passos
- Colete dados de preferência em escala com o Prolific
- Meça a concordância entre anotadores no resultado
- Leia a documentação de comparação par a par para comparações de texto, e a documentação do código-fonte do Potato para a referência do esquema