Avaliando agentes de IA: anotação humana de traces de agentes
Como configurar no Potato a avaliação humana da saída de agentes de IA, da importação de traces e do design de esquemas por trace e por passo até a análise dos resultados exportados.
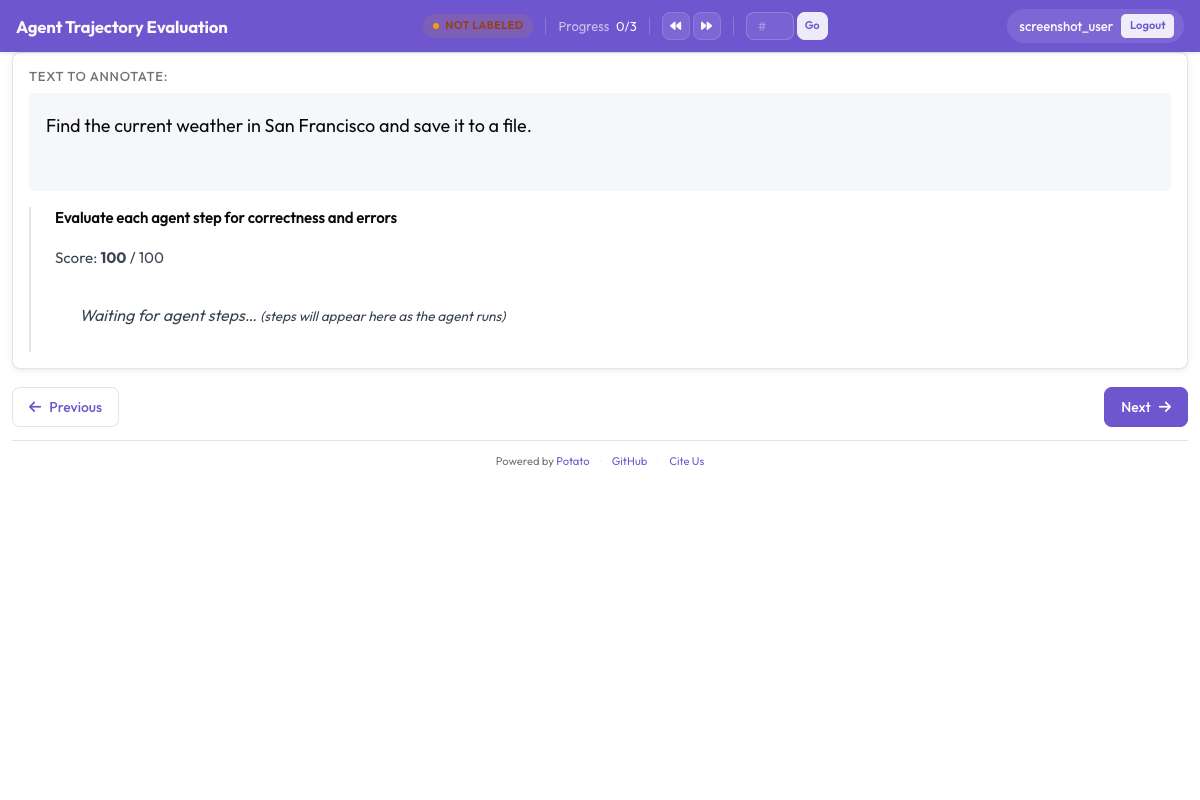
Converta traces de agentes com python -m potato.trace_converter, exiba-os por meio de um campo de exibição agent_trace e colete um veredito no nível do trace junto com um julgamento trajectory_eval por passo. O julgamento por passo é a parte que localiza o passo em que a execução deu errado.
Uma taxa de sucesso diz com que frequência um agente termina a tarefa e nada sobre por que as falhas falharam. Dois agentes com a mesma taxa de sucesso de 62% podem estar falhando por motivos completamente diferentes, um escolhendo a ferramenta errada e o outro raciocinando corretamente sobre uma recuperação ruim, e a correção é diferente em cada caso. A avaliação humana no nível do passo separa os dois, porque o anotador marca qual passo quebrou e que tipo de quebra foi.
 Dos traces brutos a julgamentos estruturados
Este guia monta o pipeline para um agente no estilo ReAct que responde perguntas pesquisando na web. As configurações foram verificadas com o Potato 2.9.1:
pip install --upgrade potato-annotationPasso 1: converter os traces
O Potato registra 15 conversores de traces, e a CLI os lista com suas descrições:
python -m potato.trace_converter --list-formatsA lista inclui react, openai, anthropic, langchain, langfuse, multi_agent, mcp, otel, atif, webarena, web_agent, swebench, swe_agent_trajectory, claude_code e aider. Exportações de execuções do LangSmith passam pelo langchain, e logs do CrewAI, do AutoGen e do LangGraph passam pelo multi_agent.
O conversor react lê um trace cujos passos trazem as chaves thought, action e observation:
{
  "id": "trace_001",
  "task": "What is the capital of Australia and what is its population?",
  "steps": [
    {"thought": "I need the capital of Australia and then its population.",
     "action": "search('capital of Australia')",
     "observation": "Canberra is the capital city of Australia."},
    {"thought": "Now I need Canberra's population.",
     "action": "search('Canberra population 2025')",
     "observation": "Canberra has a population of approximately 467,000 as of 2025."},
    {"thought": "I have both pieces of information.",
     "action": "finish('Canberra, approximately 467,000')"}
  ],
  "metadata": {"agent": "GPT-4", "tokens": 2340}
}
Um único comando converte o arquivo:
python -m potato.trace_converter \
  --input raw_traces.json \
  --input-format react \
  --output data/traces.jsonl
Passe --auto-detect no lugar de --input-format quando não tiver certeza de qual conversor serve, e o registro escolhe um a partir das assinaturas dos campos. Informe o formato explicitamente assim que souber qual é, porque a detecção pega o primeiro conversor que corresponde e vários formatos se sobrepõem nos campos que carregam.
Todo conversor escreve a mesma forma canônica, e é isso que faz uma mesma configuração funcionar com diferentes frameworks. Cada linha traz id, task_description e conversation, uma lista de turnos com um speaker e um text. Um conversor que tenha esses dados também escreve agent_name, metadata_table e screenshots:
{
  "id": "trace_001",
  "task_description": "What is the capital of Australia and what is its population?",
  "agent_name": "GPT-4",
  "metadata_table": [{"Property": "Steps", "Value": "3"},
                     {"Property": "tokens", "Value": "2340"}],
  "conversation": [
    {"speaker": "Agent (Thought)", "text": "I need the capital of Australia and then its population."},
    {"speaker": "Agent (Action)", "text": "search('capital of Australia')"},
    {"speaker": "Environment", "text": "Canberra is the capital city of Australia."}
  ]
}
Passo 2: exibir o trace
A exibição agent_trace mostra cada turno como um cartão, com cores por tipo de passo, para que o anotador leia a execução e não um bloco de JSON:
instance_display decide o que aparece na página e em que ordem. A descrição da tarefa fica no topo porque o anotador precisa saber o que foi pedido ao agente antes que qualquer passo signifique algo, e a tabela de metadados fica logo abaixo, em um campo compacto de planilha:
instance_display:
  layout:
    direction: vertical
    gap: 16px

  fields:
    - key: task_description
      type: text
      label: "Task"

    - key: metadata_table
      type: spreadsheet
      label: "Trace Info"
      display_options:
        compact: true
        max_height: 120

    - key: conversation
      type: agent_trace
      label: "Agent Trace"
      span_target: true
      display_options:
        show_step_numbers: true
        show_summary: true
        collapse_observations: true
        step_type_colors:
          thought: "#e8f4fd"
          action: "#fff3e0"
          observation: "#e8f5e9"
Recolher as observações impede que resultados de busca longos empurrem o resto do trace para fora da tela, já que um trace com uma dúzia de resultados de busca completos é quase só rolagem, e o anotador perde a noção de em que ponto da execução está. Definir span_target: true no mesmo campo permite que um esquema de spans marque as palavras exatas de uma afirmação alucinada dentro de um turno, um registro mais fino do que marcar o passo inteiro como errado.
Passo 3: o julgamento no nível do trace
Três perguntas cobrem o trace como um todo. O sucesso da tarefa é o número principal, a correção da resposta separa uma resposta certa obtida de forma ruim de uma resposta errada, e a eficiência é o que distingue dois agentes que ambos têm sucesso:
annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: "Success"
        tooltip: "Fully completed correctly"
      - name: "Partial success"
        tooltip: "Completed with errors or omissions"
      - name: "Failure"
        tooltip: "Not completed"
    label_requirement:
      required: true
    sequential_key_binding: true

  - annotation_type: radio
    name: answer_correctness
    description: "Is the agent's final answer factually correct?"
    labels:
      - name: "Correct"
      - name: "Partially correct"
      - name: "Incorrect"
      - name: "Cannot determine"
    label_requirement:
      required: true

  - annotation_type: likert
    name: efficiency
    description: "Did the agent reach the answer without wasted steps?"
    size: 5
    min_label: "Many unnecessary steps"
    max_label: "No wasted steps"

  - annotation_type: text
    name: evaluator_notes
    description: "Anything the ratings above do not capture"
    multiline: true
    rows: 3
"Cannot determine" merece seu lugar. Sem essa opção, um anotador que não tem como verificar a resposta ou chuta ou a marca como incorreta, e as duas escolhas colocam ruído no número que mais importa para você.
Passo 4: o julgamento por passo
trajectory_eval mostra cada passo como um cartão com seus próprios controles, e reúne o rótulo de correção, a taxonomia de erros e a gravidade em um único esquema em vez de três. Aponte steps_key para o campo que contém os passos, que em um trace convertido é conversation, e step_text_key para a chave dentro de cada passo que deve ser exibida:
annotation_schemes:
  - annotation_type: trajectory_eval
    name: step_evaluation
    description: "Mark each step and classify anything that went wrong"
    steps_key: conversation
    step_text_key: text
    correctness_options:
      - correct
      - partially_correct
      - incorrect
      - unnecessary
    error_types:
      - name: reasoning
        subtypes:
          - logical_error
          - factual_error
          - planning_error
      - name: execution
        subtypes:
          - wrong_tool
          - wrong_args
          - api_error
      - name: termination
        subtypes:
          - premature_stop
          - redundant_step
    severities:
      - name: minor
        weight: -1
      - name: major
        weight: -5
      - name: critical
        weight: -10
    show_score: true
    max_score: 100
Os pesos de gravidade transformam uma lista de passos marcados em um único número comparável por trace, e vale a pena mudar os valores padrão em vez de aceitá-los. Um peso diz quanto um erro crítico é pior do que um erro menor para a sua tarefa, e em uma avaliação de segurança essa proporção é muito mais acentuada do que em uma tarefa de busca.
Manter unnecessary separado de incorrect é a outra decisão que vale tomar de forma deliberada. Um passo desperdiçado custa tokens e tempo sem introduzir um erro, e juntar os dois esconde a diferença entre um agente que fica dando voltas e um que está errado.
Passo 5: a configuração completa
Tudo o que foi visto acima, em um único arquivo:
annotation_task_name: "ReAct Agent Evaluation"
task_dir: "."
output_annotation_dir: "output/"

data_files:
  - "data/traces.jsonl"

item_properties:
  id_key: id
  text_key: task_description

instance_display:
  layout:
    direction: vertical
    gap: 16px
  fields:
    - key: task_description
      type: text
      label: "Task"
    - key: metadata_table
      type: spreadsheet
      label: "Trace Info"
      display_options:
        compact: true
        max_height: 120
    - key: conversation
      type: agent_trace
      label: "Agent Trace"
      span_target: true
      display_options:
        show_step_numbers: true
        show_summary: true
        collapse_observations: true

annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: "Success"
      - name: "Partial success"
      - name: "Failure"
    label_requirement:
      required: true
    sequential_key_binding: true

  - annotation_type: radio
    name: answer_correctness
    description: "Is the agent's final answer factually correct?"
    labels:
      - name: "Correct"
      - name: "Partially correct"
      - name: "Incorrect"
      - name: "Cannot determine"
    label_requirement:
      required: true

  - annotation_type: likert
    name: efficiency
    description: "Did the agent reach the answer without wasted steps?"
    size: 5
    min_label: "Many unnecessary steps"
    max_label: "No wasted steps"

  - annotation_type: text
    name: evaluator_notes
    description: "Anything the ratings above do not capture"
    multiline: true
    rows: 3

  - annotation_type: trajectory_eval
    name: step_evaluation
    description: "Mark each step and classify anything that went wrong"
    steps_key: conversation
    step_text_key: text
    correctness_options: [correct, partially_correct, incorrect, unnecessary]
    error_types:
      - name: reasoning
        subtypes: [logical_error, factual_error, planning_error]
      - name: execution
        subtypes: [wrong_tool, wrong_args, api_error]
      - name: termination
        subtypes: [premature_stop, redundant_step]
    severities:
      - name: minor
        weight: -1
      - name: major
        weight: -5
      - name: critical
        weight: -10
    show_score: true
    max_score: 100

export_annotation_format: jsonl
Inicie o servidor e abra http://localhost:8000:
potato start config.yaml -p 8000Como é a sessão de anotação
A página mostra a tarefa, a tabela de informações do trace e os cartões de passo, com os controles por passo ligados a cada cartão e os esquemas no nível do trace abaixo do trace. A ordem em que os anotadores trabalham importa mais do que parece. Avaliar primeiro os passos e depois o trace mantém o veredito geral ancorado no que a execução de fato fez, enquanto avaliar o sucesso primeiro tende a influenciar cada julgamento de passo que vem depois.
Vale a pena escrever três hábitos nas instruções para os anotadores. Expandir as observações recolhidas em vez de confiar na linha de resumo, já que um resultado de busca mal lido é a fonte mais comum de uma resposta errada que parece bem raciocinada. Conferir a resposta final com o ground truth antes de avaliar o sucesso da tarefa, quando o dataset tiver um. Usar a linha do tempo dos passos para voltar a um passo quando um passo posterior revelar que o anterior já estava errado.
Passo 6: exportar e analisar
O exportador JSONL escreve annotations.jsonl, com um registro por instância e anotador:
python -m potato.export --config config.yaml --format jsonl --output ./export/Cada registro traz instance_id, user_id, labels, spans e links, e as respostas dos esquemas ficam em labels, indexadas pelo nome do esquema:
import json
import pandas as pd

records = [json.loads(line) for line in open("export/annotations.jsonl")]

df = pd.DataFrame([
    {"trace": r["instance_id"], "annotator": r["user_id"], **r["labels"]}
    for r in records
])

print(df["task_success"].value_counts())
Para qualquer coisa acima de algumas centenas de traces, exporte para Parquet e consulte o arquivo diretamente. A exportação Parquet escreve annotations.parquet com instance_id, user_id e uma coluna por esquema de anotação, de modo que o nome do esquema é uma coluna e não um valor:
python -m potato.export --config config.yaml --format parquet --output ./export/import duckdb
print(duckdb.sql("""
SELECT task_success, COUNT(*) AS n
FROM 'export/annotations.parquet'
GROUP BY task_success
ORDER BY n DESC
"""))Os julgamentos no nível do passo são os que vale ler primeiro. Contar os subtipos de erro ao longo dos traces diz se o agente tem uma falha sistemática ou uma cauda longa de falhas sem relação entre si, e só o primeiro caso vale uma correção direcionada.
Passo 7: mais anotadores e uma fase de qualificação
A avaliação de agentes é subjetiva o bastante para que uma única avaliação por trace seja uma medida sem barra de erro. Três anotadores por trace dão um número de concordância, e a atribuição aleatória evita que a sobreposição se concentre nos traces que por acaso estão no início do arquivo:
num_annotators_per_item: 3
assignment_strategy: random
Uma fase de qualificação identifica os anotadores que não entenderam a taxonomia de erros antes que eles passem um dia aplicando-a de forma inconsistente. O bloco de treinamento os mantém em traces com resposta conhecida até que sejam aprovados:
training:
  enabled: true
  data_file: "data/training_traces.jsonl"
  passing_criteria:
    min_correct: 4
  allow_retry: true
  failure_action: "repeat_training"
Outros frameworks de agentes
A exibição e os esquemas continuam os mesmos entre frameworks, e só o conversor muda. Traces do OpenAI Chat Completions e mensagens da Anthropic com blocos tool_use têm cada um seu próprio conversor, e logs multiagente do CrewAI, do AutoGen e do LangGraph compartilham um:
python -m potato.trace_converter --input runs.json --input-format openai --output data/traces.jsonl
python -m potato.trace_converter --input runs.json --input-format anthropic --output data/traces.jsonl
python -m potato.trace_converter --input runs.json --input-format multi_agent --output data/traces.jsonl
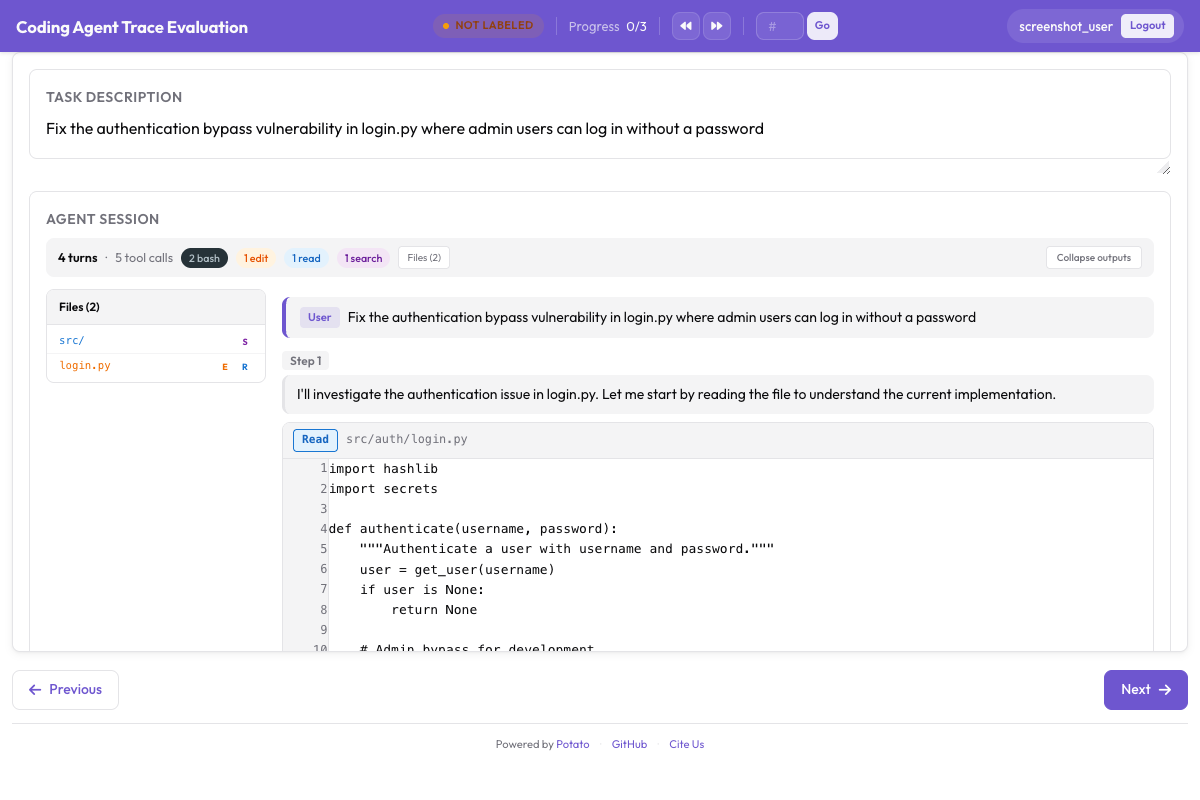
Agentes de programação precisam de outra exibição, porque um diff lido como string JSON não dá para revisar. A exibição coding_trace mostra diffs unificados com uma árvore de arquivos e recolhe saídas longas do terminal:
instance_display:
  fields:
    - key: structured_turns
      type: coding_trace
      label: "Agent Session"
      display_options:
        show_file_tree: true
        diff_view: unified
        collapse_long_outputs: true
        max_output_lines: 50
Agentes de navegação web precisam das capturas de tela, das sobreposições de ações e de uma tira de quadros para percorrê-las:
instance_display:
  fields:
    - key: steps
      type: web_agent_trace
      label: "Agent Browsing Trace"
      display_options:
        show_overlays: true
        show_filmstrip: true
        show_thought: true
        screenshot_max_width: 900
Anotando Agentes de Navegação Web cobre o formato das sobreposições e o modo de criação que grava novos traces.
Para os detalhes de implementação por trás de tudo isso, veja o guia de avaliação de agentes e a documentação de traces de agentes. Se você está montando sua primeira avaliação, converta dez traces, rode a configuração acima e anote-os você mesmo antes de escrever as diretrizes, já que a taxonomia de erros de que você precisa em geral não é a que você teria escrito de antemão.
Leitura adicional
- Documentação de Anotação Agêntica
- Anotando Agentes de Navegação Web
- Modo Solo, para combinar anotação agêntica com avaliação colaborativa entre humanos e LLMs
- Best-Worst Scaling, para classificar saídas de agentes de forma comparativa
- Exportação para Parquet, para análise em larga escala