Anotação de Agentes de Programação: Avaliando Traces do Claude Code, Aider e SWE-Agent
O Potato renderiza traces de agentes de programação como diffs e blocos de terminal, com schemas de recompensa por processo e revisão de código e conversores para Claude Code, Aider e SWE-Agent.
O Potato agora anota sessões de agentes de programação diretamente. Um trace é renderizado como diffs unificados, blocos de terminal escuros, leituras de arquivo com números de linha e uma árvore de todos os arquivos que o agente tocou. Há três conversores para formatos de agentes de programação (claude_code, aider e swe_agent_trajectory), ao lado dos outros doze formatos de trace que o Potato já lê, e dois schemas de anotação feitos para esses dados: process_reward para a correção no nível do passo e code_review para uma revisão dos diffs no estilo do GitHub.
A execução de um agente de programação é uma longa trajetória de leituras de arquivo, edições, comandos de terminal e raciocínio. Uma interface de anotação de texto simples achata tudo isso em uma parede de caracteres, e é por isso que as equipes que avaliam agentes costumam escrever sua própria interface de revisão e acabam com conjuntos de dados que mais ninguém consegue usar. Para a referência completa, consulte a documentação de anotação de agentes de programação e o guia de avaliação de agentes.
Duas Coisas a Verificar Antes de Planejar um Estudo
As transcrições do Claude Code não contêm o texto de raciocínio do modelo. Os arquivos mantêm o bloco thinking e sua assinatura e descartam o conteúdo. Medimos 6393 blocos em 40 sessões locais, e nenhum deles tinha texto. O trace convertido informa a contagem, para que a lacuna fique visível em vez de silenciosa. Se os anotadores precisam do raciocínio para julgar os passos, capture-o ao vivo com claude -p --output-format stream-json ou com o Agent SDK, em vez de lê-lo de volta do disco.
As transcrições também trazem caminhos absolutos, nomes de branch, detalhes do ambiente e qualquer código-fonte que a sessão tenha lido. Anonimize antes de compartilhar um conjunto de dados e obtenha o consentimento das pessoas a quem as sessões pertencem.
A Exibição do Trace
Traces de programação são renderizados pelo tipo de exibição coding_trace, declarado em instance_display junto com o que mais o anotador precisar ver. O Potato separa o que é exibido do que é perguntado, então a mesma exibição de trace funciona com qualquer schema de anotação:
instance_display:
  layout:
    direction: vertical
    gap: 16px
  fields:
    - key: task_description
      type: text
      label: "Task"
    - key: structured_turns
      type: coding_trace
      label: "Agent Session"
      display_options:
        show_file_tree: true
        diff_view: unified
        collapse_long_outputs: true
        max_output_lines: 50
        terminal_theme: dark
        show_step_numbers: true
        show_reasoning: true
Cada chamada de ferramenta é renderizada de acordo com o que a ferramenta fez, então o anotador lê um diff como diff, e não como texto escapado:
| Ferramenta | Renderização |
|---|---|
Read | Bloco de código com números de linha |
Edit, Replace | Diff unificado com linhas vermelhas e verdes |
Write, Create | Bloco de código de arquivo novo, todo verde |
Bash, Terminal, Shell | Bloco de terminal escuro com um prompt $ |
Grep, Glob, Search, Find | Bloco de código com os resultados da busca |
| Qualquer outra | Entrada e saída formatadas em JSON |
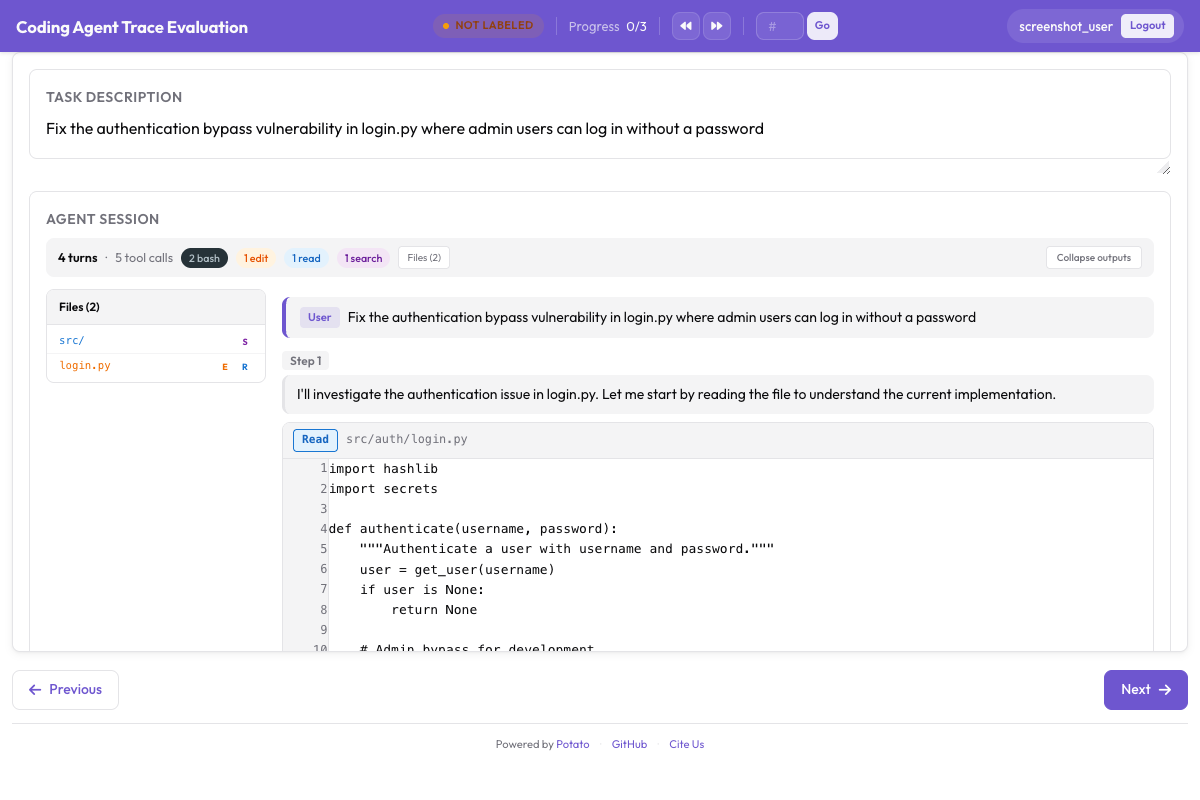 Um trace de programação com diffs unificados, saída de terminal e a barra lateral com a árvore de arquivos
collapse_long_outputs com max_output_lines: 50 é a configuração que decide se um trace é legível. Uma única execução do pytest pode imprimir várias centenas de linhas, e um anotador que precisa rolar por isso a cada passo para de ler os passos.
O Formato dos Dados
O formato structured_turns mantém a estrutura das chamadas de ferramenta de que a exibição precisa. Cada turno traz um papel, o conteúdo em texto e uma lista de chamadas de ferramenta:
{
  "id": "session_001",
  "task_description": "Fix the authentication bypass in login.py",
  "model": "claude-sonnet-4-20250514",
  "structured_turns": [
    {
      "role": "assistant",
      "content": "I'll investigate the auth issue.",
      "tool_calls": [
        {
          "tool": "Read",
          "input": {"file_path": "src/auth/login.py"},
          "output": "def login(user, password):\n    if user.role == 'admin':\n        return True",
          "output_type": "code",
          "language": "python"
        },
        {
          "tool": "Bash",
          "input": {"command": "pytest tests/test_auth.py -v"},
          "output": "4 passed",
          "output_type": "terminal"
        }
      ]
    }
  ]
}
output_type aceita code, diff, terminal ou generic, e o Potato o infere a partir da ferramenta e da extensão do arquivo quando você o omite. Defina-o explicitamente quando a saída de uma ferramenta não for o que o nome dela sugere.
Convertendo os Traces Que Você Já Tem
O conversor lê um formato e grava o JSONL que o Potato carrega. Três dos seus formatos são de agentes de programação:
# Claude Code, or any Anthropic Messages API transcript
python -m potato.trace_converter -i traces.json -f claude_code -o data/traces.jsonl

# Aider chat history with SEARCH/REPLACE blocks
python -m potato.trace_converter -i chat.md -f aider -o data/traces.jsonl

# SWE-Agent trajectories
python -m potato.trace_converter -i trajectory.json -f swe_agent_trajectory -o data/traces.jsonl

# Mixed directory, format detected per file
python -m potato.trace_converter -i traces.json --auto-detect -o data/traces.jsonl
O conversor claude_code lê tanto as transcrições de sessão do próprio Claude Code quanto o formato bruto da Messages API. O Claude Code grava um arquivo JSONL por sessão em ~/.claude/projects/<slugified-working-directory>/<session-id>.jsonl, e o conversor transforma uma sessão em um único trace, em vez de um por linha:
python -m potato.trace_converter \
  -i ~/.claude/projects/-home-me-myrepo/3c853f0f-....jsonl \
  --auto-detect -o data/session.jsonl
Ele segue a cadeia parentUuid e mantém apenas o caminho sobrevivente, então tentativas rebobinadas são descartadas e contadas em vez de anotadas como se tivessem acontecido. Mensagens de sidechain vão para sidechain_runs, fora dos turnos principais. Comandos de barra são descartados, já que ali é a CLI falando consigo mesma. O formato em disco pertence à CLI e não a uma API publicada, então trate o leitor como best-effort entre atualizações. Ele ignora tipos de registro que não conhece e lança um erro, em vez de devolver um trace vazio, quando um arquivo deixa de ser interpretável.
Anotação de Recompensa por Processo
Um modelo de recompensa por processo atribui crédito passo a passo em vez de pontuar apenas o resultado final, e process_reward coleta os rótulos com que ele é treinado. Dois modos equilibram velocidade e detalhe.
No modo first_error, o padrão, o anotador clica no primeiro passo em que o agente errou. Todo passo anterior é marcado como correto, e esse passo e todos os seguintes são marcados como incorretos. Um clique rotula a trajetória inteira, e é por isso que esse é o modo a usar quando você precisa de volume.
annotation_schemes:
  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent makes a mistake."
    steps_key: structured_turns
    mode: first_error
No modo per_step, cada passo é julgado isoladamente. Isso custa mais tempo dos anotadores e produz o sinal que first_error não consegue produzir, porque uma cascata supõe que um erro é irrecuperável, e agentes reais se recuperam. Ative allow_neutral junto e os rótulos seguem a convenção do PRM800K de +1, 0 e -1, em que um passo genuinamente inofensivo é registrado como neutro em vez de ser empurrado para um dos polos:
  - annotation_type: process_reward
    name: step_rewards
    description: "Label each step as correct, neutral, or incorrect."
    steps_key: structured_turns
    step_text_key: content
    mode: per_step
    allow_neutral: true
Adicione qualquer um dos schemas à configuração acima. Com allow_neutral ativado, um passo não marcado fica null, então a exportação distingue um julgamento neutro deliberado de um passo ao qual o anotador nunca chegou. allow_neutral vale apenas para per_step e é desativado à força em first_error, que não tem lugar para um julgamento neutro.
Anotação de Revisão de Código
O schema code_review traz a revisão de pull requests para a saída de agentes. Os anotadores clicam em uma linha do diff para anexar um comentário categorizado, avaliam cada arquivo e dão um veredicto:
  - annotation_type: code_review
    name: review
    description: "Review the agent's code changes."
    comment_categories: [bug, style, suggestion, security]
    verdict_options: [approve, request_changes, comment_only]
    file_rating_dimensions: [correctness, quality]
Adicione este schema à configuração acima. As dimensões de avaliação de arquivo recebem notas de 1 a 5 cada uma. Os padrões funcionam bem para trabalho de revisão geral, então substitua-os quando a sua taxonomia for o objetivo do estudo, como em uma revisão de segurança em que bug e security precisam ser categorias separadas, com definições separadas nas instruções.
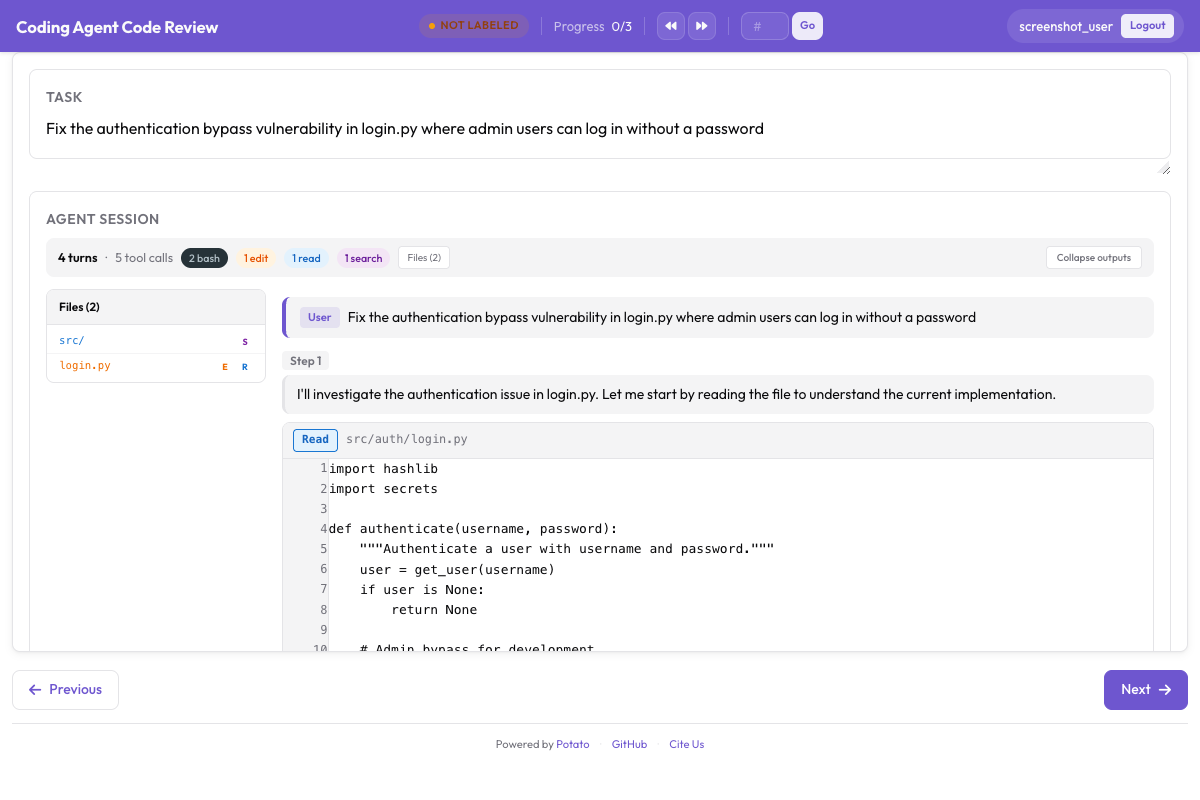 Comentários inline nos diffs, avaliações por arquivo e o veredicto geral
O tutorial de revisão de código percorre um estudo de revisão completo, incluindo como as categorias de comentário moldam o que os anotadores percebem. Rode esse estudo em um punhado de traces antes de escalá-lo, porque uma lista de categorias que parecia completa na configuração costuma ganhar mais uma entrada depois das primeiras vinte revisões.
Uma Configuração Completa
Esta configuração renderiza traces e coleta um veredicto no nível da tarefa, recompensas por processo no modo de primeiro erro e uma revisão de código, com três anotadores em cada trace para que a concordância possa ser medida:
annotation_task_name: "Coding Agent Trace Evaluation"
task_description: "Judge whether the agent completed the task and review its changes."

data_files:
  - data/traces.jsonl

item_properties:
  id_key: id
  text_key: task_description

port: 8000
output_annotation_dir: annotation_output/coding-agent-eval/
export_annotation_format: jsonl

instance_display:
  layout:
    direction: vertical
    gap: 16px
  fields:
    - key: task_description
      type: text
      label: "Task"
    - key: structured_turns
      type: coding_trace
      label: "Agent Session"
      display_options:
        show_file_tree: true
        diff_view: unified
        collapse_long_outputs: true
        max_output_lines: 50
        terminal_theme: dark
        show_step_numbers: true

annotation_schemes:
  - annotation_type: radio
    name: task_success
    description: "Did the agent complete the task?"
    labels:
      - name: success
        tooltip: "Completed correctly with no issues"
      - name: partial
        tooltip: "Completed with minor issues"
      - name: failure
        tooltip: "Not completed, or completed incorrectly"
    sequential_key_binding: true

  - annotation_type: process_reward
    name: step_rewards
    description: "Click the first step where the agent makes a mistake."
    steps_key: structured_turns
    mode: first_error

  - annotation_type: code_review
    name: review
    description: "Review the agent's code changes."
    comment_categories: [bug, style, suggestion, security]
    verdict_options: [approve, request_changes, comment_only]
    file_rating_dimensions: [correctness, quality]

  - annotation_type: text
    name: notes
    description: "Anything else worth recording about this trace"
    placeholder: "Optional"

num_annotators_per_item: 3

user_config:
  allow_all_users: false
  users:
    - annotator1
    - annotator2
Instale o Potato, converta seus traces e inicie o servidor:
pip install potato-annotation
python -m potato.trace_converter -i ./my_traces.json --auto-detect -o data/traces.jsonl
potato start config.yaml -p 8000
O repositório inclui uma versão funcional deste projeto em examples/agent-traces/coding-agent-evaluation/, que é o jeito mais rápido de ver a exibição antes de converter qualquer coisa sua. Inicie essa configuração, leia um trace como um anotador leria, e em poucos minutos você vai saber se a granularidade de passos que pretende rotular é a granularidade que a exibição mostra.
Exportando para Treinamento
As anotações saem pelo exportador de avaliação de código, que grava um arquivo por tipo de saída:
python -m potato.export -c config.yaml -f coding_eval -o exports/ \
--option types=prm,preference,swebench,code_review| Tipo | Arquivo | O que alimenta |
|---|---|---|
prm | prm_training_data.jsonl | Treinamento de modelos de recompensa por processo |
preference | preference_pairs.jsonl | DPO ou RLHF, a partir de anotações pareadas |
swebench | swebench_results.jsonl | Avaliação compatível com SWE-bench |
code_review | code_reviews.jsonl | Dados estruturados de revisão |
O tipo preference precisa de anotações pareadas como base, então um estudo que só coleta recompensas por processo produz os outros três. Decida quais dos quatro você quer antes de projetar os schemas, já que adicionar uma comparação pareada depois significa anotar cada trace uma segunda vez contra um par.
Observando um Agente Trabalhar
Traces gravados são metade do quadro. live_coding_agent executa um agente dentro da página de anotação, onde os anotadores o veem trabalhar, intervêm, revertem e repetem a execução com instruções diferentes, com um backend Ollama, Anthropic ou Claude SDK em um diretório de trabalho isolado. A documentação do agente de programação ao vivo cobre os backends e os modos de sandbox.
Se a sua equipe está avaliando agentes de programação e encontra algo que esta configuração não cobre, abra uma issue no repositório do GitHub. Um novo conversor é mais ou menos um arquivo em potato/trace_converter/converters/, então um formato que o Potato ainda não lê é uma contribuição a fazer, e não um bloqueio.