Construindo sua primeira tarefa de anotação NER
Guia passo a passo para construir uma tarefa de reconhecimento de entidades nomeadas no Potato, com configuração de anotação de spans, cores de rótulos, spans sobrepostos, atalhos de teclado e exportação CoNLL.
Este tutorial constrói no Potato uma tarefa de reconhecimento de entidades nomeadas (NER) com cinco tipos de entidade, atalhos nas teclas numéricas, instruções para os anotadores e uma exportação CoNLL-2003 para treinar modelos. Para as opções de configuração de spans por trás dela, consulte a documentação de anotação de spans.
O que o anotador recebe
A tarefa pronta mostra ao anotador uma frase com uma fileira de botões rotulados acima dela. O anotador arrasta o cursor sobre um trecho para selecioná-lo, pressiona uma tecla numérica ou clica em um botão para rotulá-lo, e clica de novo em um span rotulado para alterá-lo ou removê-lo. Cada span é armazenado com seus offsets de caracteres, então o mesmo arquivo de anotações alimenta tanto uma exportação CoNLL-2003 quanto um cálculo de concordância no nível do span.
Pré-requisitos
Você precisa do Potato instalado, de um arquivo de dados de texto e de YAML suficiente para editar uma configuração:
pip install potato-annotationPasso 1: O esquema de span
A anotação de spans é o tipo span do Potato. Cada rótulo precisa de um nome, e os campos opcionais úteis são color, que separa visualmente os tipos de entidade em textos densos, key_value, que associa um atalho de teclado ao rótulo, e tooltip, que mostra a definição do rótulo ao passar o mouse, para que os anotadores não precisem sair da página para consultar o codebook.
Cinco tipos mantêm a tarefa aprendível em uma única sessão. Acima de uns oito, os anotadores começam a consultar as diretrizes a cada item, e é aí que o ritmo cai. sequential_key_binding ativa as teclas numéricas, e key_value fixa qual número corresponde a qual rótulo, em vez de deixar isso para a ordem da lista. Crie config.yaml:
annotation_task_name: "Named Entity Recognition"
task_dir: "."

data_files:
  - data/sentences.json

item_properties:
  id_key: id
  text_key: text

output_annotation_dir: "annotation_output/"
export_annotation_format: "jsonl"

annotation_schemes:
  - annotation_type: span
    name: entities
    description: "Highlight and label named entities in the text"
    sequential_key_binding: true
    labels:
      - name: PER
        tooltip: "Person names, including fictional characters"
        color: "#FF6B6B"
        key_value: "1"
      - name: ORG
        tooltip: "Companies, institutions, agencies"
        color: "#4ECDC4"
        key_value: "2"
      - name: LOC
        tooltip: "Places, including countries, cities, landmarks"
        color: "#45B7D1"
        key_value: "3"
      - name: DATE
        tooltip: "Dates, times, and temporal expressions"
        color: "#96CEB4"
        key_value: "4"
      - name: MISC
        tooltip: "Named entities that fit none of the above"
        color: "#FFEAA7"
        key_value: "5"

user_config:
  allow_all_users: true
Passo 2: O arquivo de dados
O Potato lê um objeto JSON por linha e usa os campos indicados em item_properties. Crie data/sentences.json:
{"id": "1", "text": "Apple Inc. announced that CEO Tim Cook will visit Paris next Tuesday."}
{"id": "2", "text": "The United Nations headquarters in New York hosted delegates from Japan."}
{"id": "3", "text": "Dr. Sarah Johnson published her research at Stanford University in March 2024."}
Três frases bastam para verificar se a interface funciona. Carregue o corpus real quando o conjunto de rótulos tiver sobrevivido a um piloto.
Passo 3: Instruções ao alcance do anotador
A maior parte das divergências em NER vem das regras de fronteira, e não dos próprios tipos de entidade, então as regras que decidem mais itens devem ficar na tela de anotação. annotation_instructions é exibido como um painel recolhível no topo de cada item, aberto por padrão, que os anotadores recolhem quando já estão familiarizados com a tarefa. Adicione este bloco à configuração acima:
annotation_instructions: |
  ## Entity types

  - **PER** covers people, including fictional characters ("John Smith", "Dr. Johnson", "Batman")
  - **ORG** covers companies, institutions, and agencies ("Apple Inc.", "United Nations", "Stanford University")
  - **LOC** covers places, including countries, cities, and landmarks ("Paris", "New York", "Mount Everest")
  - **DATE** covers dates, times, and temporal expressions ("Tuesday", "March 2024", "next week")
  - **MISC** covers named entities that fit none of the above ("Nobel Prize", "iPhone", "COVID-19")

  ## Boundary rules

  1. Include titles (Dr., Mr.) with person names.
  2. For nested entities, annotate the largest meaningful span.
  3. Leave articles (the, a) outside the span.
O Markdown é renderizado aqui, então o mesmo texto pode ser aproveitado do seu codebook sem ser reescrito em HTML. Limite este painel às regras que resolvem a maioria dos itens e coloque o codebook completo em annotation_codebook_url, que abre em uma aba própria.
A interface de spans então mostra os rótulos como botões acima do texto:
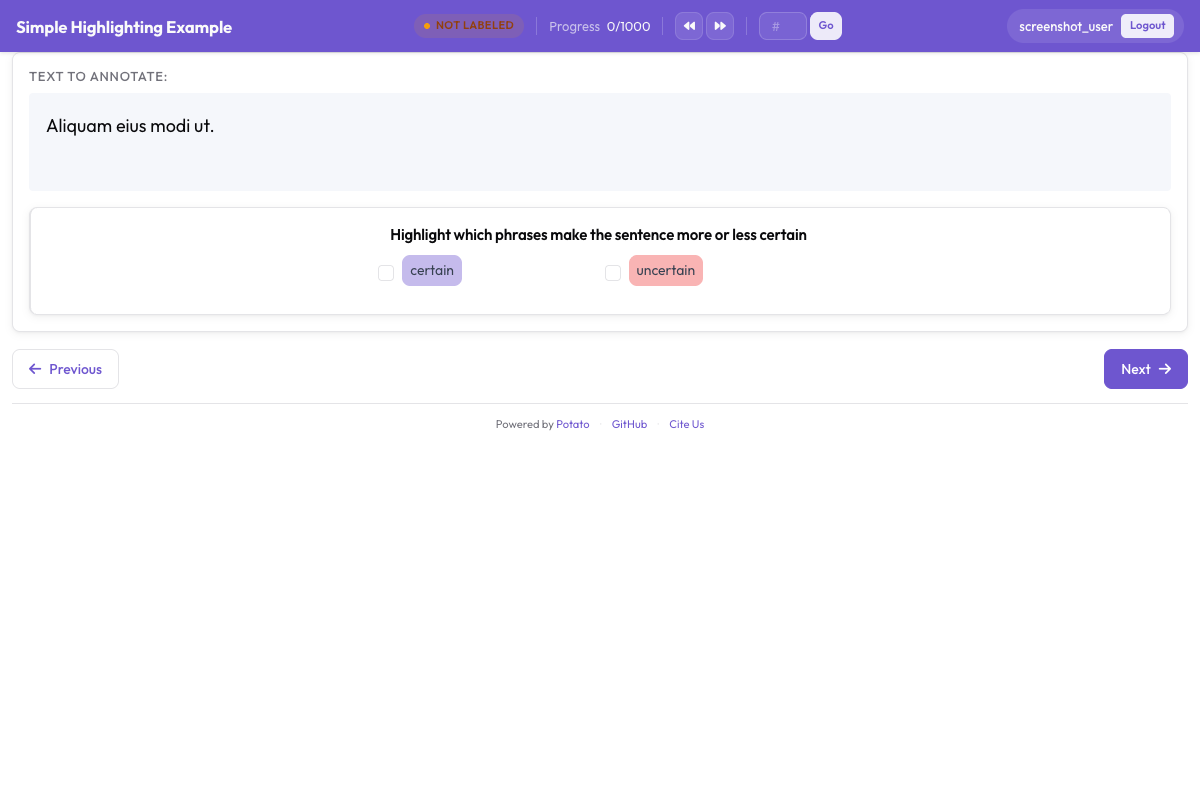 Os anotadores destacam spans de texto e atribuem rótulos de entidade como PER, ORG, LOC e DATE
Passo 4: Execute a tarefa
Inicie o servidor com a configuração do Passo 1:
potato start config.yamlAbra o endereço que ele exibe e faça login. O anotador então executa quatro ações para cada entidade:
- Selecione o texto. Clique e arraste sobre o trecho.
- Atribua o tipo. Pressione a tecla numérica ou clique no botão do rótulo.
- Corrija um erro. Clique em um span existente para alterar seu rótulo ou removê-lo.
- Envie. Passe para o próximo item quando terminar a frase.
Passo 5: O que o arquivo de saída contém
Cada item anotado é gravado em annotation_output/ como um objeto JSON, com o nome do esquema como chave e uma entrada por span:
{
  "id": "1",
  "text": "Apple Inc. announced that CEO Tim Cook will visit Paris next Tuesday.",
  "entities": [
    {"start": 0, "end": 10, "label": "ORG", "text": "Apple Inc."},
    {"start": 30, "end": 38, "label": "PER", "text": "Tim Cook"},
    {"start": 50, "end": 55, "label": "LOC", "text": "Paris"},
    {"start": 61, "end": 73, "label": "DATE", "text": "next Tuesday"}
  ]
}
São os offsets de caracteres que tornam o arquivo útil nas etapas seguintes. Eles sobrevivem a mudanças de tokenização, então as mesmas anotações podem ser realinhadas a qualquer tokenizador que seu modelo use.
Passo 6: Exporte para CoNLL-2003
Modelos de rotulagem de sequências leem tokens com tags em vez de offsets de caracteres, então o Potato converte os spans na exportação:
python -m potato.export -c config.yaml -f conll_2003 -o ./conll_export/O resultado é um token por linha com sua tag, com linhas em branco entre as frases. A opção tag_scheme grava BIO, BIOES ou IOB, com BIO como padrão, então ajuste-a ao que seu código de treinamento espera antes de executar a exportação.
Refinando as diretrizes
Regras vagas produzem decisões divididas sobre o mesmo span, então vale a pena revisá-las enquanto o piloto ainda é pequeno. Conduza os anotadores pelos casos difíceis antes de começarem, e não depois, e mantenha uma lista compartilhada dos casos limítrofes já resolvidos à medida que surgirem. A queda na concordância entre anotadores é o sinal de que uma regra precisa ser ajustada, e é mais barato perceber isso em 50 itens do que em 5000.
Próximos passos
- Adicione uma fase de treinamento para preparar os anotadores antes que eles trabalhem com itens reais
- Configure múltiplos anotadores para que os spans possam ser comparados
- Exporte para o formato Hugging Face para treinar modelos
- Leia a documentação de anotação de spans para a lista completa de opções